Memilih Model: Regression
Pada materi sebelumnya kita telah mempelajari cara memilih estimator untuk masalah machine learning.
Kita juga telah mencoba Ridge Regression pada dataset California Housing.
Namun, bagaimana jika performa model yang kita gunakan belum sesuai dengan kebutuhan?
Salah satu langkah yang dapat dilakukan adalah mencoba algoritma atau model lain.
Pada materi ini kita akan mengenal konsep Ensemble Learning dan mencoba salah satu algoritma ensemble yang populer, yaitu Random Forest Regressor.
Mengapa Mencoba Model Lain?
Dalam machine learning, tidak ada satu algoritma yang selalu memberikan performa terbaik untuk semua jenis dataset.
Misalnya kita menggunakan:
from sklearn.linear_model import Ridge

model = Ridge()
model.fit(X_train, y_train)

score = model.score(X_test, y_test)
Setelah melakukan evaluasi, kita mendapatkan suatu nilai R².
Jika performanya belum memenuhi kebutuhan proyek, kita dapat melakukan eksperimen dengan model lain.
Contohnya:
Ridge
  ↓
Evaluasi
  ↓
Performa belum sesuai
  ↓
Coba model lain
  ↓
Random Forest
  ↓
Evaluasi kembali
Proses seperti ini merupakan bagian penting dari eksperimentasi machine learning.
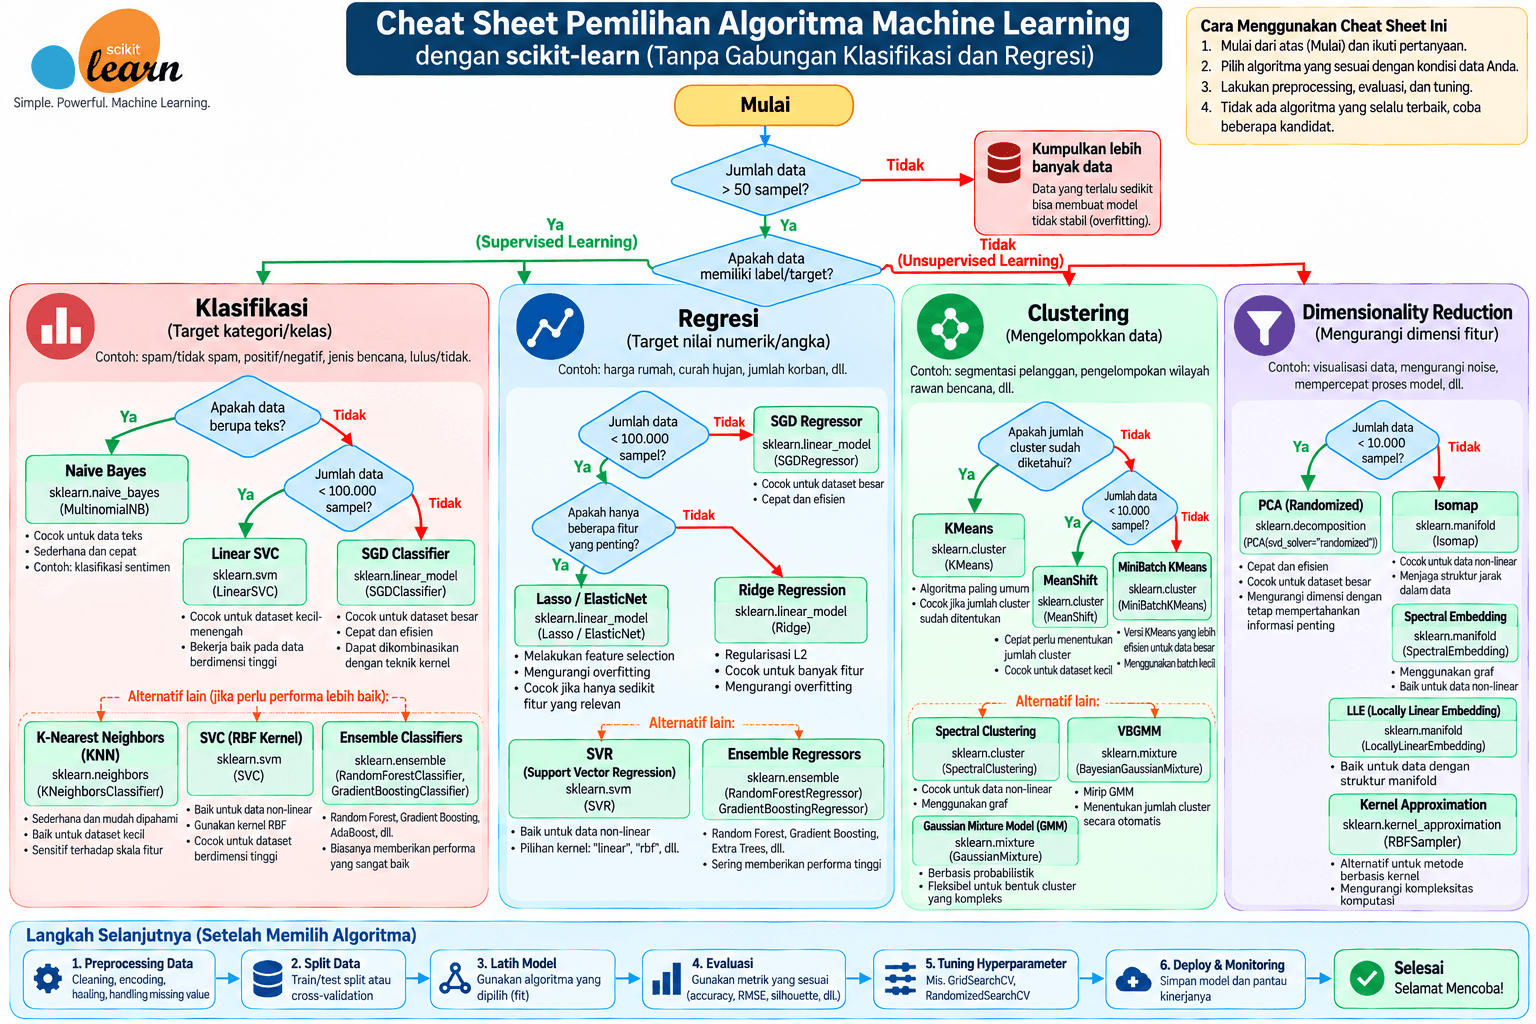
Baca juga: https://scikit-learn.org/stable/machine_learning_map.html
Jangan Terpaku pada Satu Algoritma
Kesalahan yang sering dilakukan oleh pemula adalah menganggap bahwa setelah memilih satu algoritma, kita harus terus menggunakan algoritma tersebut.
Padahal, machine learning biasanya melibatkan proses:
Data
 ↓
Preprocessing
 ↓
Pilih model
 ↓
Training
 ↓
Evaluasi
 ↓
Eksperimen
 ↓
Bandingkan
 ↓
Tuning
 ↓
Evaluasi kembali
Tujuannya bukan sekadar mencari model yang paling kompleks.
Tujuannya adalah menemukan pendekatan yang memberikan performa yang sesuai dengan kebutuhan masalah, data, dan batasan sistem.
Apa Itu Ensemble Learning?
Ensemble Learning adalah pendekatan machine learning yang menggabungkan beberapa model atau estimator untuk menghasilkan prediksi.
Secara sederhana:
Model 1 ──┐
Model 2 ──┤
Model 3 ──┤
Model 4 ──┤──> Gabungan Prediksi ──> Prediksi Akhir
Model 5 ──┤
Model 6 ──┘
Daripada hanya mengandalkan satu model, ensemble menggunakan beberapa model dan menggabungkan hasilnya.
Analogi Ensemble Learning
Bayangkan kita ingin mendapatkan pendapat mengenai suatu kondisi medis.
Kita dapat bertanya kepada:
Dokter 1
Dokter 2
Dokter 3
Dokter 4
Dokter 5
...
Dokter 10
Kemudian berbagai pendapat tersebut dipertimbangkan untuk menghasilkan suatu keputusan.
Analogi ini membantu memahami ide dasar ensemble:
Menggabungkan beberapa model dapat menghasilkan prediksi yang lebih stabil daripada hanya mengandalkan satu model.
Namun, analogi tersebut bukan berarti ensemble selalu lebih akurat. Keuntungan ensemble bergantung pada karakteristik data, model dasar, dan cara penggabungan prediksi.
Jenis-Jenis Ensemble Learning
Beberapa pendekatan ensemble yang umum antara lain:
Bagging
Bagging atau Bootstrap Aggregating melatih beberapa model pada sampel data yang berbeda, kemudian menggabungkan hasil prediksinya.
Random Forest merupakan salah satu contoh algoritma yang menggunakan prinsip bagging.
Secara sederhana:
Dataset
   │
   ├──> Sample 1 ──> Tree 1 ──┐
   ├──> Sample 2 ──> Tree 2 ──┤
   ├──> Sample 3 ──> Tree 3 ──┤
   ├──> Sample 4 ──> Tree 4 ──┤
   └──> Sample 5 ──> Tree 5 ──┘
                              │
                              ▼
                       Gabungkan Prediksi
                              │
                              ▼
                       Prediksi Akhir
Boosting
Boosting menggunakan beberapa model secara bertahap, di mana model berikutnya berusaha memperbaiki kesalahan model sebelumnya.
Contoh algoritma boosting:
- AdaBoost
- Gradient Boosting
- HistGradientBoosting
- XGBoost
- LightGBM
- CatBoost
Stacking
Stacking menggabungkan beberapa model berbeda dan menggunakan model lain sebagai meta-model untuk mempelajari bagaimana menggabungkan prediksi tersebut.
Secara sederhana:
Model A ──┐
Model B ──┼──> Meta Model ──> Prediksi Akhir
Model C ──┘
Pada materi ini kita akan fokus pada Random Forest Regressor.
Apa Itu Random Forest?
Random Forest adalah algoritma ensemble yang terdiri dari banyak Decision Tree.
Nama "Random Forest" dapat dipahami sebagai:
Random
   +
Forest
Forest berarti kumpulan banyak pohon.
Dalam konteks machine learning:
Decision Tree 1
Decision Tree 2
Decision Tree 3
Decision Tree 4
...
Decision Tree N
Kemudian prediksi dari pohon-pohon tersebut digabungkan untuk menghasilkan prediksi akhir.

Sumber: https://medium.com/@denizgunay/random-forest-af5bde5d7e1e
Random Forest untuk Regression
Jika target yang ingin diprediksi berupa nilai numerik kontinu, kita dapat menggunakan:
RandomForestRegressor
Contohnya:
from sklearn.ensemble import RandomForestRegressor

model = RandomForestRegressor()
Random Forest Regressor kemudian dilatih menggunakan:
model.fit(X_train, y_train)
dan digunakan untuk prediksi:
predictions = model.predict(X_test)
Random Forest untuk Classification
Random Forest juga dapat digunakan untuk classification.
Scikit-Learn menyediakan:
RandomForestClassifier
Contohnya:
from sklearn.ensemble import RandomForestClassifier

clf = RandomForestClassifier()
Jadi:
| Masalah | Estimator |
|---|---|
| Regression | RandomForestRegressor |
| Classification | RandomForestClassifier |
Perbedaannya terletak pada jenis target yang ingin diprediksi.
Bagaimana Random Forest Bekerja?
Secara sederhana, Random Forest membuat banyak Decision Tree.
Misalnya kita menggunakan:
100 Decision Tree
Setiap tree menghasilkan prediksi.
Misalnya:
Tree 1  → 2.8
Tree 2  → 3.1
Tree 3  → 2.9
Tree 4  → 3.2
Tree 5  → 2.7
...
Untuk regression, prediksi akhir diperoleh dengan menggabungkan prediksi dari tree-tree tersebut, secara umum melalui rata-rata.
Secara sederhana:
Keterangan:
- = prediksi akhir
- = jumlah decision tree
- = prediksi dari tree ke-
Dengan demikian:
Banyak Decision Tree
        ↓
Prediksi masing-masing tree
        ↓
Penggabungan prediksi
        ↓
Prediksi akhir
Mengapa Disebut Random Forest?
Ada beberapa sumber randomisasi dalam Random Forest.
Salah satunya adalah penggunaan bootstrap samples, yaitu setiap tree dilatih menggunakan sampel data yang diambil dari dataset training dengan proses sampling tertentu.
Selain itu, pada proses pemisahan node, Random Forest menggunakan subset fitur secara acak sebagai kandidat fitur.
Tujuan randomisasi tersebut adalah menghasilkan tree yang tidak semuanya identik sehingga prediksi ensemble dapat lebih beragam.
Jumlah Decision Tree
Parameter yang digunakan untuk menentukan jumlah tree adalah:
n_estimators
Contohnya:
model = RandomForestRegressor(
    n_estimators=100
)
Pada Scikit-Learn versi modern, nilai default n_estimators untuk RandomForestRegressor adalah 100.
Kita juga dapat mengubahnya:
model = RandomForestRegressor(
    n_estimators=200
)
Artinya kita meminta model membuat 200 tree.
Perlu diingat bahwa semakin banyak tree tidak otomatis berarti performa selalu meningkat secara signifikan. Jumlah tree juga memengaruhi waktu training dan penggunaan sumber daya.
Menyiapkan Dataset
Kita akan kembali menggunakan dataset California Housing yang telah digunakan pada materi sebelumnya.
Jika dataset sudah tersedia dalam:
housing_df
kita dapat memisahkan features dan target:
X = housing_df.drop("target", axis=1)
y = housing_df["target"]
X berisi features, sedangkan y berisi target.
Membagi Data Training dan Testing
Selanjutnya kita membagi dataset:
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42
)
Kita menggunakan:
80% → Training
20% → Testing
random_state=42 digunakan agar pembagian data dapat direproduksi.
Membuat Random Forest Regressor
Import estimator:
from sklearn.ensemble import RandomForestRegressor
Kemudian buat model:
model = RandomForestRegressor(
    random_state=42
)
Kita menggunakan random_state agar proses randomisasi model dapat direproduksi.
Melatih Model
Gunakan fit():
model.fit(X_train, y_train)
Secara sederhana:
X_train + y_train
        ↓
Random Forest
        ↓
Banyak Decision Tree
        ↓
Model terlatih
Membuat Prediksi
Setelah model selesai dilatih:
y_preds = model.predict(X_test)
Kita dapat melihat beberapa hasil prediksi:
print(y_preds[:10])
Prediksi tersebut merupakan nilai numerik karena kita menggunakan RandomForestRegressor.
Mengevaluasi Model
Kita dapat menggunakan:
score = model.score(X_test, y_test)

print(f"Skor Model: {score:.3f}")
Untuk RandomForestRegressor, method score() menghasilkan R².
Jadi:
model.score(X_test, y_test)
pada estimator tersebut berarti:
R²
Contoh Lengkap
Berikut contoh lengkap penggunaan Random Forest Regressor:
import numpy as np
import pandas as pd

from sklearn.datasets import fetch_california_housing
from sklearn.ensemble import RandomForestRegressor
from sklearn.model_selection import train_test_split

# 1. Random seed
np.random.seed(42)

# 2. Load dataset
housing = fetch_california_housing()

housing_df = pd.DataFrame(
    housing["data"],
    columns=housing["feature_names"]
)

housing_df["target"] = housing["target"]

# 3. Pisahkan features dan target
X = housing_df.drop("target", axis=1)
y = housing_df["target"]

# 4. Split data
X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42
)

# 5. Buat model
model = RandomForestRegressor(
    random_state=42
)

# 6. Training
model.fit(X_train, y_train)

# 7. Prediksi
y_preds = model.predict(X_test)

# 8. Evaluasi
score = model.score(X_test, y_test)

print(f"R² Score: {score:.3f}")
Membandingkan Ridge dengan Random Forest
Sekarang kita dapat membandingkan model yang telah dipelajari sebelumnya dengan Random Forest.
Pertama, gunakan Ridge:
from sklearn.linear_model import Ridge

ridge_model = Ridge()

ridge_model.fit(X_train, y_train)

ridge_score = ridge_model.score(
    X_test,
    y_test
)

print(f"Ridge R²: {ridge_score:.3f}")
Kemudian Random Forest:
rf_model = RandomForestRegressor(
    random_state=42
)

rf_model.fit(X_train, y_train)

rf_score = rf_model.score(
    X_test,
    y_test
)

print(f"Random Forest R²: {rf_score:.3f}")
Kita dapat melihat kedua hasil tersebut:
print(f"Ridge: {ridge_score:.3f}")
print(f"Random Forest: {rf_score:.3f}")
Contoh output:
Ridge: 0.xxx
Random Forest: 0.xxx
Angka aktual dapat berbeda berdasarkan versi library, konfigurasi model, dan pembagian data.
Mengapa Random Forest Dapat Memberikan Hasil yang Berbeda?
Ridge merupakan model linear dengan regularisasi.
Secara sederhana, Ridge berusaha memodelkan hubungan antara features dan target menggunakan hubungan linear.
Random Forest memiliki pendekatan yang berbeda.
Random Forest menggunakan kumpulan Decision Tree yang dapat mempelajari pola non-linear dan interaksi antar fitur.
Secara konseptual:
Ridge
    ↓
Hubungan linear
    ↓
Prediksi
Sedangkan:
Random Forest
    ↓
Decision Tree 1
Decision Tree 2
Decision Tree 3
...
Decision Tree N
    ↓
Gabungkan prediksi
    ↓
Prediksi akhir
Karena pendekatannya berbeda, performa kedua model pada dataset yang sama juga dapat berbeda.
Kelebihan Random Forest
Beberapa karakteristik yang membuat Random Forest populer antara lain:
Dapat Menangani Hubungan Non-Linear
Random Forest berbasis Decision Tree sehingga dapat menangkap pola yang tidak harus linear.
Tidak Selalu Membutuhkan Feature Scaling
Berbeda dengan beberapa algoritma yang sensitif terhadap skala fitur, model berbasis tree seperti Random Forest umumnya tidak membutuhkan standardisasi atau normalisasi fitur untuk bekerja.
Contohnya, kita tidak harus melakukan:
StandardScaler()
hanya agar Random Forest dapat bekerja.
Namun, preprocessing lain seperti penanganan missing values tetap perlu diperhatikan sesuai kebutuhan dataset dan estimator.
Dapat Digunakan untuk Classification dan Regression
Scikit-Learn menyediakan dua estimator:
RandomForestClassifier()
dan:
RandomForestRegressor()
Dapat Menangani Banyak Fitur
Random Forest dapat digunakan pada dataset dengan banyak fitur, selama ukuran dataset dan kompleksitas model masih sesuai dengan sumber daya yang tersedia.
Keterbatasan Random Forest
Random Forest juga memiliki beberapa keterbatasan.
Model Lebih Kompleks
Dibandingkan model linear sederhana seperti Ridge, Random Forest terdiri dari banyak Decision Tree sehingga struktur model lebih kompleks.
Training Dapat Lebih Berat
Jika jumlah tree sangat besar, training membutuhkan lebih banyak waktu dan sumber daya.
Contohnya:
RandomForestRegressor(
    n_estimators=1000
)
akan menggunakan jauh lebih banyak tree dibandingkan:
RandomForestRegressor(
    n_estimators=100
)
Interpretasi Tidak Sesederhana Model Linear
Model seperti Ridge relatif lebih mudah dijelaskan menggunakan koefisien fitur.
Random Forest terdiri dari banyak tree sehingga interpretasi keseluruhannya lebih kompleks.
Random Forest dan Overfitting
Random Forest dirancang untuk mengurangi beberapa masalah yang dapat terjadi pada satu Decision Tree, tetapi bukan berarti Random Forest tidak dapat overfitting.
Kita tetap perlu melakukan evaluasi dengan benar.
Misalnya:
train_score = model.score(X_train, y_train)
test_score = model.score(X_test, y_test)

print(f"Train R²: {train_score:.3f}")
print(f"Test R²: {test_score:.3f}")
Jika terdapat perbedaan besar antara performa training dan testing, kita perlu melakukan investigasi lebih lanjut.
Namun, satu perbandingan train-test saja belum cukup untuk mendiagnosis seluruh bentuk overfitting. Cross-validation dan analisis learning behavior dapat memberikan informasi tambahan.
Random Forest Bukan Selalu Model Terbaik
Penting untuk memahami bahwa:
Random Forest bukan berarti selalu lebih baik daripada Ridge.
Hasil model bergantung pada dataset dan konfigurasi yang digunakan.
Contohnya:
Dataset A

Ridge
R² = 0.80

Random Forest
R² = 0.76
Pada dataset lain:
Dataset B

Ridge
R² = 0.60

Random Forest
R² = 0.78
Karena itu, jangan memilih model hanya berdasarkan reputasi algoritma.
Lakukan eksperimen dan evaluasi.
Prinsip Eksperimentasi Machine Learning
Salah satu keterampilan penting dalam machine learning adalah kemampuan melakukan eksperimen secara sistematis.
Misalnya:
 Model A
    ↓
  Train
    ↓
Evaluate
    ↓
Catat hasil

 Model B
    ↓
  Train
    ↓
Evaluate
    ↓
Catat hasil

 Model C
    ↓
  Train
    ↓
Evaluate
    ↓
Catat hasil
Kemudian kita dapat membangun tabel eksperimen:
| Model | R² |
|---|---|
| Ridge | 0.xxx |
| Random Forest | 0.xxx |
| SVR | 0.xxx |
Tabel seperti ini akan membantu kita melihat perbedaan performa antar model.
Hal yang Perlu Diperhatikan Saat Membandingkan Model
Perbandingan model harus dilakukan secara adil.
Gunakan:
- Dataset yang sama
- Train/test split yang sama
- Preprocessing yang sesuai
- Metrik evaluasi yang sama
- Prosedur evaluasi yang konsisten
Misalnya kita menggunakan:
X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42
)
Kemudian gunakan X_train, X_test, y_train, dan y_test yang sama untuk model-model yang dibandingkan.
Dengan demikian, perbedaan performa lebih mudah dikaitkan dengan perbedaan model dan preprocessing.
Kesimpulan
Pada materi ini kita telah mempelajari konsep Ensemble Learning dan mencoba Random Forest Regressor.
Hal-hal penting yang perlu diingat:
- Tidak ada satu algoritma yang selalu terbaik untuk semua dataset.
- Jika model awal belum memberikan performa yang sesuai, kita dapat mencoba estimator lain.
- Ensemble Learning menggabungkan beberapa model untuk menghasilkan prediksi.
- Random Forest merupakan ensemble yang dibangun dari banyak Decision Tree.
RandomForestRegressordigunakan untuk masalah regression.RandomForestClassifierdigunakan untuk masalah classification.- Parameter
n_estimatorsmenentukan jumlah tree yang digunakan. - Pada Scikit-Learn versi modern, default
n_estimatorsadalah 100. - Random Forest umumnya tidak membutuhkan feature scaling.
- Random Forest dapat menangkap hubungan non-linear.
- Random Forest tetap dapat mengalami overfitting sehingga perlu dievaluasi dengan benar.
- Performa model harus diuji pada data yang tidak digunakan untuk fitting.
- Pemilihan model sebaiknya dilakukan melalui eksperimen dan perbandingan yang konsisten.
Tantangan Eksperimen
Gunakan dataset California Housing yang sama dan lakukan eksperimen berikut.
Tantangan 1 - Bandingkan Ridge dan Random Forest
Bandingkan:
Ridge
RandomForestRegressor
Catat nilai R² masing-masing.
Tantangan 2 - Ubah Jumlah Tree
Coba beberapa nilai:
n_estimators=10
n_estimators=50
n_estimators=100
n_estimators=200
Kemudian catat perubahan performanya.
Tantangan 3 - Bandingkan Training dan Testing
Hitung:
model.score(X_train, y_train)
dan:
model.score(X_test, y_test)
Kemudian perhatikan perbedaan performanya.
Tantangan 4 - Eksperimen dengan Model Lain
Coba beberapa estimator regression:
Ridge
RandomForestRegressor
SVR
Gunakan preprocessing yang sesuai untuk masing-masing model dan bandingkan hasilnya.
Tantangan 5 - Buat Tabel Eksperimen
Buat tabel seperti:
| Model | R² Train | R² Test |
|---|---|---|
| Ridge | ... | ... |
| Random Forest | ... | ... |
| SVR | ... | ... |
Tujuannya bukan hanya mendapatkan angka yang lebih tinggi, tetapi mulai membangun intuisi tentang karakteristik setiap algoritma.