Memilih Model: Classification
Pada materi sebelumnya kita telah mempelajari cara memilih estimator untuk masalah regression.
Sekarang kita akan membahas bagaimana memilih estimator untuk masalah classification menggunakan Scikit-Learn.
Classification digunakan ketika target yang ingin diprediksi berupa kategori atau kelas.
Contohnya:
- Memprediksi seseorang memiliki penyakit atau tidak.
- Memprediksi email spam atau bukan spam.
- Memprediksi transaksi fraud atau bukan fraud.
- Memprediksi pelanggan akan berhenti berlangganan atau tidak.
Pada materi ini kita akan menggunakan dataset Heart Disease dan membandingkan dua pendekatan:
Linear SVC
    ↓
Evaluasi
    ↓
Random Forest Classifier
    ↓
Evaluasi kembali
Tujuan utamanya bukan sekadar mencari model dengan skor tinggi, tetapi memahami proses eksperimen dan pemilihan estimator.
Memahami Classification
Classification adalah jenis supervised learning yang digunakan ketika target berupa kelas atau kategori.
Misalnya kita memiliki data pasien:
| Age | Cholesterol | Heart Rate | Target |
|---|---|---|---|
| 45 | 220 | 150 | 1 |
| 52 | 180 | 130 | 0 |
| 61 | 240 | 140 | 1 |
| 38 | 170 | 160 | 0 |
Pada contoh tersebut:
Ageadalah feature.Cholesteroladalah feature.Heart Rateadalah feature.Targetadalah label yang ingin diprediksi.
Target:
0 = Tidak memiliki penyakit
1 = Memiliki penyakit
Karena target merupakan kategori, masalah tersebut termasuk classification.
Dataset Heart Disease
Kita akan menggunakan dataset Heart Disease yang memiliki 303 sampel pada versi dataset yang digunakan dalam contoh pembelajaran ini.
Target terdiri dari dua kelas:
0
1
Dengan demikian, masalah ini termasuk binary classification karena hanya memiliki dua kelas target.
Secara sederhana:
Features
   │
   ├── Age
   ├── Sex
   ├── Cholesterol
   ├── Blood Pressure
   ├── Heart Rate
   └── ...
        │
        ▼
   Classification Model
        │
        ▼
     Prediction
        │
        ├── 0
        └── 1
Binary Classification
Binary classification berarti model harus memilih salah satu dari dua kelas.
Contoh:
0 → Tidak
1 → Ya
Contoh masalah lainnya:
Spam / Bukan Spam
Fraud / Bukan Fraud
Lulus / Tidak Lulus
Positif / Negatif
Berbeda dengan multiclass classification yang memiliki lebih dari dua kelas.
Contohnya:
0 → Kucing
1 → Anjing
2 → Burung
Memilih Estimator dengan Scikit-Learn
Scikit-Learn memiliki banyak estimator yang dapat digunakan untuk classification.
Contohnya:
- Logistic Regression
- K-Nearest Neighbors
- Support Vector Classifier
- Decision Tree
- Random Forest
- Gradient Boosting
- Naive Bayes
- dan estimator lainnya
Karena terdapat banyak pilihan, kita membutuhkan strategi untuk menentukan model mana yang akan dicoba.
Salah satu pendekatan yang dapat digunakan adalah Scikit-Learn estimator map.
Scikit-Learn Estimator Map
Secara konseptual, kita dapat memulai dengan beberapa pertanyaan.
Apakah jumlah data cukup?
        │
        ▼
Apa yang ingin diprediksi?
        │
        ▼
Kategori atau angka?
        │
        ▼
Apakah data memiliki label?
        │
        ▼
Pilih beberapa estimator
        │
        ▼
Eksperimen dan evaluasi
Untuk kasus kita:
303 samples
    ↓
Target berupa kategori
    ↓
Classification
    ↓
Data memiliki label
    ↓
Dataset relatif kecil
    ↓
Coba estimator classification
Peta estimator merupakan panduan untuk memulai eksperimen, bukan aturan mutlak bahwa satu algoritma pasti menjadi model terbaik.
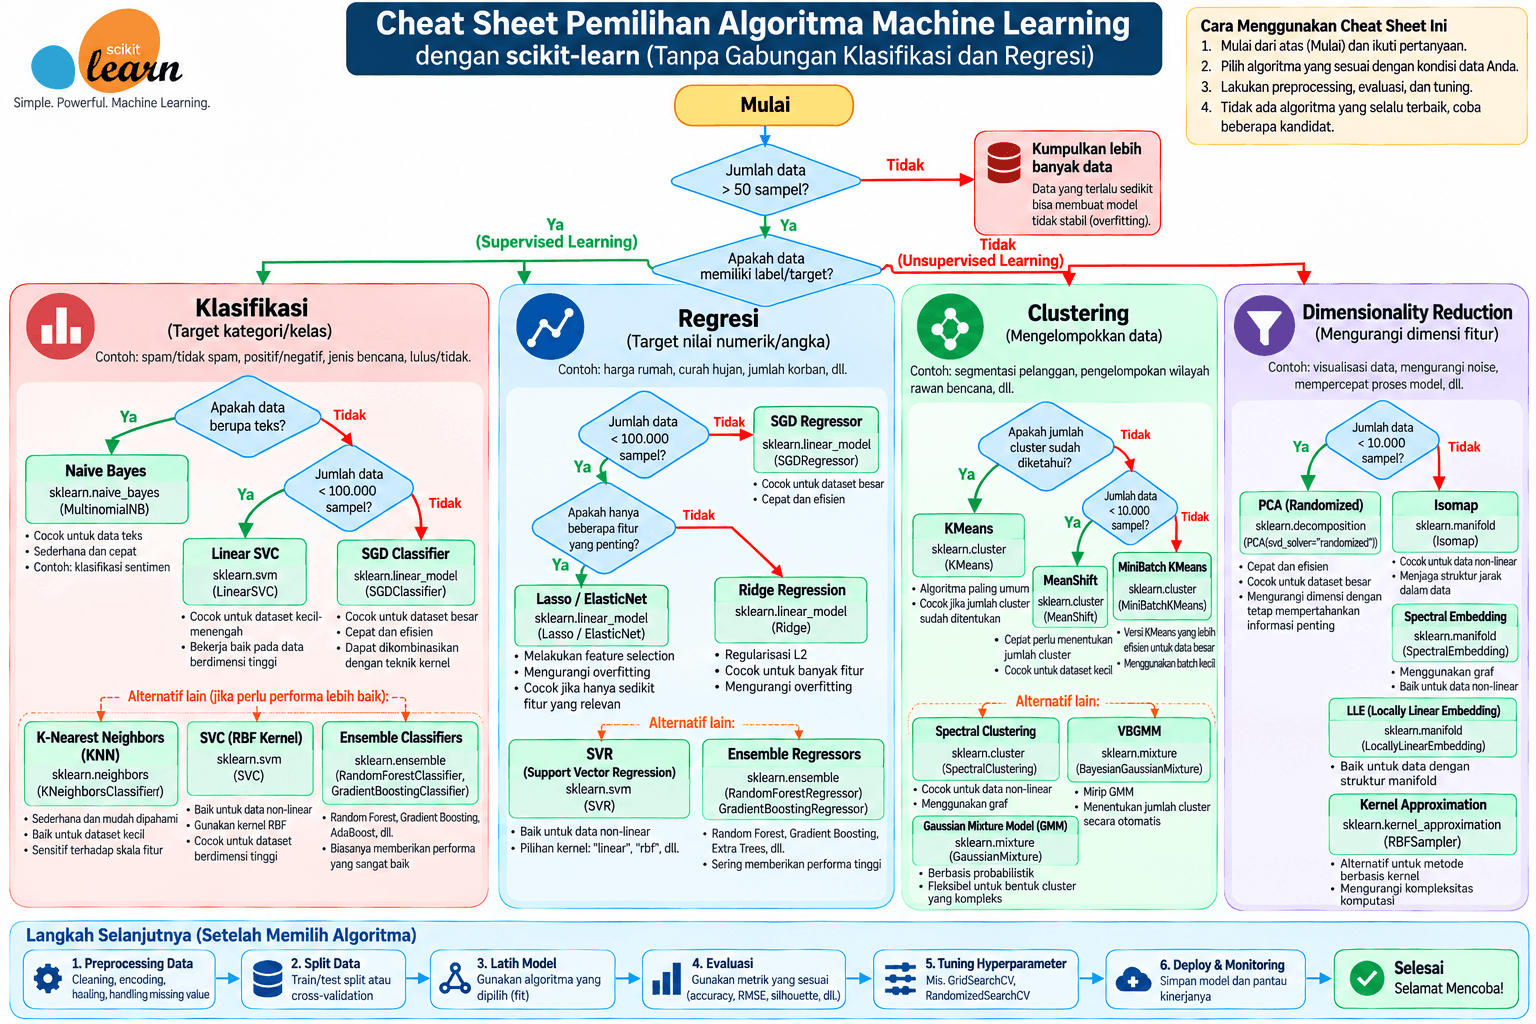
Baca juga: https://scikit-learn.org/stable/machine_learning_map.html
Memeriksa Dataset
Sebelum memilih model, kita perlu memahami dataset terlebih dahulu.
Import Pandas:
import pandas as pd
Kemudian baca dataset:
heart_disease = pd.read_csv("heart-disease.csv")
Lihat beberapa data:
heart_disease.head()
Periksa ukuran dataset:
heart_disease.shape
Kita dapat melihat jumlah baris dan kolom.
Periksa nama kolom:
heart_disease.columns
Kita juga dapat melihat informasi dataset:
heart_disease.info()
Memisahkan Features dan Target
Seperti pada masalah regression, kita perlu memisahkan:
X → Features
y → Target
Gunakan:
X = heart_disease.drop("target", axis=1)
y = heart_disease["target"]
X berisi seluruh feature yang digunakan untuk membuat prediksi.
Sedangkan y berisi label yang ingin diprediksi.
Kita dapat memeriksa bentuknya:
print("X shape:", X.shape)
print("y shape:", y.shape)
Membagi Data Training dan Testing
Selanjutnya kita membagi data menjadi training set dan test set.
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42,
    stratify=y
)
Pada contoh ini:
80% → Training
20% → Testing
Kita menggunakan:
stratify=y
agar proporsi kelas target relatif dipertahankan pada training dan test set.
Hal ini berguna terutama ketika distribusi kelas tidak seimbang.
Estimator Pertama: Linear SVC
Salah satu estimator yang dapat digunakan untuk classification adalah Linear SVC.
Import:
from sklearn.svm import LinearSVC
Kemudian buat model:
clf = LinearSVC()
clf sering digunakan sebagai nama variabel untuk classifier.
Melatih Linear SVC
Gunakan:
clf.fit(X_train, y_train)
Setelah model dilatih, kita dapat membuat prediksi:
y_preds = clf.predict(X_test)
Kemudian melihat beberapa hasil:
print(y_preds[:10])
Mengevaluasi Linear SVC
Kita dapat menggunakan:
clf.score(X_test, y_test)
Untuk LinearSVC, method score() digunakan untuk menghitung accuracy.
Contoh:
score = clf.score(X_test, y_test)

print(f"Linear SVC Accuracy: {score:.3f}")
Apa Itu Accuracy?
Accuracy menunjukkan proporsi prediksi yang benar dibandingkan seluruh prediksi.
Rumusnya:
Misalnya model melakukan 100 prediksi dan 85 prediksi benar:
atau:
85%
Namun, accuracy tidak selalu menjadi metrik yang cukup, terutama ketika distribusi kelas sangat tidak seimbang.
Pada kasus seperti itu, kita juga dapat mempertimbangkan:
- Precision
- Recall
- F1-score
- Confusion Matrix
- ROC-AUC
Convergence Warning pada Linear SVC
Saat menggunakan LinearSVC, kita mungkin mendapatkan warning seperti:
ConvergenceWarning
Hal ini dapat terjadi ketika algoritma belum mencapai kondisi konvergensi dalam jumlah iterasi yang diberikan.
Misalnya:
clf = LinearSVC(max_iter=1000)
Kita dapat meningkatkan jumlah iterasi:
clf = LinearSVC(max_iter=10000)
Kemudian training kembali:
clf.fit(X_train, y_train)
Namun, meningkatkan max_iter bukan satu-satunya solusi.
Convergence juga dapat dipengaruhi oleh skala fitur.
Karena itu, pada penggunaan Linear SVC yang lebih serius, preprocessing seperti feature scaling perlu dipertimbangkan.
Feature Scaling untuk Linear SVC
Algoritma berbasis optimasi dan jarak tertentu dapat sensitif terhadap skala fitur.
Misalnya kita memiliki:
Age          → 20 - 80
Cholesterol  → 100 - 500
Income       → 1.000.000 - 100.000.000
Perbedaan skala tersebut dapat memengaruhi proses training.
Salah satu pendekatan adalah menggunakan StandardScaler.
Contoh:
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import LinearSVC

clf = make_pipeline(
    StandardScaler(),
    LinearSVC(max_iter=10000)
)
Kemudian:
clf.fit(X_train, y_train)
dan:
score = clf.score(X_test, y_test)

print(f"Linear SVC Accuracy: {score:.3f}")
Menggunakan Pipeline membantu memastikan preprocessing diterapkan secara konsisten.
Bagaimana Jika Model Pertama Tidak Memuaskan?
Inilah salah satu prinsip penting dalam machine learning.
Jika model pertama memberikan performa yang belum sesuai, kita tidak harus memaksakan model tersebut.
Kita dapat mencoba estimator lain.
Contohnya:
Linear SVC
     ↓
Evaluasi
     ↓
Performa belum sesuai
     ↓
Coba estimator lain
     ↓
Random Forest
Proses ini merupakan bagian dari eksperimentasi machine learning.
Ensemble Classifier
Salah satu pilihan berikutnya adalah menggunakan ensemble classifier.
Ensemble classifier menggabungkan beberapa model dasar untuk menghasilkan prediksi.
Salah satu algoritma ensemble yang populer adalah:
RandomForestClassifier
Random Forest dibangun dari banyak Decision Tree.
Secara sederhana:
Decision Tree 1 ──┐
Decision Tree 2 ──┤
Decision Tree 3 ──┤
Decision Tree 4 ──┤
Decision Tree 5 ──┤
       ...        ├──> Gabungan Prediksi
Decision Tree N ──┘
Random Forest Classifier
Import:
from sklearn.ensemble import RandomForestClassifier
Kemudian buat classifier:
clf = RandomForestClassifier(
    random_state=42
)
Pada Scikit-Learn versi modern, nilai default n_estimators adalah 100.
Jika ingin menentukan jumlah tree secara eksplisit:
clf = RandomForestClassifier(
    n_estimators=100,
    random_state=42
)
Melatih Random Forest
Gunakan training data:
clf.fit(X_train, y_train)
Setelah model selesai dilatih:
y_preds = clf.predict(X_test)
Mengevaluasi Random Forest
Gunakan:
score = clf.score(X_test, y_test)

print(f"Random Forest Accuracy: {score:.3f}")
Untuk RandomForestClassifier, score() menghasilkan accuracy.
Membandingkan Linear SVC dan Random Forest
Kita dapat melakukan eksperimen dengan dua model.
Linear SVC
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import LinearSVC

linear_svc = make_pipeline(
    StandardScaler(),
    LinearSVC(max_iter=10000)
)

linear_svc.fit(X_train, y_train)

linear_svc_score = linear_svc.score(
    X_test,
    y_test
)

print(f"Linear SVC: {linear_svc_score:.3f}")
Random Forest
from sklearn.ensemble import RandomForestClassifier

random_forest = RandomForestClassifier(
    n_estimators=100,
    random_state=42
)

random_forest.fit(X_train, y_train)

random_forest_score = random_forest.score(
    X_test,
    y_test
)

print(f"Random Forest: {random_forest_score:.3f}")
Kemudian kita dapat membandingkan:
print(f"Linear SVC: {linear_svc_score:.3f}")
print(f"Random Forest: {random_forest_score:.3f}")
Hasil aktual dapat berbeda tergantung:
- pembagian data
- versi Scikit-Learn
- preprocessing
- hyperparameter
- random state
- kondisi dataset
Karena itu, angka seperti 85% sebaiknya dipahami sebagai contoh hasil eksperimen, bukan performa yang dijamin.
Membuat Tabel Perbandingan
Kita dapat membuat tabel sederhana:
results = pd.DataFrame({
    "Model": [
        "Linear SVC",
        "Random Forest"
    ],
    "Accuracy": [
        linear_svc_score,
        random_forest_score
    ]
})

results
Hasilnya dapat berbentuk:
| Model | Accuracy |
|---|---|
| Linear SVC | 0.xxx |
| Random Forest | 0.xxx |
Dengan cara ini kita dapat membandingkan model secara lebih terstruktur.
Mengapa Random Forest Sering Digunakan pada Data Tabular?
Random Forest merupakan salah satu model yang populer untuk data tabular.
Contoh data tabular:
| Age | Income | Cholesterol | Target |
|---|---|---|---|
| 45 | 50000 | 220 | 1 |
| 32 | 35000 | 180 | 0 |
| 61 | 72000 | 250 | 1 |
Random Forest dapat menangkap pola non-linear dan interaksi antar fitur tanpa membutuhkan feature scaling seperti yang sering diperlukan pada model tertentu.
Namun, pernyataan bahwa Random Forest selalu lebih baik untuk semua data tabular tidak tepat.
Pemilihan model tetap harus dilakukan melalui eksperimen.
Data Terstruktur dan Tidak Terstruktur
Secara umum, kita dapat membedakan data menjadi dua kategori.
Data Terstruktur
Data terstruktur biasanya berbentuk tabel dengan baris dan kolom.
Contoh:
- Data pasien
- Data transaksi
- Data pelanggan
- Data penjualan
- Data sensor
Contoh:
Age | Income | Gender | Target
----|--------|--------|-------
25  | 5000   | M      | 0
35  | 8000   | F      | 1
Untuk jenis data seperti ini, algoritma machine learning klasik seperti:
- Logistic Regression
- Random Forest
- Gradient Boosting
- SVM
- KNN
dapat menjadi kandidat yang perlu diuji.
Data Tidak Terstruktur
Contohnya:
- Gambar
- Audio
- Video
- Teks dalam bentuk mentah
Untuk data seperti ini, pendekatan deep learning sering menjadi pilihan penting, terutama ketika dataset cukup besar dan representasi data kompleks.
Contohnya:
Gambar
  ↓
Convolutional Neural Network

Teks
  ↓
Transformer

Audio
  ↓
Deep Learning
Namun, pemilihan pendekatan tetap bergantung pada ukuran dataset, representasi fitur, tujuan, dan kebutuhan aplikasi.
Tidak Semua Data Tabular Harus Menggunakan Random Forest
Ini merupakan poin penting.
Kita tidak boleh membuat aturan:
"Data tabular = Random Forest."
Random Forest hanya salah satu kandidat.
Model lain juga dapat memberikan performa yang baik, seperti:
Logistic Regression
Random Forest
Gradient Boosting
HistGradientBoosting
Support Vector Machine
K-Nearest Neighbors
Karena itu, pendekatan yang lebih baik adalah:
Data
 ↓
Tentukan masalah
 ↓
Pilih beberapa kandidat
 ↓
Train
 ↓
Evaluate
 ↓
Bandingkan
 ↓
Tuning
Mempercepat Eksperimen
Salah satu kemampuan penting dalam machine learning adalah melakukan eksperimen secara cepat dan terstruktur.
Misalnya kita memiliki:
models = {
    "Linear SVC": linear_svc,
    "Random Forest": random_forest
}
Kita dapat melakukan training dan evaluasi secara berulang.
for name, model in models.items():
    model.fit(X_train, y_train)

    score = model.score(
        X_test,
        y_test
    )

    print(f"{name}: {score:.3f}")
Dengan pendekatan seperti ini, kita dapat membandingkan beberapa estimator tanpa menulis ulang terlalu banyak kode.
Jangan Menggunakan Test Set Berulang Kali untuk Memilih Model
Ada satu hal penting yang perlu diperhatikan.
Jika kita terus mencoba banyak model dan memilih model berdasarkan performa pada test set yang sama, test set secara tidak langsung ikut memengaruhi keputusan pemilihan model.
Hal ini dapat menyebabkan test set contamination.
Pendekatan yang lebih baik adalah menggunakan:
Training Set
      ↓
Training model

Validation / Cross-Validation
      ↓
Memilih model dan hyperparameter

Test Set
      ↓
Evaluasi final
Untuk dataset yang lebih kecil, cross-validation sering digunakan sebagai bagian dari proses pemilihan model.
Accuracy Bukan Satu-Satunya Metrik
Pada materi ini kita menggunakan accuracy sebagai contoh.
Namun, untuk classification, kita sebaiknya tidak selalu bergantung pada accuracy.
Misalnya dataset memiliki:
95% → Kelas 0
5%  → Kelas 1
Sebuah model yang selalu memprediksi:
Kelas 0
dapat memperoleh accuracy sekitar 95%, tetapi model tersebut gagal mendeteksi kelas 1.
Karena itu, kita perlu mempertimbangkan metrik lain.
Confusion Matrix
Confusion matrix menunjukkan jumlah:
- True Positive
- True Negative
- False Positive
- False Negative
Contoh:
from sklearn.metrics import confusion_matrix

y_preds = random_forest.predict(X_test)

cm = confusion_matrix(
    y_test,
    y_preds
)

print(cm)
Classification Report
Kita juga dapat menggunakan:
from sklearn.metrics import classification_report

print(
    classification_report(
        y_test,
        y_preds
    )
)
Classification report dapat memberikan informasi seperti:
Precision
Recall
F1-score
Support
Metrik tersebut akan dibahas lebih lanjut pada materi evaluasi classification.
Workflow Memilih Estimator Classification
Secara keseluruhan, workflow yang dapat digunakan adalah:
1. Pahami masalah
       ↓
2. Identifikasi target
       ↓
3. Pastikan classification
       ↓
4. Pahami dataset
       ↓
5. Split data
       ↓
6. Pilih beberapa estimator
       ↓
7. Fit model
       ↓
8. Predict
       ↓
9. Evaluate
       ↓
10. Bandingkan model
       ↓
11. Tuning
       ↓
12. Evaluasi final
Proses tersebut bersifat iteratif.
Jika model pertama tidak memberikan hasil yang sesuai, kita dapat mencoba model lain.
Kesimpulan
Pada materi ini kita telah mempelajari bagaimana memilih estimator untuk masalah classification menggunakan Scikit-Learn.
Hal-hal penting yang perlu diingat:
- Classification digunakan untuk memprediksi kategori atau kelas.
- Dataset Heart Disease merupakan contoh masalah binary classification.
LinearSVCmerupakan salah satu estimator untuk classification.RandomForestClassifiermerupakan ensemble classifier berbasis Decision Tree.score()pada classifier sepertiLinearSVCdanRandomForestClassifiermenghasilkan accuracy.- Convergence warning pada
LinearSVCdapat berkaitan dengan proses optimasi yang belum konvergen. - Feature scaling dapat membantu model tertentu seperti SVM.
- Random Forest umumnya tidak membutuhkan feature scaling.
- Tidak ada satu algoritma yang selalu paling baik untuk semua dataset.
- Data tabular dapat dieksperimenkan dengan berbagai algoritma machine learning klasik.
- Data tidak terstruktur seperti gambar, teks, dan audio sering membutuhkan pendekatan yang berbeda.
- Pemilihan model sebaiknya dilakukan melalui eksperimen yang konsisten.
- Jangan hanya melihat accuracy jika distribusi kelas tidak seimbang.
- Test set sebaiknya tetap digunakan sebagai evaluasi final dan tidak terus-menerus digunakan untuk memilih model.
- Cross-validation dapat membantu proses pemilihan model dan hyperparameter.
Tantangan Eksperimen
Gunakan dataset Heart Disease dan lakukan beberapa eksperimen berikut.
Tantangan 1 - Bandingkan Beberapa Classifier
Coba minimal:
Linear SVC
Random Forest
Logistic Regression
K-Nearest Neighbors
Catat hasil accuracy masing-masing model.
Tantangan 2 - Gunakan Scaling
Bandingkan Linear SVC:
Linear SVC
dengan:
StandardScaler
     ↓
Linear SVC
Perhatikan perubahan performa dan convergence.
Tantangan 3 - Gunakan Confusion Matrix
Gunakan:
from sklearn.metrics import confusion_matrix

confusion_matrix(
    y_test,
    y_preds
)
Kemudian identifikasi:
True Positive
True Negative
False Positive
False Negative
Tantangan 4 - Gunakan Classification Report
Gunakan:
from sklearn.metrics import classification_report

print(
    classification_report(
        y_test,
        y_preds
    )
)
Perhatikan perbedaan:
Precision
Recall
F1-score
Tantangan 5 - Buat Tabel Eksperimen
Buat tabel seperti:
| Model | Accuracy | Precision | Recall | F1-score |
|---|---|---|---|---|
| Linear SVC | ... | ... | ... | ... |
| Random Forest | ... | ... | ... | ... |
| Logistic Regression | ... | ... | ... | ... |
| KNN | ... | ... | ... | ... |
Tujuan eksperimen ini bukan sekadar mencari angka tertinggi, tetapi membangun pemahaman tentang bagaimana karakteristik dataset dan algoritma memengaruhi hasil machine learning.