Persiapan Data: Feature Encoding
Salah satu persyaratan penting dalam Machine Learning adalah memastikan data yang diberikan kepada model memiliki format yang dapat diproses oleh algoritma.
Banyak algoritma Machine Learning pada Scikit-Learn bekerja dengan data numerik. Sementara itu, dataset dunia nyata sering memiliki data berbentuk teks atau kategori seperti:
Make
Color
Fuel Type
Gender
City
Category
Data tersebut perlu dikonversi menjadi representasi numerik sebelum digunakan oleh model.
Proses mengubah data kategorikal menjadi bentuk numerik disebut feature encoding.
Apa Itu Feature Encoding?
Feature encoding adalah proses mengubah data kategorikal menjadi representasi numerik yang dapat digunakan oleh algoritma Machine Learning.
Contoh data awal:
| Make | Color | Doors |
|---|---|---|
| Toyota | Blue | 4 |
| Honda | Red | 4 |
| BMW | Black | 2 |
| Toyota | Red | 4 |
Kolom:
Make
Color
berisi data kategorikal berbentuk teks.
Model Machine Learning tidak dapat begitu saja memperlakukan:
Toyota
Honda
BMW
sebagai nilai numerik.
Karena itu, data perlu di-encode.
Mengapa Data Harus Berbentuk Numerik?
Banyak algoritma Machine Learning melakukan perhitungan matematis terhadap data.
Misalnya:
x₁ + x₂
x₁ - x₂
x₁ × x₂
distance(x₁, x₂)
Jika sebuah fitur berisi:
Toyota
Honda
BMW
tidak ada operasi matematika langsung yang bermakna seperti:
Toyota + Honda
Karena itu, kategori perlu direpresentasikan dalam bentuk numerik.
Namun, proses konversi harus dilakukan dengan hati-hati.
Kita tidak boleh sembarangan mengubah:
Toyota → 1
Honda  → 2
BMW    → 3
karena angka tersebut dapat memberikan kesan bahwa:
BMW > Honda > Toyota
atau terdapat jarak numerik tertentu antar kategori.
Padahal kategori tersebut tidak memiliki urutan seperti itu.
Contoh Dataset Car Sales
Misalnya kita memiliki dataset penjualan mobil:
| Make | Colour | Doors | Odometer (KM) | Price |
|---|---|---|---|---|
| Toyota | Blue | 4 | 150000 | 4000 |
| Honda | Red | 4 | 120000 | 5000 |
| BMW | Black | 2 | 80000 | 12000 |
| Toyota | White | 4 | 100000 | 7000 |
Misalnya:
Make
Colour
merupakan categorical features.
Sedangkan:
Odometer (KM)
merupakan numerical feature.
Kolom:
Price
dapat digunakan sebagai target jika tujuan kita adalah memprediksi harga mobil.
Memeriksa Tipe Data
Sebelum melakukan encoding, kita dapat memeriksa tipe data menggunakan Pandas:
car_sales.dtypes
Contoh hasil:
Make             object
Colour           object
Doors             int64
Odometer (KM)     int64
Price             int64
Dari hasil tersebut kita dapat melihat bahwa:
Make    → object
Colour  → object
merupakan data kategorikal berbentuk teks.
Sedangkan:
Doors
Odometer (KM)
Price
merupakan data numerik.
Masalah Ketika Data Teks Langsung Digunakan
Misalnya kita membuat:
X = car_sales.drop("Price", axis=1)
y = car_sales["Price"]
Kemudian mencoba melatih:
from sklearn.ensemble import RandomForestRegressor

model = RandomForestRegressor()

model.fit(X, y)
Jika X masih memiliki kolom teks seperti:
Make
Colour
model dapat menghasilkan error karena data kategorikal tersebut belum dikonversi ke representasi yang dapat diproses.
Contoh error dapat berupa:
ValueError: could not convert string to float
Masalahnya bukan pada Random Forest secara khusus, tetapi pada representasi data yang diberikan kepada estimator.
Solusi: Feature Encoding
Salah satu solusi yang umum digunakan adalah:
Categorical Data
       │
       ▼
Feature Encoding
       │
       ▼
Numerical Data
       │
       ▼
Machine Learning Model
Salah satu teknik encoding yang paling umum adalah One-Hot Encoding.
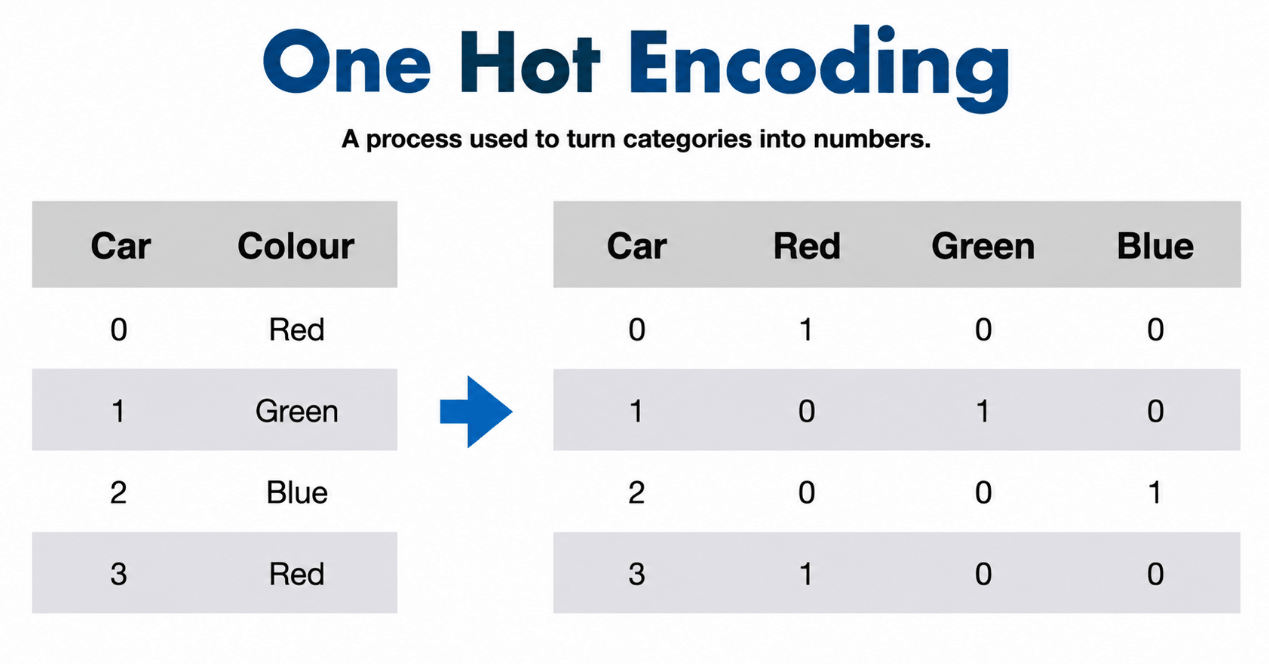
Apa Itu One-Hot Encoding?
One-Hot Encoding mengubah setiap kategori menjadi kolom biner.
Misalnya terdapat:
Color
-----
Red
Blue
Green
One-Hot Encoding dapat menghasilkan:
| Color_Red | Color_Blue | Color_Green |
|---|---|---|
| 1 | 0 | 0 |
| 0 | 1 | 0 |
| 0 | 0 | 1 |
Setiap baris hanya memiliki nilai 1 pada kategori yang sesuai.
Mengapa Menggunakan 0 dan 1?
Nilai:
1
menunjukkan bahwa kategori tersebut aktif atau dimiliki oleh sebuah sampel.
Sedangkan:
0
menunjukkan bahwa kategori tersebut tidak aktif.
Contohnya:
Color = Red
menjadi:
Color_Red   = 1
Color_Blue  = 0
Color_Green = 0
OneHotEncoder dari Scikit-Learn
Scikit-Learn menyediakan class:
OneHotEncoder
yang berada pada module:
sklearn.preprocessing
Import:
from sklearn.preprocessing import OneHotEncoder
Kemudian:
one_hot = OneHotEncoder()
Menggunakan ColumnTransformer
Kita biasanya tidak hanya memiliki data kategorikal.
Dataset dapat memiliki kombinasi:
Categorical Features
+
Numerical Features
Misalnya:
Make          → categorical
Colour        → categorical
Doors         → categorical
Odometer      → numerical
Kita ingin melakukan encoding hanya pada kolom kategorikal.
Untuk itu kita dapat menggunakan:
ColumnTransformer
Import:
from sklearn.compose import ColumnTransformer
Menentukan Kolom Kategorikal
Misalnya:
categorical_features = [
    "Make",
    "Colour",
    "Doors"
]
Kolom tersebut akan diproses menggunakan One-Hot Encoding.
Sedangkan kolom numerik lainnya dapat dibiarkan.
Membuat OneHotEncoder
from sklearn.preprocessing import OneHotEncoder

one_hot = OneHotEncoder(
    handle_unknown="ignore"
)
Parameter:
handle_unknown="ignore"
berguna ketika terdapat kategori pada data baru yang tidak ditemukan saat encoder melakukan fitting.
Contohnya:
Training:
Toyota
Honda
BMW

Data baru:
Toyota
Honda
Tesla
Jika Tesla belum pernah ditemukan saat training, handle_unknown="ignore" membantu encoder menangani kategori tersebut tanpa menghasilkan error karena kategori baru.
Membuat ColumnTransformer
Contoh:
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder

categorical_features = [
    "Make",
    "Colour",
    "Doors"
]

one_hot = OneHotEncoder(
    handle_unknown="ignore"
)

transformer = ColumnTransformer(
    transformers=[
        (
            "one_hot",
            one_hot,
            categorical_features
        )
    ],
    remainder="passthrough"
)
Memahami remainder="passthrough"
Parameter:
remainder="passthrough"
berarti kolom yang tidak disebutkan dalam transformer akan tetap diteruskan tanpa transformasi dari transformer tersebut.
Misalnya:
Make
Colour
Doors
Odometer (KM)
Kita hanya menentukan:
Make
Colour
Doors
sebagai categorical features.
Maka:
Make          → One-Hot Encoding
Colour        → One-Hot Encoding
Doors         → One-Hot Encoding
Odometer (KM) → tetap diteruskan
Melakukan Transformasi
Setelah transformer dibuat:
X_transformed = transformer.fit_transform(X)
Proses tersebut melakukan dua hal:
fit
 ↓
Mempelajari kategori

transform
 ↓
Mengubah data menjadi representasi numerik
Memahami fit_transform
Method:
fit_transform()
merupakan kombinasi:
fit()
dan:
transform()
Secara konseptual:
fit
│
└── Belajar parameter/kategori dari data

transform
│
└── Mengubah data menggunakan hasil fit
Untuk data training, kita biasanya menggunakan:
fit_transform()
Sedangkan untuk data baru atau test set:
transform()
Perbedaan ini penting untuk mencegah data leakage.
Melihat Hasil Transformasi
Setelah:
X_transformed = transformer.fit_transform(X)
kita dapat memeriksa:
print(X_transformed)
Output dapat berupa array atau sparse matrix tergantung konfigurasi encoder dan data.
Contoh output:
array([[0.00000e+00, 1.00000e+00, 0.00000e+00, ..., 1.00000e+00,
        0.00000e+00, 3.54310e+04],
       [1.00000e+00, 0.00000e+00, 0.00000e+00, ..., 0.00000e+00,
        1.00000e+00, 1.92714e+05],
       [0.00000e+00, 1.00000e+00, 0.00000e+00, ..., 1.00000e+00,
        0.00000e+00, 8.47140e+04],
       ...,
       [0.00000e+00, 0.00000e+00, 1.00000e+00, ..., 1.00000e+00,
        0.00000e+00, 6.66040e+04],
       [0.00000e+00, 1.00000e+00, 0.00000e+00, ..., 1.00000e+00,
        0.00000e+00, 2.15883e+05],
       [0.00000e+00, 0.00000e+00, 0.00000e+00, ..., 1.00000e+00,
        0.00000e+00, 2.48360e+05]], shape=(1000, 13))
Jangan kaget jika hasilnya tidak terlihat seperti DataFrame biasa.
Agar hasil transformed lebih rapi untuk dilihat, kita dapat memasukan nilainya ke dalam DataFrame:
pd.DataFrame(transformer_X)
Sparse Matrix
One-Hot Encoding dapat menghasilkan sparse matrix.
Sparse matrix digunakan ketika sebagian besar nilai adalah 0.
Misalnya:
| Red | Blue | Green | Black | White |
|---|---|---|---|---|
| 1 | 0 | 0 | 0 | 0 |
| 0 | 1 | 0 | 0 | 0 |
| 0 | 0 | 0 | 1 | 0 |
| 0 | 0 | 0 | 0 | 1 |
Sebagian besar nilai adalah:
0
Daripada menyimpan semua nilai 0 secara penuh, sparse representation dapat menghemat memori pada dataset tertentu.
Melihat Nama Feature Setelah Encoding
Pada versi Scikit-Learn yang mendukungnya, kita dapat menggunakan:
feature_names = transformer.get_feature_names_out()

print(feature_names)
Contoh hasil dapat terlihat seperti:
[
    "one_hot__Make_BMW",
    "one_hot__Make_Honda",
    "one_hot__Make_Toyota",
    "one_hot__Colour_Black",
    "one_hot__Colour_Blue",
    "one_hot__Colour_Red",
    "one_hot__Doors_2",
    "one_hot__Doors_4",
    "remainder__Odometer (KM)"
]
Nama sebenarnya bergantung pada dataset dan konfigurasi transformer.
Mengubah Hasil Kembali Menjadi DataFrame
Untuk kebutuhan eksplorasi, hasil transformasi dapat dikonversi menjadi DataFrame.
Contoh:
import pandas as pd

X_transformed_df = pd.DataFrame(
    X_transformed.toarray(),
    columns=transformer.get_feature_names_out()
)

X_transformed_df.head()
Namun, perlu diperhatikan bahwa .toarray() mengubah sparse matrix menjadi dense array.
Untuk dataset dengan jumlah kategori yang sangat besar, hal tersebut dapat menggunakan memori yang jauh lebih besar.
Bagaimana dengan Kolom Doors?
Misalnya:
Doors
-----
2
3
4
5
Secara teknis angka tersebut sudah merupakan numerical data.
Namun, kita perlu mempertimbangkan makna fitur tersebut.
Jika angka:
2
3
4
5
hanya menunjukkan kategori jumlah pintu, kita dapat memperlakukannya sebagai categorical feature.
Contohnya:
Doors_2
Doors_3
Doors_4
Doors_5
Hal ini berbeda dengan fitur seperti:
Odometer
yang memiliki makna kuantitatif.
Categorical vs Numerical
Perhatikan perbedaan berikut:
| Feature | Tipe | Makna |
|---|---|---|
| Make | Categorical | Merek mobil |
| Colour | Categorical | Warna |
| Doors | Bisa categorical | Jumlah pintu |
| Odometer | Numerical | Jarak tempuh |
| Price | Numerical | Harga |
Jadi, tipe data Python tidak selalu menentukan bagaimana sebuah fitur harus diperlakukan dalam Machine Learning.
Contohnya:
Doors = 4
secara Python adalah integer, tetapi secara konseptual dapat diperlakukan sebagai kategori.
Alternatif dengan Pandas get_dummies()
Selain menggunakan Scikit-Learn, Pandas menyediakan:
pd.get_dummies()
Contoh:
import pandas as pd

dummies = pd.get_dummies(
    car_sales[
        ["Make", "Colour", "Doors"]
    ]
)
Fungsi tersebut akan membuat kolom dummy berdasarkan kategori yang ditemukan.
Contoh Hasil get_dummies()
Misalnya:
Make
----
Toyota
Honda
BMW
dapat berubah menjadi:
| Make_BMW | Make_Honda | Make_Toyota |
|---|---|---|
| 0 | 0 | 1 |
| 0 | 1 | 0 |
| 1 | 0 | 0 |
Kolom kategorikal berubah menjadi representasi biner.
Membandingkan OneHotEncoder dan get_dummies()
| Metode | Library | Cocok untuk |
|---|---|---|
OneHotEncoder | Scikit-Learn | Workflow Machine Learning |
pd.get_dummies() | Pandas | Eksplorasi dan preprocessing sederhana |
Keduanya dapat menghasilkan representasi one-hot, tetapi penggunaannya berbeda.
Untuk workflow Machine Learning yang membutuhkan pipeline preprocessing, OneHotEncoder biasanya lebih cocok karena dapat digabungkan dengan:
ColumnTransformer
+
Pipeline
+
GridSearchCV
Masalah dengan Encoding Sebelum Train-Test Split
Kesalahan yang perlu dihindari adalah melakukan fitting encoder pada seluruh dataset sebelum train-test split.
Contohnya:
Seluruh Dataset
      │
      ▼
fit encoder
      │
      ▼
Train-Test Split
Cara tersebut dapat membuat informasi dari test set ikut digunakan dalam proses preprocessing.
Pendekatan yang lebih aman adalah:
Dataset
   │
   ▼
Train-Test Split
   │
   ├─────────────┐
   │             │
Training        Test
   │             │
   ▼             │
fit encoder      │
   │             │
transform        │
   │             │
   └──────┐      │
          │      │
          ▼      ▼
       Model   transform
                test
Dengan demikian encoder belajar kategori dari training data.
Menggunakan Pipeline
Untuk workflow yang lebih aman, kita dapat menggabungkan preprocessing dan model menggunakan Pipeline.
Contoh sederhana:
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder
from sklearn.pipeline import Pipeline
from sklearn.ensemble import RandomForestRegressor

categorical_features = [
    "Make",
    "Colour",
    "Doors"
]

one_hot = OneHotEncoder(
    handle_unknown="ignore"
)

preprocessor = ColumnTransformer(
    transformers=[
        (
            "one_hot",
            one_hot,
            categorical_features
        )
    ],
    remainder="passthrough"
)

model = RandomForestRegressor(
    random_state=42
)

pipeline = Pipeline(
    steps=[
        ("preprocessor", preprocessor),
        ("model", model)
    ]
)
Dengan Pipeline:
Data
 │
 ▼
Preprocessor
 │
 ├── One-Hot Encoding
 │
 └── Numerical Features
 │
 ▼
Random Forest
 │
 ▼
Prediction
Pipeline juga membantu menjaga preprocessing tetap konsisten ketika digunakan pada training dan data baru.
Membagi Data Sebelum Fitting Pipeline
Setelah Pipeline dibuat, kita dapat melakukan train-test split:
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42
)
Kemudian:
pipeline.fit(X_train, y_train)
Untuk melakukan prediksi:
y_preds = pipeline.predict(X_test)
Dan evaluasi:
score = pipeline.score(X_test, y_test)

print(score)
Dengan cara ini, preprocessing dipelajari dari training data melalui Pipeline.
Workflow Lengkap
Berikut workflow feature encoding yang lebih aman:
Raw Dataset
     │
     ▼
Pisahkan X dan y
     │
     ▼
Train-Test Split
     │
     ├─────────────────┐
     │                 │
 X_train             X_test
     │                 │
     ▼                 │
Preprocessing          │
     │                 │
     ├── One-Hot       │
     └── Passthrough   │
     │                 │
     ▼                 │
   Model               │
     │                 │
     ▼                 │
 Prediction ◄──────────┘
     │
     ▼
 Evaluation
Contoh Lengkap dengan Car Sales
Berikut contoh workflow yang menggabungkan beberapa konsep:
import pandas as pd

from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder
from sklearn.pipeline import Pipeline
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestRegressor

# Membaca dataset
car_sales = pd.read_csv("car-sales-extended.csv")

# Memisahkan features dan target
X = car_sales.drop("Price", axis=1)
y = car_sales["Price"]

# Menentukan kolom kategorikal
categorical_features = [
    "Make",
    "Colour",
    "Doors"
]

# Membuat encoder
one_hot = OneHotEncoder(
    handle_unknown="ignore"
)

# Membuat preprocessor
preprocessor = ColumnTransformer(
    transformers=[
        (
            "one_hot",
            one_hot,
            categorical_features
        )
    ],
    remainder="passthrough"
)

# Membuat model
model = RandomForestRegressor(
    random_state=42
)

# Membuat pipeline
pipeline = Pipeline(
    steps=[
        ("preprocessor", preprocessor),
        ("model", model)
    ]
)

# Membagi data
X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42
)

# Training
pipeline.fit(X_train, y_train)

# Prediksi
y_preds = pipeline.predict(X_test)

# Evaluasi
score = pipeline.score(X_test, y_test)

print("Model score:", score)
Mengapa Pipeline Sangat Berguna?
Tanpa Pipeline, kita mungkin harus mengatur banyak langkah secara manual:
Fit encoder
   ↓
Transform training
   ↓
Transform test
   ↓
Fit model
   ↓
Predict
Dengan Pipeline:
pipeline.fit(X_train, y_train)
dan:
pipeline.predict(X_test)
Scikit-Learn menangani urutan preprocessing dan model sesuai langkah yang telah kita definisikan.
Pipeline juga sangat berguna ketika nanti kita menggunakan:
Cross-validation
Hyperparameter tuning
GridSearchCV
RandomizedSearchCV
Kesalahan Umum
Kesalahan 1 - Langsung Memberikan String ke Model
Contoh:
model.fit(X, y)
sementara X masih memiliki:
Make
Colour
berupa string.
Solusi:
Lakukan encoding terlebih dahulu.
Kesalahan 2 - Mengubah Kategori Menjadi Angka Secara Sembarangan
Contoh:
Toyota → 1
Honda  → 2
BMW    → 3
Cara tersebut dapat memperkenalkan hubungan numerik yang sebenarnya tidak ada.
Untuk kategori nominal, One-Hot Encoding sering lebih sesuai.
Kesalahan 3 - Fit Encoder pada Seluruh Dataset
Jangan melakukan:
encoder.fit(X)
sebelum train-test split jika encoder tersebut mempelajari informasi dari seluruh dataset.
Lebih aman menggunakan:
Training → fit
Test → transform
atau menggunakan Pipeline.
Kesalahan 4 - Tidak Menangani Kategori Baru
Data baru dapat memiliki kategori yang tidak muncul pada training.
Contohnya:
Training:
Toyota
Honda
BMW

Production:
Toyota
Honda
Tesla
Penggunaan:
handle_unknown="ignore"
dapat membantu menangani kondisi tersebut.
Checklist Feature Encoding
Sebelum menjalankan model, periksa:
- Sudah mengetahui fitur mana yang kategorikal.
- Sudah mengetahui fitur mana yang numerik.
- Data kategorikal sudah di-encode.
- Tidak melakukan encoding secara sembarangan.
-
OneHotEncodermenggunakan konfigurasi yang sesuai. -
handle_unknown="ignore"dipertimbangkan untuk data baru. - Preprocessing tidak menyebabkan data leakage.
- Train dan test diproses secara konsisten.
- Pipeline digunakan ketika workflow semakin kompleks.
Ringkasan
Machine Learning sering membutuhkan data dalam bentuk numerik.
Jika dataset memiliki:
Make
Colour
Fuel Type
Category
data tersebut perlu diproses sebelum diberikan kepada model.
Salah satu pendekatan yang umum adalah:
Categorical Data
       │
       ▼
OneHotEncoder
       │
       ▼
0 dan 1
       │
       ▼
Machine Learning Model
Dalam Scikit-Learn, kombinasi:
OneHotEncoder
dan:
ColumnTransformer
memungkinkan kita melakukan encoding hanya pada kolom tertentu sementara fitur numerik tetap dipertahankan.
Untuk workflow Machine Learning yang lebih aman, kita dapat menggunakan:
ColumnTransformer
        +
Pipeline
        +
Machine Learning Model
Dengan pendekatan tersebut, preprocessing dapat diterapkan secara konsisten dan risiko data leakage dapat dikurangi.
Cheat Sheet
| Kebutuhan | Kode |
|---|---|
| Import OneHotEncoder | from sklearn.preprocessing import OneHotEncoder |
| Membuat encoder | OneHotEncoder(handle_unknown="ignore") |
| Import ColumnTransformer | from sklearn.compose import ColumnTransformer |
| Menentukan kolom kategori | categorical_features = ["Make", "Colour", "Doors"] |
| Membuat transformer | ColumnTransformer(...) |
| Transform data | transformer.fit_transform(X) |
| Melihat nama fitur | transformer.get_feature_names_out() |
| Pandas dummy encoding | pd.get_dummies(data) |
| Membuat Pipeline | Pipeline(steps=[...]) |