Pengenalan Scikit-Learn

Scikit-Learn merupakan salah satu library Python yang paling banyak digunakan untuk membangun aplikasi Machine Learning.
Dengan Scikit-Learn, kita dapat menggunakan berbagai algoritma Machine Learning tanpa harus mengimplementasikan seluruh algoritma dan rumus matematikanya dari awal.
Scikit-Learn menyediakan API yang relatif konsisten untuk berbagai proses Machine Learning, mulai dari preprocessing data, training model, membuat prediksi, hingga evaluasi model.
Apa Itu Scikit-Learn?
Scikit-Learn adalah library Machine Learning open-source untuk Python yang menyediakan berbagai tools untuk:
- Classification.
- Regression.
- Clustering.
- Dimensionality reduction.
- Preprocessing data.
- Model selection.
- Model evaluation.
- Hyperparameter tuning.
- Pipeline Machine Learning.
Scikit-Learn biasanya diimpor menggunakan nama:
import sklearn
Namun, dalam praktiknya kita lebih sering mengimpor class atau fungsi dari modul tertentu.
Contoh:
from sklearn.model_selection import train_test_split
atau:
from sklearn.ensemble import RandomForestClassifier
Mengapa Scikit-Learn Banyak Digunakan?
Scikit-Learn memiliki beberapa karakteristik yang membuatnya populer dalam pembelajaran dan pengembangan Machine Learning klasik.
Terintegrasi dengan Ekosistem Python
Scikit-Learn bekerja dengan baik bersama library Python lainnya seperti:
NumPy
Pandas
Matplotlib
Seaborn
Contoh workflow sederhana:
Pandas
   ↓
Membaca dan memproses data

NumPy
   ↓
Operasi numerik

Matplotlib / Seaborn
   ↓
Visualisasi

Scikit-Learn
   ↓
Machine Learning
Dengan demikian, Scikit-Learn tidak berdiri sendiri dalam workflow Data Science.
Banyak Algoritma Machine Learning
Scikit-Learn menyediakan berbagai algoritma yang dapat digunakan untuk berbagai jenis permasalahan.
Contohnya:
Classification
Digunakan ketika target yang ingin diprediksi berupa kategori.
Contoh:
Spam / Not Spam
Lulus / Tidak Lulus
0 / 1
Disease / No Disease
Beberapa algoritma yang tersedia antara lain:
- Logistic Regression.
- K-Nearest Neighbors.
- Support Vector Machine.
- Decision Tree.
- Random Forest.
- Naive Bayes.
Regression
Digunakan ketika target berupa nilai numerik.
Contoh:
Harga rumah
Suhu
Penjualan
Pendapatan
Beberapa algoritma yang tersedia:
- Linear Regression.
- Ridge Regression.
- Lasso Regression.
- Random Forest Regression.
- Gradient Boosting Regression.
Clustering
Digunakan untuk menemukan kelompok atau struktur pada data tanpa target yang diketahui.
Contohnya:
- K-Means.
- DBSCAN.
- Agglomerative Clustering.
Dimensionality Reduction
Digunakan untuk mengurangi jumlah fitur atau dimensi data.
Contohnya:
- PCA.
- Truncated SVD.
Preprocessing Data
Sebelum data digunakan untuk melatih model, data sering kali perlu dipersiapkan terlebih dahulu.
Scikit-Learn menyediakan berbagai tools preprocessing.
Contohnya:
Missing value handling
        ↓
     Encoding
        ↓
     Scaling
        ↓
Feature transformation
        ↓
      Model
Beberapa tools yang tersedia:
StandardScalerMinMaxScalerOneHotEncoderSimpleImputerColumnTransformer
Contoh:
from sklearn.preprocessing import StandardScaler

scaler = StandardScaler()
Model Selection
Scikit-Learn juga menyediakan berbagai tools untuk membantu proses pemilihan dan pengujian model.
Contohnya:
from sklearn.model_selection import train_test_split
Fungsi tersebut dapat digunakan untuk membagi data menjadi subset training dan testing.
Contoh:
X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42
)
Konsep ini penting karena kita tidak ingin hanya mengukur performa model pada data yang digunakan untuk melatihnya.
Evaluasi Model
Setelah model membuat prediksi, kita perlu mengetahui seberapa baik model tersebut bekerja.
Scikit-Learn menyediakan berbagai metrics.
Untuk classification, contohnya:
- Accuracy.
- Precision.
- Recall.
- F1-score.
- Confusion matrix.
- ROC AUC.
Untuk regression, contohnya:
- Mean Absolute Error.
- Mean Squared Error.
- Root Mean Squared Error.
- R².
Contoh:
from sklearn.metrics import accuracy_score
Kemudian:
accuracy = accuracy_score(
    y_test,
    y_pred
)
API Scikit-Learn yang Konsisten
Salah satu hal yang penting ketika belajar Scikit-Learn adalah pola API yang relatif konsisten.
Banyak estimator Scikit-Learn menggunakan method:
fit()
predict()
Misalnya:
model.fit(X_train, y_train)
digunakan untuk melatih model.
Kemudian:
y_pred = model.predict(X_test)
digunakan untuk menghasilkan prediksi.
Pola sederhana ini dapat ditemukan pada banyak estimator Scikit-Learn.
Memahami fit()
Method:
fit()
digunakan untuk membuat model belajar dari data.
Contoh:
model.fit(X_train, y_train)
Secara sederhana:
X_train + y_train
        ↓
      fit()
        ↓
Model mempelajari pola
Model akan menggunakan data training untuk menentukan parameter internal yang diperlukan algoritma.
Memahami predict()
Setelah model dilatih, kita dapat menggunakan:
predict()
untuk menghasilkan prediksi.
Contoh:
y_pred = model.predict(X_test)
Secara sederhana:
X_test
  ↓
Model yang sudah dilatih
  ↓
predict()
  ↓
y_pred
y_pred berisi hasil prediksi model.
Pola Dasar Estimator
Banyak model Scikit-Learn mengikuti pola:
model = SomeModel()

model.fit(X_train, y_train)

y_pred = model.predict(X_test)
Contoh menggunakan Decision Tree:
from sklearn.tree import DecisionTreeClassifier

model = DecisionTreeClassifier(
    random_state=42
)

model.fit(
    X_train,
    y_train
)

y_pred = model.predict(X_test)
Pola tersebut akan sering kita temui ketika belajar Machine Learning menggunakan Scikit-Learn.
Workflow Machine Learning dengan Scikit-Learn
Secara umum, workflow Machine Learning dapat digambarkan seperti:
Data
 ↓
Prepare Data
 ↓
Choose Model
 ↓
Fit Model
 ↓
Make Predictions
 ↓
Evaluate
 ↓
Improve
 ↓
Save Model
 ↓
Use in Production
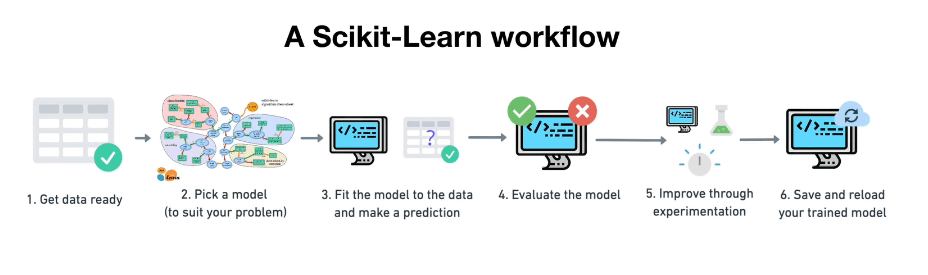
Mari kita bahas satu per satu.
Step 1 - Get Data Ready
Langkah pertama adalah mempersiapkan data.
Data dapat berasal dari:
- CSV.
- Database.
- API.
- Dataset publik.
- Sensor.
- Sistem aplikasi.
Contoh membaca dataset:
import pandas as pd

df = pd.read_csv("data.csv")
Kemudian kita melakukan pemeriksaan:
df.head()
dan:
df.info()
Kita perlu memahami:
- jumlah data,
- tipe data,
- fitur,
- target,
- missing values,
- dan kemungkinan masalah kualitas data.
Step 2 - Menentukan X dan y
Dalam supervised learning, biasanya kita memisahkan:
X = Features
y = Target
Contoh:
X = df.drop("target", axis=1)
y = df["target"]
X berisi fitur yang digunakan model untuk membuat prediksi.
Sedangkan y berisi target yang ingin diprediksi.
Secara sederhana:
X
│
├── Feature 1
├── Feature 2
├── Feature 3
└── Feature 4
        ↓
      Model
        ↓
        y
Step 3 - Membagi Data
Sebelum training, data biasanya dibagi menjadi beberapa subset.
Contoh sederhana:
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42
)
Sekarang kita memiliki:
Training Data
├── X_train
└── y_train

Testing Data
├── X_test
└── y_test
Data training digunakan untuk melatih model.
Data testing digunakan untuk mengevaluasi performa pada data yang tidak digunakan untuk fitting model.
Step 4 - Choose a Model
Selanjutnya kita memilih algoritma yang sesuai.
Misalnya permasalahan kita adalah classification.
Kita dapat mencoba:
from sklearn.ensemble import RandomForestClassifier

model = RandomForestClassifier(
    random_state=42
)
Pemilihan model sebaiknya mempertimbangkan:
- jenis masalah,
- jenis data,
- ukuran dataset,
- karakteristik fitur,
- kebutuhan interpretasi,
- waktu training,
- dan kebutuhan deployment.
Tidak ada satu algoritma yang selalu paling baik untuk semua dataset.
Step 5 - Fit the Model
Setelah model dibuat, kita melatihnya:
model.fit(
    X_train,
    y_train
)
Pada tahap ini model mempelajari pola dari training data.
Secara konsep:
X_train
   +
y_train
   ↓
model.fit()
   ↓
Trained Model
Step 6 - Make Predictions
Setelah model dilatih:
y_pred = model.predict(X_test)
Model menggunakan X_test untuk menghasilkan prediksi.
Sekarang kita memiliki:
y_test
   ↓
Nilai sebenarnya

y_pred
   ↓
Prediksi model
Keduanya dapat dibandingkan untuk mengevaluasi performa.
Step 7 - Evaluate the Model
Untuk classification kita dapat menggunakan accuracy:
from sklearn.metrics import accuracy_score

accuracy = accuracy_score(
    y_test,
    y_pred
)

print(accuracy)
Misalnya hasilnya:
0.85
Artinya accuracy pada data evaluasi adalah 0.85 atau 85%.
Namun, accuracy bukan satu-satunya metric.
Pemilihan metric harus disesuaikan dengan tujuan dan karakteristik permasalahan.
Misalnya pada dataset yang tidak seimbang, accuracy saja dapat memberikan gambaran yang kurang lengkap.
Step 8 - Improve the Model
Model pertama belum tentu memberikan hasil yang sesuai dengan kebutuhan.
Kita dapat melakukan eksperimen.
Contohnya:
Model A
   ↓
Evaluate
   ↓
Model B
   ↓
Evaluate
   ↓
Model C
   ↓
Compare
Kita dapat mencoba:
- model berbeda,
- fitur berbeda,
- preprocessing berbeda,
- hyperparameter berbeda,
- atau teknik validasi yang berbeda.
Hyperparameter Tuning
Hyperparameter adalah pengaturan model yang ditentukan sebelum atau selama proses training, bukan parameter yang dipelajari langsung dari training data.
Contohnya pada Random Forest:
RandomForestClassifier(
    n_estimators=100,
    max_depth=10,
    random_state=42
)
Kita dapat melakukan eksperimen terhadap:
n_estimators
max_depth
dan hyperparameter lainnya.
Scikit-Learn menyediakan tools seperti:
GridSearchCV
dan:
RandomizedSearchCV
untuk membantu pencarian hyperparameter.
Step 9 - Save and Reload the Model
Setelah model selesai dilatih, kita mungkin ingin menyimpannya.
Tujuannya agar model tidak perlu dilatih kembali setiap kali ingin digunakan.
Salah satu pendekatan yang umum adalah menggunakan joblib.
Contoh:
import joblib

joblib.dump(
    model,
    "model.pkl"
)
Kemudian model dapat dimuat kembali:
model = joblib.load(
    "model.pkl"
)
Setelah dimuat, model dapat digunakan untuk prediksi:
y_pred = model.predict(X_new)
Untuk deployment nyata, penyimpanan model perlu mempertimbangkan kompatibilitas versi library, keamanan file model, preprocessing yang digunakan, dan reproducibility.
Workflow Lengkap
Workflow sederhana Scikit-Learn dapat digambarkan sebagai berikut:
                 DATA
                   │
                   ▼
          Get Data Ready
                   │
                   ▼
            Define X and y
                   │
                   ▼
          Split the Dataset
                   │
                   ▼
            Choose Model
                   │
                   ▼
             Fit Model
                   │
                   ▼
          Make Predictions
                   │
                   ▼
          Evaluate Results
                   │
             ┌─────┴─────┐
             │           │
        Satisfactory?    No
             │           │
            Yes          ▼
             │      Improve Model
             │           │
             │           ▼
             │      Tune / Experiment
             │           │
             │           └───────┐
             │                   │
             ▼                   │
         Save Model ◄────────────┘
             │
             ▼
          Production
Workflow tersebut bukan aturan yang selalu identik untuk setiap proyek, tetapi merupakan kerangka berpikir yang berguna ketika memulai proyek Machine Learning.
Contoh Workflow Sederhana
Berikut contoh sederhana menggunakan dataset Iris yang tersedia melalui Scikit-Learn.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score

# Mengambil dataset
iris = load_iris()

X = iris.data
y = iris.target

# Membagi data
X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42
)

# Membuat model
model = RandomForestClassifier(
    random_state=42
)

# Training
model.fit(
    X_train,
    y_train
)

# Prediksi
y_pred = model.predict(X_test)

# Evaluasi
accuracy = accuracy_score(
    y_test,
    y_pred
)

print("Accuracy:", accuracy)
Perhatikan pola utamanya:
Load Data
   ↓
X dan y
   ↓
Train/Test Split
   ↓
Create Model
   ↓
  Fit
   ↓
Predict
   ↓
Evaluate
Pola ini akan muncul berulang kali ketika kita menggunakan Scikit-Learn.
Kelebihan Scikit-Learn
Beberapa alasan Scikit-Learn banyak digunakan dalam pembelajaran dan pengembangan Machine Learning:
API Relatif Konsisten
Banyak estimator menggunakan pola:
model.fit(...)
model.predict(...)
Hal ini membuat proses belajar berbagai algoritma menjadi lebih mudah.
Banyak Algoritma
Kita tidak perlu membuat setiap algoritma dari awal.
Scikit-Learn menyediakan berbagai implementasi yang siap digunakan.
Tools Preprocessing
Scikit-Learn menyediakan berbagai tools untuk:
- scaling,
- encoding,
- imputasi,
- transformasi,
- dan preprocessing lainnya.
Tools Evaluasi
Berbagai metrics dan tools model selection tersedia dalam satu ekosistem.
Cocok untuk Eksperimen
Kita dapat dengan relatif mudah membandingkan beberapa algoritma.
Contoh:
Logistic Regression
    ↓
Evaluate

Random Forest
    ↓
Evaluate

   KNN
    ↓
Evaluate

Decision Tree
    ↓
Evaluate
Hasilnya kemudian dapat dibandingkan berdasarkan metric dan kebutuhan proyek.
Scikit-Learn Bukan Hanya Model
Pemula terkadang menganggap Scikit-Learn hanya digunakan untuk membuat model.
Sebenarnya Scikit-Learn mencakup banyak bagian workflow Machine Learning:
Preprocessing
      ↓
Model Selection
      ↓
  Training
      ↓
 Prediction
      ↓
 Evaluation
      ↓
   Tuning
      ↓
  Pipeline
Karena itu, Scikit-Learn dapat digunakan sebagai bagian penting dari keseluruhan workflow Machine Learning klasik.
Hubungan Scikit-Learn dengan Library Lain
Dalam proyek Machine Learning, beberapa library dapat bekerja bersama.
Contohnya:
                Python
                   │
       ┌───────────┼───────────┐
       │           │           │
     NumPy       Pandas    Matplotlib
       │           │           │
       └───────────┼───────────┘
                   │
             Scikit-Learn
                   │
          Machine Learning
NumPy
Digunakan untuk:
- array,
- operasi numerik,
- manipulasi data numerik.
Pandas
Digunakan untuk:
- DataFrame,
- Series,
- membaca dataset,
- manipulasi data tabular.
Matplotlib
Digunakan untuk:
- visualisasi,
- plotting,
- eksplorasi data.
Scikit-Learn
Digunakan untuk:
- preprocessing,
- model Machine Learning,
- training,
- prediction,
- evaluation,
- model selection.
Tips Belajar Scikit-Learn
Ketika belajar library baru, jangan hanya menghafal syntax.
Cobalah memahami:
Apa fungsi kode ini?
        ↓
Input-nya apa?
        ↓
Output-nya apa?
        ↓
Mengapa kita membutuhkannya?
Contohnya:
model.fit(X_train, y_train)
Jangan hanya menghafal bahwa training menggunakan fit().
Pahami bahwa:
X_train
   +
y_train
   ↓
fit()
   ↓
Model mempelajari pola
Pemahaman seperti ini akan lebih berguna ketika kita menggunakan algoritma yang berbeda.
Prinsip "If in Doubt, Run the Code"
Ketika tidak yakin mengenai perilaku sebuah fungsi, salah satu cara terbaik untuk belajar adalah mencoba menjalankan kode.
Misalnya kita tidak tahu bentuk output:
X_train.shape
Jalankan kode tersebut.
Atau:
model.get_params()
untuk melihat parameter yang tersedia pada estimator tertentu.
Atau:
y_pred[:10]
untuk melihat beberapa hasil prediksi.
Prinsip sederhananya:
Tidak yakin?
    ↓
Coba kode
    ↓
Lihat output
    ↓
Analisis
    ↓
Baca dokumentasi
    ↓
Coba kembali
Eksperimen langsung merupakan bagian penting dari proses belajar Machine Learning.
Menggunakan Jupyter Notebook
Scikit-Learn sangat nyaman digunakan dalam Jupyter Notebook untuk proses eksplorasi.
Contohnya:
model.fit(X_train, y_train)
Kemudian kita dapat langsung melihat:
model
atau:
model.get_params()
atau:
X_train.shape
Notebook memungkinkan kita melakukan eksperimen secara bertahap.
Menggunakan Shift + Tab
Di Jupyter Notebook, kita dapat menggunakan:
Shift + Tab
untuk melihat informasi mengenai fungsi atau method yang sedang digunakan.
Misalnya:
train_test_split(
kemudian tekan:
Shift + Tab
Jupyter dapat menampilkan informasi signature dan dokumentasi singkat dari fungsi tersebut.
Fitur ini sangat membantu ketika kita lupa:
- nama parameter,
- urutan parameter,
- default value,
- atau fungsi dari sebuah parameter.
Namun, untuk memahami penggunaan secara lengkap, tetap biasakan membaca dokumentasi resmi library.
Biasakan Membaca Dokumentasi
Ketika menggunakan Scikit-Learn, dokumentasi merupakan salah satu sumber belajar yang penting.
Jangan hanya bergantung pada contoh kode dari tutorial.
Misalnya ketika menggunakan:
RandomForestClassifier
kita perlu mengetahui:
- parameter yang tersedia,
- default value,
- atribut model,
- method yang tersedia,
- dan bagaimana estimator tersebut bekerja.
Kemampuan membaca dokumentasi merupakan keterampilan penting bagi Data Scientist dan Machine Learning Engineer.
Kesalahan yang Sering Terjadi
Menganggap Semua Model Menggunakan Parameter yang Sama
Tidak semua estimator memiliki parameter yang sama.
Contohnya:
RandomForestClassifier(...)
memiliki hyperparameter yang berbeda dari:
KNeighborsClassifier(...)
Karena itu, periksa dokumentasi estimator yang digunakan.
Menggunakan Data Test untuk Tuning Berulang Kali
Data test sebaiknya dipertahankan sebagai data evaluasi akhir.
Jika kita terus memilih model berdasarkan hasil test set, informasi test set dapat ikut memengaruhi proses pemilihan model.
Untuk eksperimen yang lebih baik, gunakan validation set atau cross-validation untuk proses pemilihan model/hyperparameter, kemudian gunakan test set untuk evaluasi akhir.
Melupakan Preprocessing
Tidak semua data dapat langsung diberikan kepada model.
Misalnya:
Missing Values
Categorical Data
Different Feature Scales
mungkin membutuhkan preprocessing terlebih dahulu.
Tidak Memahami Data
Jangan langsung:
Load Data
↓
Train Model
Biasakan memahami dataset terlebih dahulu.
Lakukan:
Load
↓
Inspect
↓
Clean
↓
Explore
↓
Prepare
↓
Model
Ringkasan
Scikit-Learn merupakan library Machine Learning Python yang menyediakan banyak tools untuk membangun workflow Machine Learning.
Konsep penting yang dipelajari:
- Scikit-Learn digunakan untuk Machine Learning klasik di Python.
- Scikit-Learn menyediakan berbagai algoritma classification, regression, clustering, dan lainnya.
- Scikit-Learn juga menyediakan preprocessing dan model selection.
- Banyak estimator menggunakan pola API seperti
fit()danpredict(). - Data perlu dipersiapkan sebelum digunakan untuk training.
Xbiasanya berisi features.ybiasanya berisi target.- Dataset dapat dibagi menjadi training dan testing.
- Model dilatih menggunakan
fit(). - Model membuat prediksi menggunakan
predict(). - Hasil prediksi dievaluasi menggunakan metrics.
- Model dapat ditingkatkan melalui eksperimen dan hyperparameter tuning.
- Model yang sudah dilatih dapat disimpan dan dimuat kembali.
- Dokumentasi dan eksperimen langsung merupakan bagian penting dalam proses belajar.
Workflow yang Perlu Diingat
Kerangka dasar yang perlu mulai kita biasakan:
1. Get Data Ready
       ↓
2. Define X and y
       ↓
3. Split Data
       ↓
4. Choose Model
       ↓
5. Fit Model
       ↓
6. Make Predictions
       ↓
7. Evaluate
       ↓
8. Improve
       ↓
9. Save Model
       ↓
10. Use Model
Tidak semua proyek harus mengikuti urutan tersebut secara persis, tetapi workflow ini dapat menjadi kerangka dasar untuk memahami bagaimana Scikit-Learn digunakan dalam proyek Machine Learning.