Hyperparameter Tuning dengan GridSearchCV
Pada materi sebelumnya kita telah mempelajari RandomizedSearchCV, yaitu metode hyperparameter tuning yang mencoba sejumlah kombinasi hyperparameter secara acak.
Pada materi ini kita akan mempelajari GridSearchCV.
Perbedaan utama keduanya adalah:
RandomizedSearchCV
        │
        ├── Memilih kombinasi secara acak
        └── Jumlah percobaan ditentukan oleh n_iter

GridSearchCV
        │
        ├── Mencoba seluruh kombinasi
        └── Tidak menggunakan n_iter
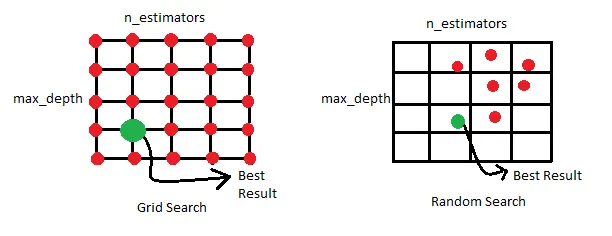
Dengan kata lain, GridSearchCV melakukan exhaustive search atau pencarian menyeluruh terhadap kombinasi hyperparameter yang kita berikan.
Apa Itu GridSearchCV?
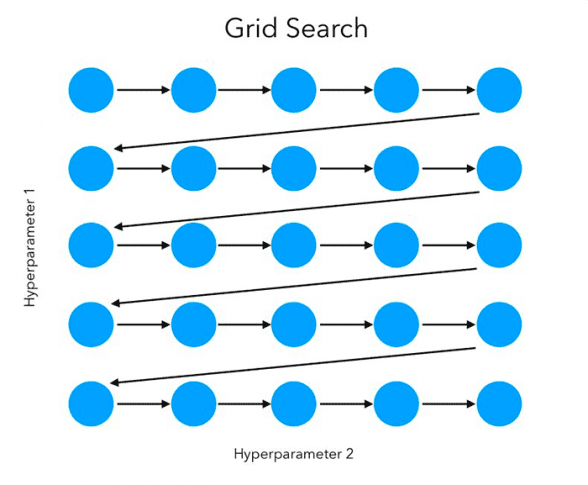
GridSearchCV adalah metode dari Scikit-Learn yang digunakan untuk melakukan hyperparameter tuning dengan mencoba setiap kombinasi hyperparameter yang tersedia di dalam parameter grid.
Contoh:
grid = {
    "n_estimators": [100, 200],
    "max_depth": [10, 20]
}
Maka kombinasi yang akan dicoba adalah:
n_estimators = 100, max_depth = 10
n_estimators = 100, max_depth = 20
n_estimators = 200, max_depth = 10
n_estimators = 200, max_depth = 20
Total:
2 × 2 = 4 kombinasi
Jika menggunakan:
cv=5
maka setiap kombinasi akan dievaluasi sebanyak 5 fold:
4 kombinasi × 5 fold
= 20 fits
RandomizedSearchCV vs GridSearchCV
Perbedaan utama:
| Aspek | RandomizedSearchCV | GridSearchCV |
|---|---|---|
| Pencarian | Acak | Semua kombinasi |
| Parameter jumlah percobaan | n_iter | Tidak ada |
| Cross-validation | Ya | Ya |
| Efisien pada grid besar | Lebih efisien | Bisa sangat mahal |
| Mencoba seluruh kombinasi | Tidak | Ya |
| Cocok untuk | Eksplorasi luas | Fine-tuning |
| Hasil terbaik | Terbaik dari kombinasi yang dicoba | Terbaik dari seluruh grid |
Secara sederhana:
RandomizedSearchCV
→ "Coba beberapa kombinasi yang dipilih secara acak."

GridSearchCV
→ "Coba semua kombinasi yang saya berikan."
Mengapa GridSearchCV Bisa Mahal?
GridSearchCV dapat membutuhkan komputasi yang besar karena jumlah eksperimen merupakan perkalian dari seluruh pilihan hyperparameter.
Misalnya kita memiliki:
grid = {
    "n_estimators": [10, 100, 200, 500, 1000, 1200],
    "max_depth": [None, 5, 10, 20, 30],
    "max_features": ["sqrt", "log2"],
    "min_samples_split": [2, 4, 6],
    "min_samples_leaf": [1, 2, 4]
}
Jumlah pilihan:
n_estimators
= 6

max_depth
= 5

max_features
= 2

min_samples_split
= 3

min_samples_leaf
= 3
Jumlah kombinasi:
6 × 5 × 2 × 3 × 3
= 540 kombinasi
Jika menggunakan:
cv=5
maka:
540 × 5
= 2.700 fits
Artinya, GridSearchCV harus melakukan ribuan proses training dan evaluasi.
Pada dataset dan model yang lebih besar, proses seperti ini dapat membutuhkan waktu dan resource yang signifikan.
Memahami Konsep Search Space
Search space adalah seluruh kemungkinan nilai hyperparameter yang ingin kita eksplorasi.
Misalnya:
grid = {
    "n_estimators": [100, 200, 500],
    "max_depth": [10, 20, 30]
}
Maka search space terdiri dari:
3 × 3 = 9 kombinasi
Semakin banyak parameter dan pilihan nilainya, semakin besar search space.
Sedikit parameter
       ↓
Search space kecil
       ↓
GridSearchCV relatif cepat


Banyak parameter
       ↓
Search space besar
       ↓
GridSearchCV dapat menjadi sangat lambat
Strategi yang Lebih Efisien
Daripada langsung memberikan search space yang sangat besar kepada GridSearchCV, kita dapat menggunakan pendekatan bertahap.
Workflow yang umum:
Manual Tuning
      │
      ▼
RandomizedSearchCV
      │
      ▼
Menemukan area parameter yang menjanjikan
      │
      ▼
Mempersempit Search Space
      │
      ▼
 GridSearchCV
      │
      ▼
 Fine-Tuning
Dengan strategi ini, GridSearchCV digunakan pada ruang pencarian yang lebih kecil dan lebih terarah.
Menggunakan Hasil RandomizedSearchCV
Pada materi sebelumnya kita menggunakan:
rs_clf.best_params_
untuk melihat kombinasi hyperparameter terbaik yang ditemukan oleh RandomizedSearchCV.
Misalnya:
rs_clf.best_params_
menghasilkan:
{
    "n_estimators": 200,
    "min_samples_split": 6,
    "min_samples_leaf": 2,
    "max_features": "sqrt",
    "max_depth": None
}
Hasil tersebut dapat menjadi petunjuk untuk mempersempit search space.
Membuat Grid Kedua
Misalnya kita ingin melakukan fine-tuning di sekitar parameter yang telah ditemukan.
Kita dapat membuat:
grid_2 = {
    "n_estimators": [100, 200, 500],
    "max_depth": [None],
    "max_features": ["sqrt"],
    "min_samples_split": [6],
    "min_samples_leaf": [1, 2]
}
Search space sekarang jauh lebih kecil.
Jumlah kombinasi:
n_estimators
= 3

max_depth
= 1

max_features
= 1

min_samples_split
= 1

min_samples_leaf
= 2
Maka:
3 × 1 × 1 × 1 × 2
= 6 kombinasi
Dengan:
cv=5
jumlah fits:
6 × 5
= 30 fits
Bandingkan dengan search space awal:
540 kombinasi
× 5 fold
= 2.700 fits
Dengan mempersempit grid, proses menjadi jauh lebih ringan.
Catatan tentang Search Space
Mempersempit search space bukan berarti kita harus selalu menggunakan tepat satu nilai untuk semua parameter.
Tujuannya adalah memfokuskan pencarian pada area yang masuk akal berdasarkan hasil eksperimen sebelumnya.
Contohnya, jika RandomizedSearchCV menemukan:
n_estimators = 200
kita dapat melakukan fine-tuning:
"n_estimators": [100, 150, 200, 250, 300]
Dengan demikian kita masih mengeksplorasi nilai di sekitar kandidat terbaik.
Menyiapkan Dataset
Kita menggunakan dataset Heart Disease seperti pada materi sebelumnya.
Dataset terlebih dahulu diacak:
heart_disease_shuffled = heart_disease.sample(
    frac=1,
    random_state=42
)
Kemudian pisahkan feature dan target:
X = heart_disease_shuffled.drop(
    "target",
    axis=1
)

y = heart_disease_shuffled["target"]
Membagi Data Training dan Test
Karena GridSearchCV menggunakan cross-validation pada training data, kita tidak perlu membuat validation set secara manual.
Gunakan:
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42,
    stratify=y
)
Struktur datanya:
Dataset
   │
   ├── Training Set 80%
   │       │
   │       └── GridSearchCV
   │               │
   │               └── Cross-Validation
   │
   └── Test Set 20%
           │
           └── Final Evaluation
Test set tetap disimpan dan tidak digunakan untuk mencari hyperparameter.
Membuat RandomForestClassifier
Import:
from sklearn.ensemble import RandomForestClassifier
Kemudian buat model:
clf = RandomForestClassifier(
    n_jobs=-1,
    random_state=42
)
n_jobs
n_jobs menentukan jumlah CPU core yang digunakan.
n_jobs=1
menggunakan satu core.
Sedangkan:
n_jobs=-1
menggunakan seluruh core yang tersedia.
Untuk eksperimen yang cukup berat, penggunaan:
n_jobs=-1
dapat mempercepat proses, tetapi juga meningkatkan penggunaan CPU.
Membuat GridSearchCV
Import:
from sklearn.model_selection import GridSearchCV
Kemudian:
gs_clf = GridSearchCV(
    estimator=clf,
    param_grid=grid_2,
    cv=5,
    verbose=2,
    n_jobs=-1
)
Parameter penting:
| Parameter | Fungsi |
|---|---|
estimator | Model yang akan dituning |
param_grid | Dictionary hyperparameter |
cv | Jumlah fold cross-validation |
verbose | Menampilkan informasi proses |
n_jobs | Jumlah CPU core yang digunakan |
scoring | Metric yang digunakan untuk memilih model |
Perbedaan param_grid dan param_distributions
Perhatikan bahwa:
RandomizedSearchCV(
    param_distributions=grid
)
menggunakan:
param_distributions
Sedangkan:
GridSearchCV(
    param_grid=grid_2
)
menggunakan:
param_grid
Hal ini karena keduanya memiliki mekanisme pencarian yang berbeda.
RandomizedSearchCV
RandomizedSearchCV(
    estimator=clf,
    param_distributions=grid
)
GridSearchCV
GridSearchCV(
    estimator=clf,
    param_grid=grid_2
)
Melatih GridSearchCV
Setelah semua konfigurasi siap:
gs_clf.fit(
    X_train,
    y_train
)
GridSearchCV kemudian akan:
- Membaca seluruh parameter pada
param_grid. - Membuat seluruh kombinasi.
- Membagi training data menggunakan cross-validation.
- Melatih model pada setiap fold.
- Menghitung scoring.
- Membandingkan semua hasil.
- Menentukan kombinasi terbaik.
Contoh Proses GridSearchCV
Misalnya:
grid_2 = {
    "n_estimators": [100, 200],
    "max_depth": [10, 20]
}
GridSearchCV akan mencoba:
Combination 1
n_estimators = 100
max_depth = 10

Combination 2
n_estimators = 100
max_depth = 20

Combination 3
n_estimators = 200
max_depth = 10

Combination 4
n_estimators = 200
max_depth = 20
Jika:
cv=5
maka setiap kombinasi dijalankan 5 kali:
4 kombinasi × 5 fold
= 20 fits
Melihat Parameter Terbaik
Setelah proses selesai:
gs_clf.best_params_
Misalnya:
{
    "max_depth": 20,
    "max_features": "sqrt",
    "min_samples_leaf": 1,
    "min_samples_split": 6,
    "n_estimators": 200
}
Parameter tersebut merupakan kombinasi terbaik berdasarkan scoring yang digunakan dalam GridSearchCV.
Melihat Best Score
Gunakan:
gs_clf.best_score_
Contoh:
0.84
Nilai tersebut adalah skor cross-validation terbaik yang diperoleh dari seluruh kombinasi dalam grid.
Ingat:
best_score_
    ↓
Training data + Cross-Validation
bukan:
best_score_
    ↓
Test set
Membuat Prediksi
Gunakan:
gs_y_preds = gs_clf.predict(
    X_test
)
GridSearchCV secara default menggunakan estimator dengan parameter terbaik untuk melakukan prediksi.
Evaluasi Model
Jika kita telah memiliki fungsi evaluate_preds():
gs_metrics = evaluate_preds(
    y_test,
    gs_y_preds
)
Contoh fungsi:
from sklearn.metrics import (
    accuracy_score,
    precision_score,
    recall_score,
    f1_score
)


def evaluate_preds(y_true, y_preds):
    accuracy = accuracy_score(
        y_true,
        y_preds
    )

    precision = precision_score(
        y_true,
        y_preds
    )

    recall = recall_score(
        y_true,
        y_preds
    )

    f1 = f1_score(
        y_true,
        y_preds
    )

    metric_dict = {
        "accuracy": round(accuracy, 2),
        "precision": round(precision, 2),
        "recall": round(recall, 2),
        "f1": round(f1, 2)
    }

    return metric_dict
Kemudian:
gs_metrics = evaluate_preds(
    y_test,
    gs_y_preds
)

gs_metrics
Menentukan Scoring
Secara default, GridSearchCV menggunakan .score() dari estimator.
Untuk RandomForestClassifier, .score() menggunakan accuracy.
Namun, kita dapat menentukan metric secara eksplisit:
gs_clf = GridSearchCV(
    estimator=clf,
    param_grid=grid_2,
    cv=5,
    scoring="f1",
    verbose=2,
    n_jobs=-1
)
Sekarang parameter terbaik dipilih berdasarkan F1-score.
Pilihan metric harus disesuaikan dengan tujuan problem.
Contoh:
scoring="accuracy"
untuk fokus pada accuracy.
scoring="precision"
untuk fokus pada precision.
scoring="recall"
untuk fokus pada recall.
scoring="f1"
untuk menyeimbangkan precision dan recall.
scoring="roc_auc"
untuk mengevaluasi kemampuan model membedakan kelas berdasarkan ranking skor prediksi.
Melihat Semua Hasil GridSearchCV
GridSearchCV menyimpan hasil eksperimen pada:
gs_clf.cv_results_
Kita dapat mengubahnya menjadi DataFrame:
import pandas as pd

results = pd.DataFrame(
    gs_clf.cv_results_
)
Kemudian:
results.head()
akan menampilkan hasil eksperimen.
Melihat Ranking Semua Kombinasi
Kita dapat melihat kombinasi terbaik dengan:
results[
    [
        "params",
        "mean_test_score",
        "std_test_score",
        "rank_test_score"
    ]
].sort_values(
    "rank_test_score"
)
Contoh:
| params | mean_test_score | std_test_score | rank_test_score |
|---|---|---|---|
| Kombinasi A | 0.84 | 0.03 | 1 |
| Kombinasi B | 0.83 | 0.04 | 2 |
| Kombinasi C | 0.82 | 0.05 | 3 |
rank_test_score=1 menunjukkan konfigurasi dengan ranking terbaik.
Membandingkan Model
Setelah melakukan beberapa eksperimen, kita dapat membandingkan hasilnya.
Misalnya kita memiliki:
baseline_metrics
clf_2_metrics
rs_metrics
gs_metrics
Masing-masing berisi:
{
    "accuracy": ...,
    "precision": ...,
    "recall": ...,
    "f1": ...
}
Buat DataFrame:
compare_metrics = pd.DataFrame({
    "baseline": baseline_metrics,
    "clf_2": clf_2_metrics,
    "random search": rs_metrics,
    "grid search": gs_metrics
})
Kemudian tampilkan:
compare_metrics
Membuat Bar Chart Perbandingan
Kita dapat membuat grafik:
compare_metrics.plot.bar(
    figsize=(10, 8)
)
Jika menggunakan Jupyter Notebook:
import matplotlib.pyplot as plt

compare_metrics.plot.bar(
    figsize=(10, 8)
)

plt.ylabel("Score")
plt.xlabel("Metrics")
plt.title("Comparison of Model Performance")
plt.xticks(rotation=0)
plt.legend(title="Model")
plt.show()
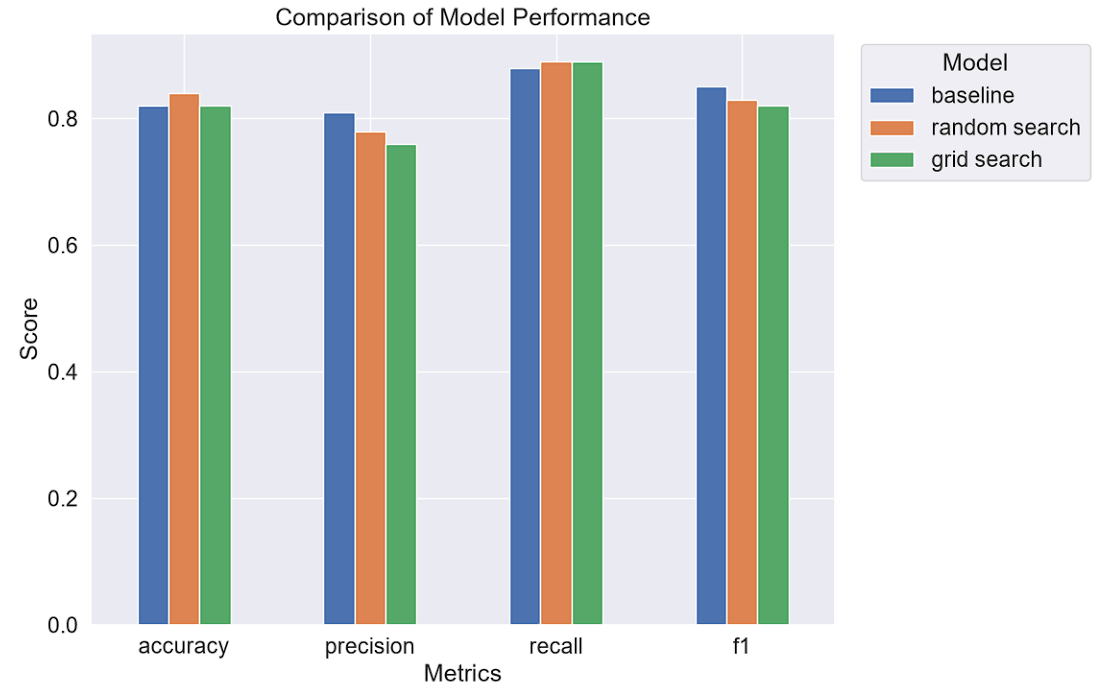
Grafik tersebut membantu kita melihat perbedaan performa antar eksperimen.
Membaca Hasil Perbandingan
Misalnya diperoleh:
| Metric | Baseline | Model 2 | Random Search | Grid Search |
|---|---|---|---|---|
| Accuracy | 0.80 | 0.81 | 0.83 | 0.84 |
| Precision | 0.79 | 0.81 | 0.82 | 0.83 |
| Recall | 0.82 | 0.80 | 0.84 | 0.82 |
| F1 | 0.80 | 0.80 | 0.83 | 0.82 |
Kita tidak boleh langsung menyimpulkan bahwa GridSearchCV selalu lebih baik hanya karena accuracy lebih tinggi.
Perhatikan tujuan problem.
Jika recall adalah metric utama, maka:
Random Search
Recall = 0.84
lebih menarik daripada:
Grid Search
Recall = 0.82
Walaupun Grid Search memiliki accuracy yang lebih tinggi.
Memilih Model Berdasarkan Tujuan
Pemilihan model harus berdasarkan kebutuhan.
Jika fokus pada Accuracy
Pilih model dengan accuracy terbaik.
Jika fokus pada Precision
Pilih model dengan precision terbaik.
Jika fokus pada Recall
Pilih model dengan recall terbaik.
Jika ingin keseimbangan Precision dan Recall
Gunakan F1-score sebagai salah satu pertimbangan.
Metric utama
      │
      ▼
Tujuan bisnis / penelitian
      │
      ▼
Pilih model
Tidak ada aturan bahwa model dengan accuracy tertinggi selalu merupakan model terbaik.
Workflow Hyperparameter Tuning
Workflow yang telah kita pelajari dapat digambarkan sebagai berikut:
Baseline Model
      │
      ▼
Manual Tuning
      │
      ▼
RandomizedSearchCV
      │
      ▼
Menemukan Area yang Menjanjikan
      │
      ▼
Persempit Search Space
      │
      ▼
GridSearchCV
      │
      ▼
Fine-Tuning
      │
      ▼
Evaluasi Test Set
      │
      ▼
Pilih Model Final
Ini merupakan pendekatan yang lebih terstruktur dibandingkan mencoba hyperparameter secara acak tanpa strategi.
Manual Tuning vs RandomizedSearchCV vs GridSearchCV
Ketiga metode memiliki peran berbeda.
| Metode | Tujuan |
|---|---|
| Manual Tuning | Memahami pengaruh hyperparameter |
| RandomizedSearchCV | Eksplorasi ruang pencarian yang luas |
| GridSearchCV | Fine-tuning pada ruang pencarian yang lebih kecil |
Secara sederhana:
Manual
  ↓
Belajar dan eksplorasi

RandomizedSearchCV
  ↓
Eksplorasi cepat

GridSearchCV
  ↓
Pencarian detail
Full Code GridSearchCV
Berikut contoh lengkap yang menggabungkan persiapan data, GridSearchCV, evaluasi, dan perbandingan model.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

from sklearn.model_selection import (
    train_test_split,
    GridSearchCV
)

from sklearn.ensemble import RandomForestClassifier

from sklearn.metrics import (
    accuracy_score,
    precision_score,
    recall_score,
    f1_score
)


# ==========================================
# 1. Shuffle data
# ==========================================

heart_disease_shuffled = heart_disease.sample(
    frac=1,
    random_state=42
)


# ==========================================
# 2. Separate features and target
# ==========================================

X = heart_disease_shuffled.drop(
    "target",
    axis=1
)

y = heart_disease_shuffled["target"]


# ==========================================
# 3. Train-test split
# ==========================================

X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42,
    stratify=y
)


# ==========================================
# 4. Grid yang sudah dipersempit
# ==========================================

grid_2 = {
    "n_estimators": [100, 200, 500],
    "max_depth": [None],
    "max_features": ["sqrt"],
    "min_samples_split": [6],
    "min_samples_leaf": [1, 2]
}


# ==========================================
# 5. Create model
# ==========================================

clf = RandomForestClassifier(
    n_jobs=-1,
    random_state=42
)


# ==========================================
# 6. Create GridSearchCV
# ==========================================

gs_clf = GridSearchCV(
    estimator=clf,
    param_grid=grid_2,
    cv=5,
    verbose=2,
    n_jobs=-1
)


# ==========================================
# 7. Fit GridSearchCV
# ==========================================

gs_clf.fit(
    X_train,
    y_train
)


# ==========================================
# 8. Best parameters
# ==========================================

print("Best parameters:")
print(gs_clf.best_params_)


# ==========================================
# 9. Best cross-validation score
# ==========================================

print("Best CV score:")
print(gs_clf.best_score_)


# ==========================================
# 10. Prediction
# ==========================================

gs_y_preds = gs_clf.predict(
    X_test
)


# ==========================================
# 11. Evaluation
# ==========================================

gs_metrics = {
    "accuracy": accuracy_score(
        y_test,
        gs_y_preds
    ),
    "precision": precision_score(
        y_test,
        gs_y_preds
    ),
    "recall": recall_score(
        y_test,
        gs_y_preds
    ),
    "f1": f1_score(
        y_test,
        gs_y_preds
    )
}

print("Grid Search metrics:")
print(gs_metrics)


# ==========================================
# 12. View CV results
# ==========================================

results = pd.DataFrame(
    gs_clf.cv_results_
)

print(
    results[
        [
            "params",
            "mean_test_score",
            "std_test_score",
            "rank_test_score"
        ]
    ].sort_values(
        "rank_test_score"
    )
)
Contoh Full Workflow Perbandingan
Jika kita telah memiliki hasil dari beberapa eksperimen:
compare_metrics = pd.DataFrame({
    "baseline": baseline_metrics,
    "clf_2": clf_2_metrics,
    "random search": rs_metrics,
    "grid search": gs_metrics
})
Tampilkan:
print(compare_metrics)
Kemudian visualisasikan:
compare_metrics.plot.bar(
    figsize=(10, 8)
)

plt.ylabel("Score")
plt.xlabel("Metrics")
plt.title("Machine Learning Model Comparison")
plt.xticks(rotation=0)
plt.legend(title="Model")
plt.show()
Hasil tersebut dapat digunakan untuk membantu menentukan model yang paling sesuai dengan tujuan eksperimen.
Hal Penting: GridSearchCV Bukan Jaminan Model Terbaik
GridSearchCV memang mencoba seluruh kombinasi yang diberikan.
Namun, bukan berarti:
GridSearchCV
     ↓
Pasti menghasilkan model terbaik secara universal
GridSearchCV hanya dapat memilih:
kombinasi terbaik dari search space yang kita berikan berdasarkan scoring dan cross-validation yang digunakan.
Misalnya:
grid = {
    "max_depth": [5, 10]
}
GridSearchCV tidak akan mengetahui bahwa:
max_depth = 20
mungkin lebih baik karena nilai tersebut tidak ada dalam grid.
Oleh karena itu, kualitas search space tetap sangat penting.
Search Space yang Baik
Search space harus:
- Relevan dengan model.
- Memiliki nilai yang masuk akal.
- Tidak terlalu kecil.
- Tidak terlalu besar.
- Berdasarkan eksperimen sebelumnya jika memungkinkan.
Contoh:
grid_2 = {
    "n_estimators": [100, 200, 500],
    "max_depth": [10, 20, 30],
    "min_samples_split": [2, 4, 6]
}
lebih terarah daripada memberikan ratusan nilai yang tidak relevan.
Jangan Terlalu Sering Menggunakan Test Set
Salah satu kesalahan umum dalam eksperimen machine learning adalah terus melihat test set kemudian mengubah model berdasarkan hasil test tersebut.
Workflow yang lebih baik:
Training Data
      │
      ▼
Cross-Validation
      │
      ▼
Hyperparameter Tuning
      │
      ▼
Model Selection
      │
      ▼
Final Test Evaluation
Test set sebaiknya digunakan sebagai evaluasi final terhadap model yang telah dipilih.
Kelebihan GridSearchCV
Beberapa kelebihan GridSearchCV:
- Mencoba seluruh kombinasi dalam grid.
- Sistematis.
- Mudah digunakan dengan Scikit-Learn.
- Terintegrasi dengan cross-validation.
- Dapat menggunakan berbagai scoring metric.
- Menyediakan
best_params_. - Menyediakan
best_score_. - Menyediakan
cv_results_. - Dapat digunakan untuk berbagai estimator Scikit-Learn.
Kekurangan GridSearchCV
GridSearchCV juga memiliki beberapa kekurangan:
- Dapat sangat mahal secara komputasi.
- Jumlah eksperimen meningkat secara perkalian.
- Search space yang terlalu besar dapat membuat proses sangat lama.
- Tidak menjamin parameter di luar grid tidak lebih baik.
- Membutuhkan strategi dalam menentukan parameter grid.
Contoh:
6 × 5 × 2 × 3 × 3
= 540 kombinasi
Dengan:
5-fold CV
menjadi:
2.700 fits
Karena itu, jangan langsung membuat grid yang sangat besar tanpa memperhitungkan resource.
Membandingkan Model Harus dengan Data Split yang Sama
Pada materi sebelumnya, kita membandingkan hasil metric dari beberapa model. Namun, terdapat satu hal penting yang perlu diperhatikan:
Saat membandingkan model, pastikan semua model menggunakan data split yang sama.
Misalnya kita memiliki model_1 dan model_2. Keduanya harus dilatih menggunakan data training yang sama dan membuat prediksi pada data test yang sama.
model_1.fit(X_train, y_train)
model_1_preds = model_1.predict(X_test)

model_2.fit(X_train, y_train)
model_2_preds = model_2.predict(X_test)
Kemudian hasilnya dapat dibandingkan:
model_1_metrics = evaluate_preds(
    y_test,
    model_1_preds
)

model_2_metrics = evaluate_preds(
    y_test,
    model_2_preds
)
Perhatikan bahwa:
Model 1 ──► X_train, y_train ──► X_test ──► model_1_preds

Model 2 ──► X_train, y_train ──► X_test ──► model_2_preds
Yang berbeda adalah model dan hasil prediksinya.
Yang harus sama adalah:
X_trainy_trainX_testy_test- prosedur evaluasi dan metric
Mengapa Penting?
Jika setiap model menggunakan data split yang berbeda, misalnya:
Model 1 → Test Set A
Model 2 → Test Set B
maka hasil metric tidak sepenuhnya dapat dibandingkan secara adil. Model bisa saja mendapatkan test set yang lebih mudah atau lebih sulit.
Pada contoh sebelumnya, baseline model menggunakan data split yang berbeda dari model lainnya. Akibatnya, perbandingan metric belum sepenuhnya valid.
Jadi, prinsip pentingnya adalah:
Untuk membandingkan model secara adil, gunakan data split yang sama dan hanya ubah model atau hyperparameter yang ingin dibandingkan.
Materi selengkapnya dibahas pada Membandingkan Model pada Data Split yang Sama.
Checklist
Sebelum menjalankan GridSearchCV, pastikan:
- Dataset sudah dibersihkan.
- Feature dan target sudah dipisahkan.
- Training dan test set sudah dipisahkan.
- Test set tidak digunakan untuk tuning.
- Search space sudah ditentukan.
- Jumlah kombinasi sudah dihitung.
- Nilai
cvsudah ditentukan. -
scoringsesuai dengan tujuan problem. -
random_statedigunakan jika diperlukan. -
n_jobsdisesuaikan dengan resource. - Hasil cross-validation diperiksa.
- Model final dievaluasi pada test set.
Ringkasan
GridSearchCV melakukan pencarian hyperparameter dengan mencoba seluruh kombinasi yang tersedia di dalam param_grid.
Konsep dasarnya:
Parameter Grid
      │
      ▼
Semua Kombinasi
      │
      ▼
Cross-Validation
      │
      ▼
   Scoring
      │
      ▼
Best Parameters
      │
      ▼
  Best Model
Jika terdapat:
6 × 5 × 2 × 3 × 3
kombinasi, maka:
540 kombinasi
Dengan:
cv=5
menjadi:
2.700 fits
Karena itu, strategi yang baik adalah:
Manual Tuning
      ↓
RandomizedSearchCV
      ↓
Persempit Search Space
      ↓
GridSearchCV
      ↓
Final Evaluation
Dengan strategi tersebut, RandomizedSearchCV digunakan untuk eksplorasi, sedangkan GridSearchCV digunakan untuk fine-tuning pada area yang lebih terarah.
Kesimpulan
Hyperparameter tuning merupakan proses eksperimental untuk mencari konfigurasi model yang memberikan performa sesuai dengan tujuan problem.
GridSearchCV sangat berguna ketika kita sudah memiliki search space yang relatif kecil dan ingin mengevaluasi seluruh kombinasi secara sistematis.
Namun, semakin besar search space, semakin besar pula biaya komputasinya.
Oleh karena itu, jangan hanya bertanya:
"Parameter mana yang menghasilkan accuracy tertinggi?"
Tetapi pertimbangkan juga:
- Metric apa yang paling penting?
- Apakah model generalize dengan baik?
- Apakah terdapat overfitting?
- Berapa biaya komputasinya?
- Apakah performa test set benar-benar meningkat?
- Apakah model sesuai dengan tujuan penelitian atau bisnis?
Pada akhirnya, model terbaik bukan selalu model dengan satu metric tertinggi, tetapi model yang paling sesuai dengan tujuan dan constraint dari problem yang sedang diselesaikan.
Langkah Berikutnya
Setelah menemukan model dan hyperparameter yang baik, langkah berikutnya adalah menyimpan dan mengekspor model Machine Learning.
Dengan menyimpan model, kita tidak perlu melakukan training dan hyperparameter tuning kembali setiap kali aplikasi dijalankan.
Workflow selanjutnya:
Data
  ↓
Training
  ↓
Model Selection
  ↓
Hyperparameter Tuning
  ↓
Best Model
  ↓
Save / Export Model
  ↓
Load Model
  ↓
Prediction
Pada tahap ini kita mulai mendekati workflow Machine Learning yang digunakan dalam aplikasi nyata dan deployment.
Referensi
- https://scikit-learn.org/stable/modules/generated/sklearn.model_selection.GridSearchCV.html
- https://pyimagesearch.com/2021/05/24/grid-search-hyperparameter-tuning-with-scikit-learn-gridsearchcv/
- https://towardsdatascience.com/gridsearch-vs-randomizedsearch-vs-bayesiansearch-cfa76de27c6b/
- https://medium.com/@priya38/hyperparameter-tuning-using-gridsearchcv-and-randomsearchcv-d43b58f83a81
- https://inria.github.io/scikit-learn-mooc/python_scripts/parameter_tuning_randomized_search.html
- https://scikit-learn.org/stable/modules/cross_validation.html