Evaluasi Model: Cross-Validation
Pada materi sebelumnya kita telah mempelajari metode .score() untuk mengevaluasi model Machine Learning.
Contohnya:
clf.score(X_test, y_test)
Cara tersebut sederhana dan berguna untuk mendapatkan gambaran awal performa model.
Namun, evaluasi menggunakan satu kali train-test split memiliki keterbatasan. Hasil evaluasi dapat dipengaruhi oleh bagaimana data kebetulan terbagi menjadi training set dan test set.
Untuk mendapatkan evaluasi yang lebih robust, kita dapat menggunakan Cross-Validation.
Pada materi ini kita akan mempelajari:
- Apa itu Cross-Validation
- Perbedaan
.score()dancross_val_score() - Konsep K-Fold Cross-Validation
- Cara kerja 5-Fold Cross-Validation
- Parameter
cv - Parameter
scoring - Menghitung rata-rata hasil Cross-Validation
- Memahami variasi skor antar-fold
- Menghindari data leakage dalam Cross-Validation
- Kapan Cross-Validation digunakan
Mengapa Kita Membutuhkan Cross-Validation?
Misalnya kita memiliki dataset:
100 data
Kemudian kita menggunakan:
train_test_split(
    X,
    y,
    test_size=0.2
)
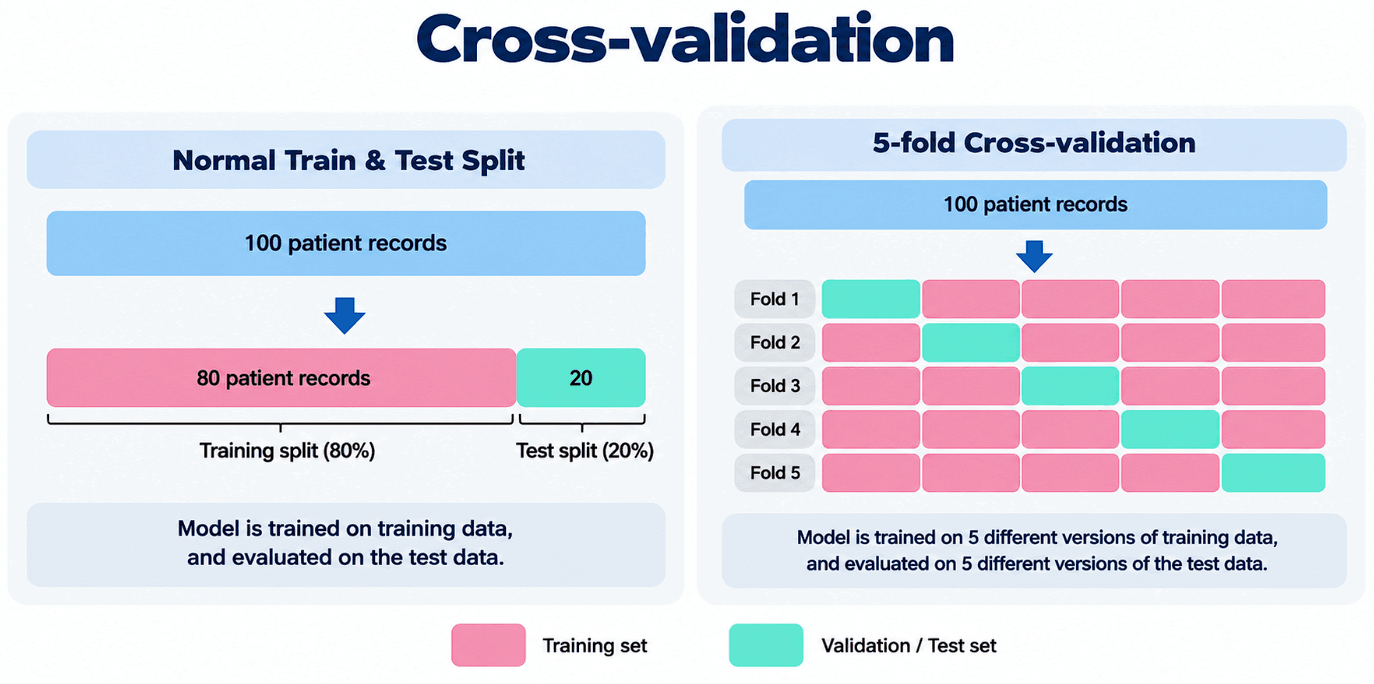
Data akan dibagi menjadi:
80 data → Training
20 data → Test
Model kemudian dilatih pada 80 data dan dievaluasi pada 20 data.
Masalahnya adalah:
Bagaimana jika 20 data tersebut secara kebetulan terlalu mudah atau terlalu sulit untuk diprediksi?
Hasil evaluasi dapat berubah apabila pembagian data berubah.
Contoh Lucky Split
Bayangkan kita melakukan tiga kali pembagian data.
Split A → Test Score = 0.91
Split B → Test Score = 0.79
Split C → Test Score = 0.84
Model yang sama dapat menghasilkan skor berbeda karena data test yang digunakan berbeda.
Kondisi ketika satu pembagian data secara kebetulan menghasilkan hasil yang sangat berbeda sering disebut secara informal sebagai lucky split atau unlucky split.
Cross-Validation membantu kita melihat performa model pada beberapa pembagian data sehingga evaluasi tidak hanya bergantung pada satu split.
Apa Itu Cross-Validation?
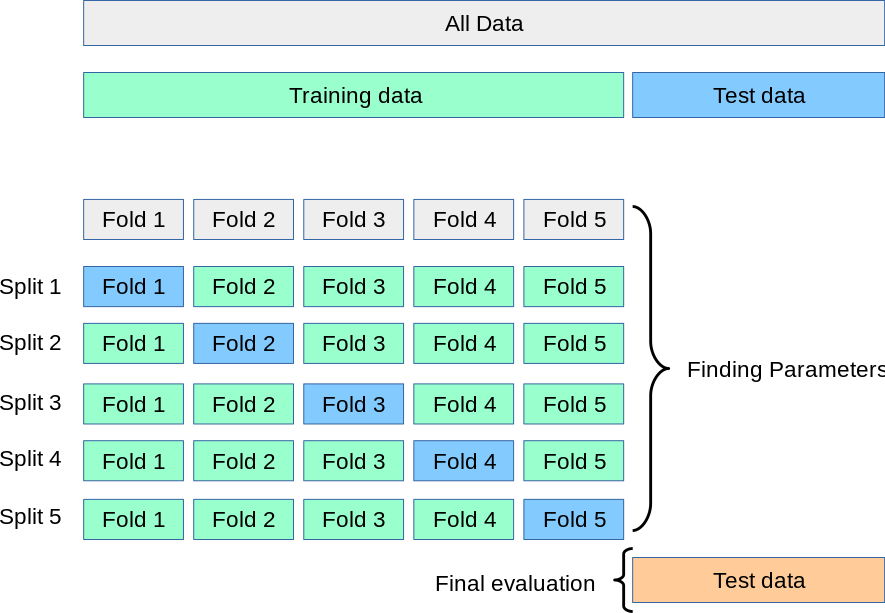
Cross-Validation adalah teknik evaluasi yang membagi data menjadi beberapa bagian atau fold.
Model kemudian dilatih dan dievaluasi beberapa kali.
Setiap iterasi menggunakan fold yang berbeda sebagai validation set.
Contohnya menggunakan:
5-Fold Cross-Validation
Data dibagi menjadi:
Fold 1
Fold 2
Fold 3
Fold 4
Fold 5
Kemudian setiap fold mendapat kesempatan menjadi data validasi.
K-Fold Cross-Validation
Misalnya:
cv = 5
Maka digunakan 5 folds.
Secara konseptual:
Fold 1
Fold 2
Fold 3
Fold 4
Fold 5
Proses evaluasi dilakukan sebanyak 5 kali.
Iterasi 1
Validation → Fold 1
Training   → Fold 2 + Fold 3 + Fold 4 + Fold 5
Iterasi 2
Validation → Fold 2
Training   → Fold 1 + Fold 3 + Fold 4 + Fold 5
Iterasi 3
Validation → Fold 3
Training   → Fold 1 + Fold 2 + Fold 4 + Fold 5
Iterasi 4
Validation → Fold 4
Training   → Fold 1 + Fold 2 + Fold 3 + Fold 5
Iterasi 5
Validation → Fold 5
Training   → Fold 1 + Fold 2 + Fold 3 + Fold 4
Setiap fold digunakan sebagai validation set tepat satu kali.
Visualisasi 5-Fold Cross-Validation
Secara sederhana:
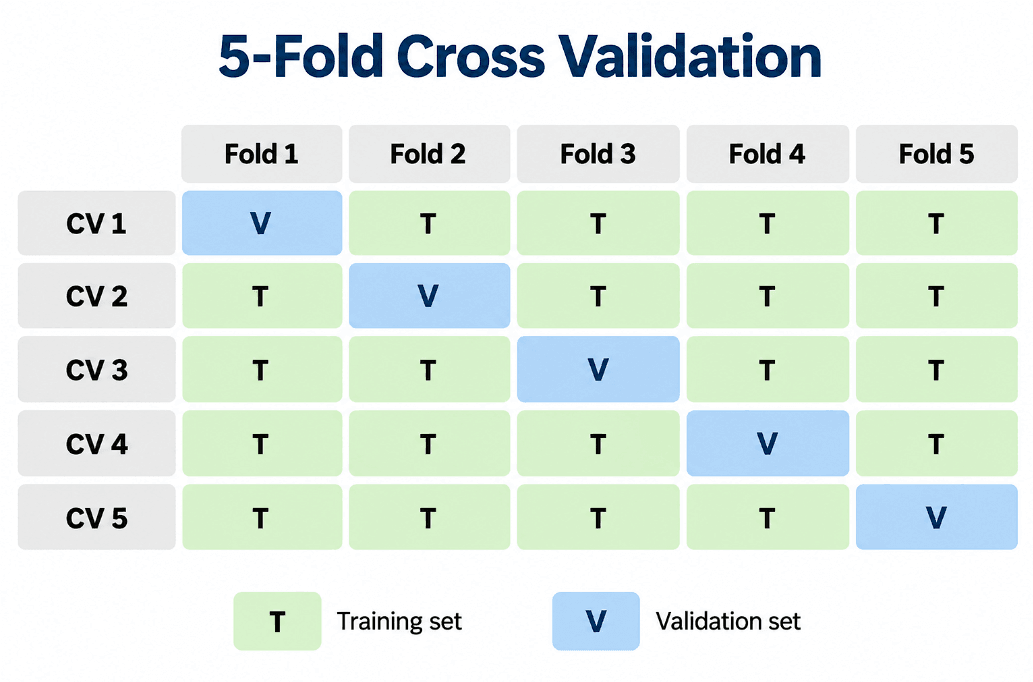
Keterangan:
V = Validation
T = Training
Dengan pendekatan tersebut, setiap data dapat digunakan sebagai bagian validation set pada salah satu iterasi.
Apakah Cross-Validation Membuat Satu Model?
Tidak tepat jika dikatakan bahwa Cross-Validation menghasilkan satu model yang dilatih lima kali kemudian kelima model digabungkan.
Dalam 5-Fold Cross-Validation, prosesnya lebih tepat dipahami sebagai:
Fold 1
   ↓
Train Model 1
   ↓
Score 1

Fold 2
   ↓
Train Model 2
   ↓
Score 2

Fold 3
   ↓
Train Model 3
   ↓
Score 3

Fold 4
   ↓
Train Model 4
   ↓
Score 4

Fold 5
   ↓
Train Model 5
   ↓
Score 5
Tujuan utama proses tersebut adalah evaluasi, bukan menghasilkan lima model untuk digunakan di production.
Setelah proses evaluasi selesai, model final biasanya dilatih kembali menggunakan strategi training yang sesuai dengan workflow proyek.
Menggunakan cross_val_score()
Scikit-Learn menyediakan fungsi:
cross_val_score()
Fungsi tersebut berada pada:
sklearn.model_selection
Import:
from sklearn.model_selection import cross_val_score
Contoh Dasar cross_val_score()
Misalnya kita memiliki classifier:
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import cross_val_score

clf = RandomForestClassifier(
    n_estimators=100,
    random_state=42
)

scores = cross_val_score(
    clf,
    X,
    y,
    cv=5
)

print(scores)
Contoh hasil:
[0.82 0.85 0.80 0.87 0.84]
Hasil tersebut merupakan skor dari masing-masing fold.
Memahami Array Hasil Cross-Validation
Misalnya:
scores = [0.82, 0.85, 0.80, 0.87, 0.84]
Maka:
Fold 1 → 0.82
Fold 2 → 0.85
Fold 3 → 0.80
Fold 4 → 0.87
Fold 5 → 0.84
Kita mendapatkan lima nilai karena:
cv=5
Menghitung Mean Cross-Validation Score
Untuk mendapatkan satu angka ringkasan, kita dapat menghitung rata-rata:
import numpy as np

mean_score = np.mean(scores)

print(mean_score)
Secara matematis:
Contoh:
Scores:

0.82
0.85
0.80
0.87
0.84
Maka:
Mean = (0.82 + 0.85 + 0.80 + 0.87 + 0.84) / 5
Hasilnya:
0.836
Sehingga kita dapat melaporkan:
Mean CV Score ≈ 0.84
Melihat Variasi Score
Selain mean, kita juga dapat melihat standar deviasi.
mean_score = np.mean(scores)
std_score = np.std(scores)

print(f"Mean: {mean_score:.3f}")
print(f"Std: {std_score:.3f}")
Misalnya:
Mean: 0.836
Std: 0.024
Secara sederhana:
Mean
 │
 └── Rata-rata performa

Std
 │
 └── Seberapa besar variasi skor antar-fold
Standar deviasi yang lebih besar menunjukkan skor antar-fold lebih bervariasi.
Namun, interpretasi stabilitas tetap perlu melihat ukuran data dan karakteristik dataset.
Perbedaan score() dan cross_val_score()
Kedua pendekatan tersebut memiliki perbedaan penting.
.score()
Contoh:
score = clf.score(
    X_test,
    y_test
)
Hasilnya:
Satu nilai
Misalnya:
0.85
Evaluasi dilakukan pada satu test split tertentu.
cross_val_score()
Contoh:
scores = cross_val_score(
    clf,
    X,
    y,
    cv=5
)
Hasilnya:
[0.82, 0.85, 0.80, 0.87, 0.84]
Kemudian kita dapat menghitung:
np.mean(scores)
Perbandingan Konseptual
.score()
    │
    ▼
Single Split
    │
    ▼
1 Score
Sedangkan:
cross_val_score()
    │
    ▼
Fold 1 → Score
Fold 2 → Score
Fold 3 → Score
Fold 4 → Score
Fold 5 → Score
    │
    ▼
Multiple Scores
    │
    ▼
Mean / Std
Cross-Validation memberikan lebih banyak informasi mengenai variasi performa model.
Single Test Score vs Cross-Validation
Misalnya kita mendapatkan:
Single Test Score = 0.90
Sedangkan:
CV Scores = [0.82, 0.85, 0.80, 0.87, 0.84]

Mean CV Score = 0.836
Perbedaan tersebut dapat terjadi karena single test split dan fold-fold Cross-Validation menggunakan subset data yang berbeda.
Jangan menganggap bahwa mean Cross-Validation harus selalu lebih rendah daripada single test score.
Hasilnya dapat:
- Lebih tinggi
- Lebih rendah
- Hampir sama
tergantung dataset dan pembagian data.
Parameter cv
Parameter:
cv=5
menentukan strategi jumlah fold pada Cross-Validation.
Contoh:
cv=3
berarti menggunakan 3 fold.
cv=5
berarti menggunakan 5 fold.
cv=10
berarti menggunakan 10 fold.
3-Fold Cross-Validation
Dengan:
cv=3
data dibagi menjadi:
Fold 1
Fold 2
Fold 3
Kemudian:
CV 1 → Fold 1 sebagai validation
CV 2 → Fold 2 sebagai validation
CV 3 → Fold 3 sebagai validation
Hasilnya:
[score_1, score_2, score_3]
5-Fold Cross-Validation
Dengan:
cv=5
kita mendapatkan:
Fold 1
Fold 2
Fold 3
Fold 4
Fold 5
Kemudian menghasilkan lima skor.
scores = cross_val_score(
    clf,
    X,
    y,
    cv=5
)
10-Fold Cross-Validation
Dengan:
cv=10
dataset dibagi menjadi 10 fold.
Keuntungan:
- Setiap fold menggunakan lebih banyak data untuk training dibandingkan 5-fold.
- Mendapatkan lebih banyak evaluasi.
Kekurangannya:
- Model perlu dilatih lebih banyak kali.
- Waktu komputasi meningkat.
Secara umum, pemilihan jumlah fold merupakan trade-off antara kualitas estimasi, ukuran data, dan biaya komputasi.
Parameter scoring
Selain cv, kita dapat menentukan metrik menggunakan:
scoring
Contohnya:
scores = cross_val_score(
    clf,
    X,
    y,
    cv=5,
    scoring="accuracy"
)
Dengan demikian kita secara eksplisit meminta:
Gunakan accuracy untuk evaluasi.
Parameter scoring pada Classification
| Teks Parameter | Nama Metrik | Fokus Utama / Kegunaan |
|---|---|---|
scoring='accuracy' | Accuracy | Menghitung total tebakan benar (cocok untuk data yang jumlahnya seimbang). |
scoring='precision' | Precision | Meminimalkan salah tuduh / False Positive (contoh: menyaring email spam). |
scoring='recall' | Recall | Meminimalkan target yang lolos / False Negative (contoh: deteksi penyakit). |
scoring='f1' | F1-Score | Keseimbangan antara Precision & Recall (cocok untuk data timpang/imbalanced). |
scoring='roc_auc' | ROC AUC | Mengukur kemampuan model memisahkan kelas positif dan kelas negatif. |
Parameter scoring pada Regression
| Teks Parameter | Nama Metrik | Fokus Utama / Kegunaan |
|---|---|---|
scoring='r2' | R-Squared (R²) | Metrik bawaan untuk mengukur persentase variasi data yang bisa dijelaskan model. |
scoring='neg_mean_absolute_error' | Negative MAE | Menghitung rata-rata kesalahan murni dalam satuan asli data (tanpa penalti kuadrat). |
scoring='neg_mean_squared_error' | Negative MSE | Memberikan penalti/hukuman berat pada tebakan yang melesetnya terlalu jauh. |
scoring='neg_root_mean_squared_error' | Negative RMSE | Sama seperti MSE (memberi penalti berat), namun satuannya kembali ke satuan asli data. |
scoring=None
Jika kita tidak memberikan nilai scoring:
scores = cross_val_score(
    clf,
    X,
    y,
    cv=5
)
maka secara default:
scoring=None
Dalam kondisi tersebut, Scikit-Learn menggunakan method .score() dari estimator yang digunakan.
Dengan kata lain:
scoring=None
       │
       ▼
Estimator.score()
       │
       ▼
Default metric estimator
Default Scoring pada Classification
Untuk banyak classifier Scikit-Learn, .score() menggunakan:
Accuracy
Sehingga:
cross_val_score(
    clf,
    X,
    y,
    cv=5
)
pada classifier tertentu akan menghasilkan accuracy untuk setiap fold.
Default Scoring pada Regression
Untuk banyak regressor Scikit-Learn, .score() menggunakan:
R²
Contohnya:
from sklearn.ensemble import RandomForestRegressor
from sklearn.model_selection import cross_val_score

model = RandomForestRegressor(
    n_estimators=100,
    random_state=42
)

scores = cross_val_score(
    model,
    X,
    y,
    cv=5
)

print(scores)
Pada RandomForestRegressor, skor tersebut adalah R² untuk setiap fold.
Menentukan Scoring Secara Eksplisit
Walaupun scoring=None dapat menggunakan default estimator, menentukan scoring secara eksplisit sering membuat kode lebih jelas.
Contohnya:
scores = cross_val_score(
    clf,
    X,
    y,
    cv=5,
    scoring="accuracy"
)
Untuk regresi:
scores = cross_val_score(
    model,
    X,
    y,
    cv=5,
    scoring="r2"
)
Dengan cara tersebut, pembaca kode dapat langsung mengetahui metrik yang digunakan.
Contoh Scoring Classification
Beberapa scoring yang umum digunakan untuk classification:
accuracy
precision
recall
f1
roc_auc
Contoh:
precision_scores = cross_val_score(
    clf,
    X,
    y,
    cv=5,
    scoring="precision"
)
Atau:
recall_scores = cross_val_score(
    clf,
    X,
    y,
    cv=5,
    scoring="recall"
)
Contoh Scoring Regression
Beberapa scoring yang umum digunakan untuk regression:
r2
neg_mean_absolute_error
neg_mean_squared_error
Contoh R²:
r2_scores = cross_val_score(
    model,
    X,
    y,
    cv=5,
    scoring="r2"
)
Untuk MAE:
mae_scores = cross_val_score(
    model,
    X,
    y,
    cv=5,
    scoring="neg_mean_absolute_error"
)
Mengapa MAE Menggunakan Prefix neg_?
Ketika menggunakan cross_val_score(), Scikit-Learn menggunakan konvensi bahwa skor yang lebih besar dianggap lebih baik.
Sementara MAE secara alami lebih kecil lebih baik.
Karena itu, Scikit-Learn menyediakan scoring:
neg_mean_absolute_error
Nilai yang dikembalikan merupakan nilai negatif dari MAE.
Misalnya:
neg_mean_absolute_error = -0.35
maka MAE sebenarnya:
MAE = 0.35
Untuk memperoleh MAE positif:
scores = cross_val_score(
    model,
    X,
    y,
    cv=5,
    scoring="neg_mean_absolute_error"
)

mae = -scores

print(mae)
Jika ingin rata-rata MAE:
mean_mae = -scores.mean()

print(mean_mae)
Ini merupakan salah satu detail penting ketika menggunakan scoring pada Scikit-Learn.
Menggunakan Cross-Validation dengan Classification
Contoh lengkap:
import numpy as np

from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import cross_val_score

clf = RandomForestClassifier(
    n_estimators=100,
    random_state=42
)

scores = cross_val_score(
    clf,
    X,
    y,
    cv=5,
    scoring="accuracy"
)

print("CV Scores:", scores)
print("Mean Accuracy:", np.mean(scores))
print("Std Accuracy:", np.std(scores))
Contoh hasil:
CV Scores: [0.82 0.85 0.80 0.87 0.84]
Mean Accuracy: 0.836
Std Accuracy: 0.024
Menggunakan Cross-Validation dengan Regression
Contoh:
import numpy as np

from sklearn.ensemble import RandomForestRegressor
from sklearn.model_selection import cross_val_score

model = RandomForestRegressor(
    n_estimators=100,
    random_state=42
)

scores = cross_val_score(
    model,
    X,
    y,
    cv=5,
    scoring="r2"
)

print("CV Scores:", scores)
print("Mean R²:", np.mean(scores))
print("Std R²:", np.std(scores))
Stratified Cross-Validation pada Classification
Untuk classification, terutama ketika distribusi kelas perlu dipertahankan, Scikit-Learn sering menggunakan StratifiedKFold sebagai strategi default ketika estimator merupakan classifier dan target bersifat klasifikasi biner atau multiclass.
Secara konsep, stratification berusaha menjaga proporsi kelas pada setiap fold agar relatif serupa dengan distribusi kelas keseluruhan.
Contohnya:
Dataset
├── Class 0 → 60%
└── Class 1 → 40%
Setiap fold akan berusaha mempertahankan proporsi tersebut.
KFold
Untuk kasus yang memerlukan kontrol eksplisit terhadap pembagian fold, kita dapat menggunakan KFold.
from sklearn.model_selection import KFold

cv = KFold(
    n_splits=5,
    shuffle=True,
    random_state=42
)
Kemudian:
scores = cross_val_score(
    clf,
    X,
    y,
    cv=cv
)
Dengan shuffle=True, data diacak sebelum dibagi menjadi fold.
StratifiedKFold
Untuk classification, kita dapat menggunakan:
from sklearn.model_selection import StratifiedKFold

cv = StratifiedKFold(
    n_splits=5,
    shuffle=True,
    random_state=42
)
Kemudian:
scores = cross_val_score(
    clf,
    X,
    y,
    cv=cv,
    scoring="accuracy"
)
Pendekatan ini memberikan kontrol eksplisit terhadap strategi stratified cross-validation.
Cross-Validation dan Data Leakage
Cross-Validation bukan berarti kita boleh melakukan preprocessing terhadap seluruh dataset sebelum proses Cross-Validation.
Contoh yang berisiko leakage:
scaler.fit_transform(X)

scores = cross_val_score(
    model,
    X,
    y,
    cv=5
)
Scaler telah melihat seluruh dataset sebelum fold dibuat.
Hal tersebut dapat menyebabkan informasi dari validation fold masuk ke proses preprocessing.
Menggunakan Pipeline
Cara yang lebih aman adalah memasukkan preprocessing dan model ke dalam Pipeline.
Contohnya:
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import cross_val_score

pipeline = Pipeline([
    ("scaler", StandardScaler()),
    ("model", LogisticRegression(max_iter=1000))
])

scores = cross_val_score(
    pipeline,
    X,
    y,
    cv=5,
    scoring="accuracy"
)
Pipeline memastikan proses fitting preprocessing dilakukan secara tepat pada data training masing-masing fold.
Secara konseptual:
Fold
 │
 ├── Training Data
 │       │
 │       ▼
 │   Fit Scaler
 │       │
 │       ▼
 │   Train Model
 │
 └── Validation Data
         │
         ▼
    Transform Only
         │
         ▼
       Predict
         │
         ▼
       Score
Cross-Validation Bukan Pengganti Test Set dalam Semua Kasus
Cross-Validation sering digunakan untuk:
- Evaluasi model
- Membandingkan model
- Memilih hyperparameter
- Model selection
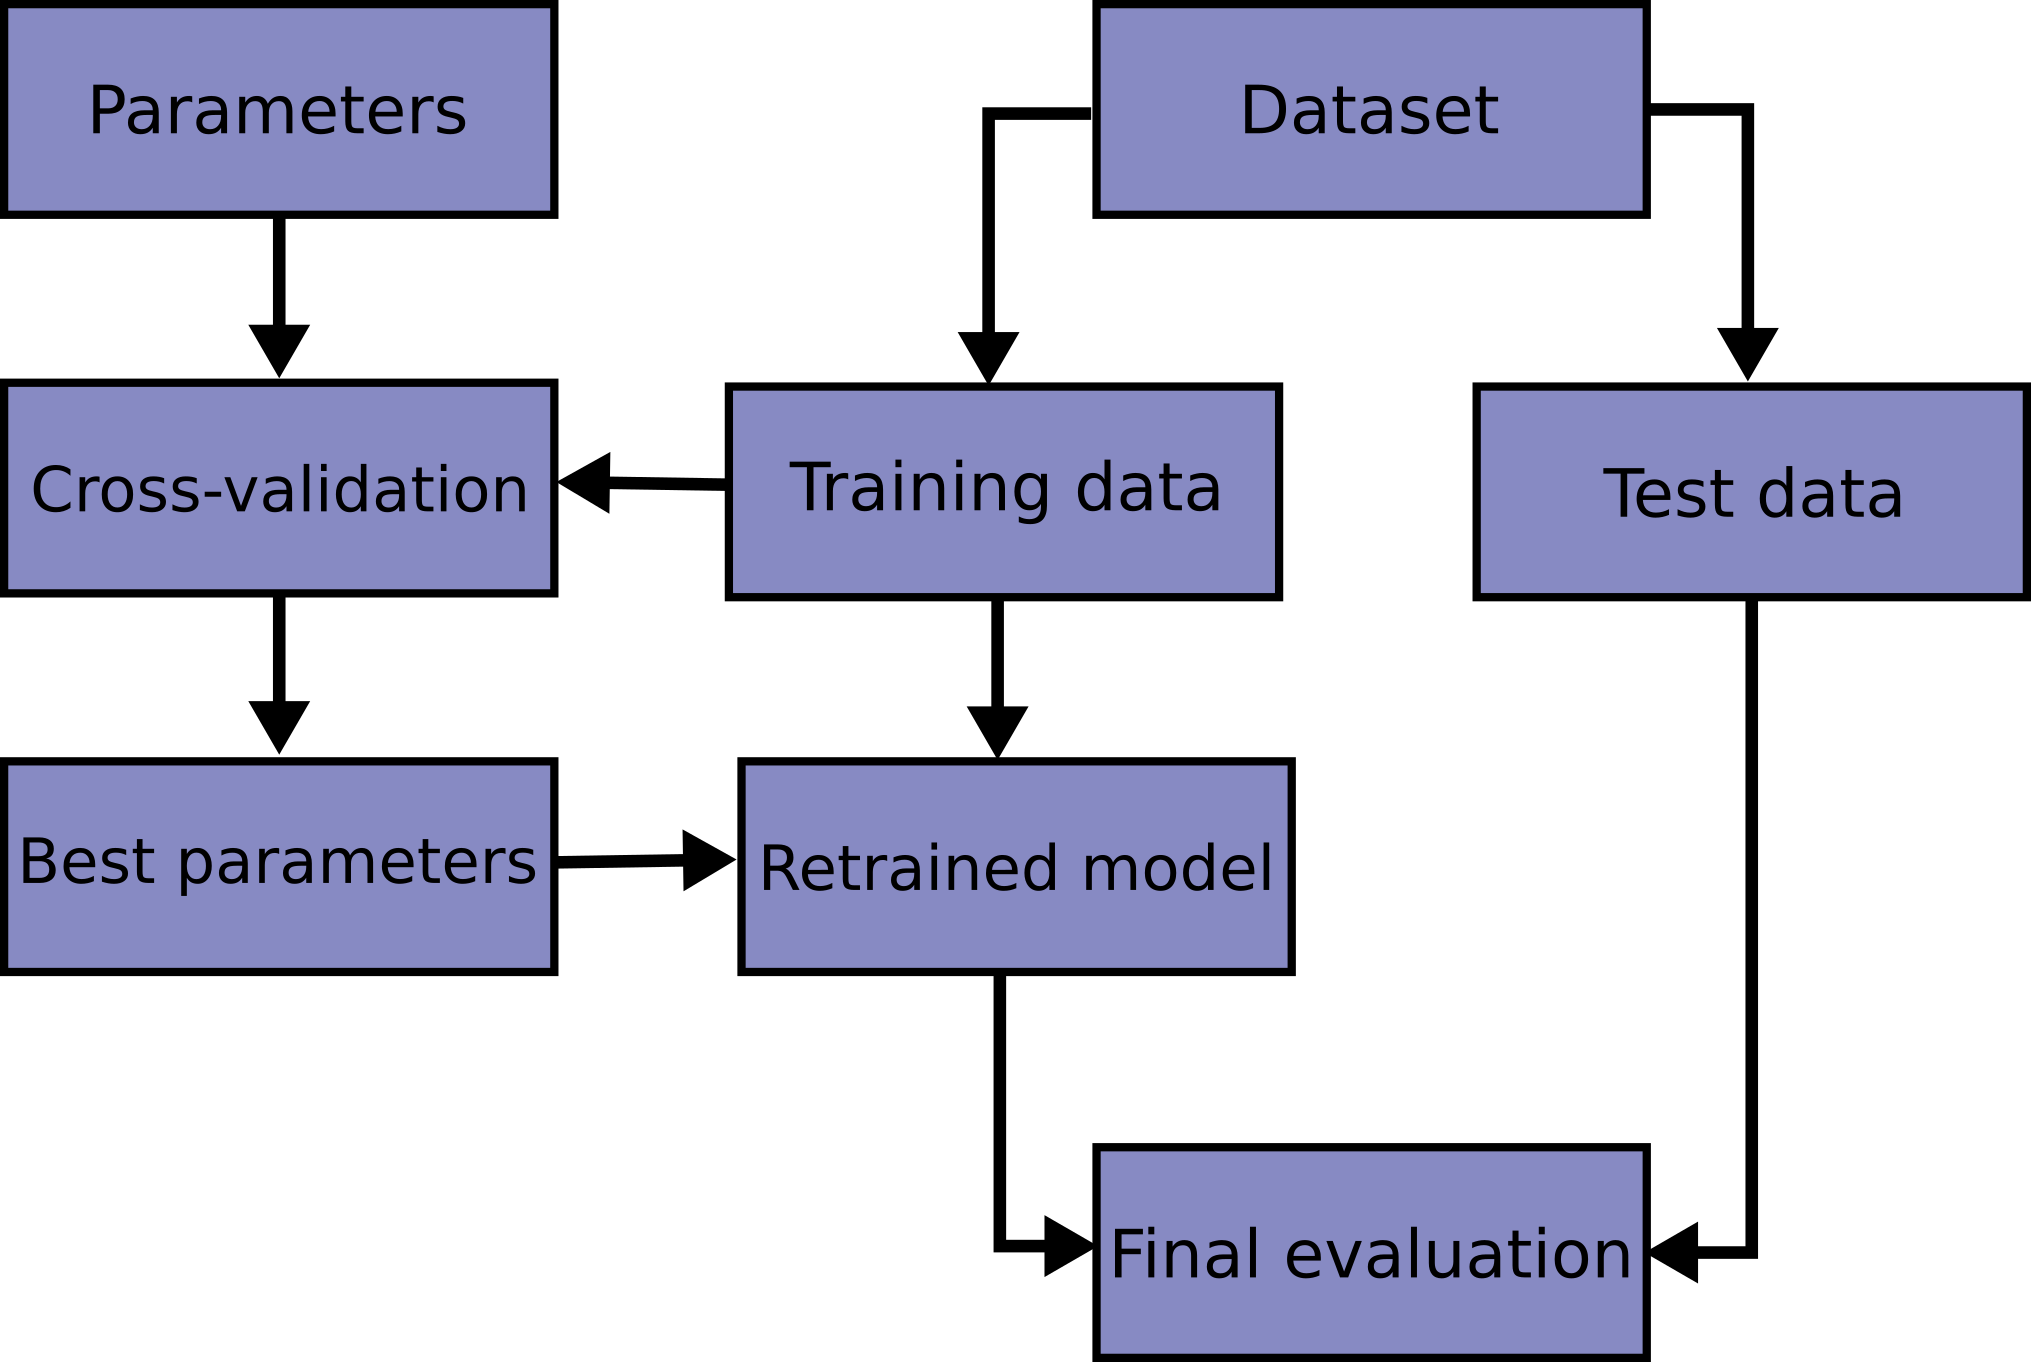
Namun, jika kita menggunakan Cross-Validation untuk memilih model atau hyperparameter, kita tetap perlu berhati-hati agar tidak menggunakan data test akhir untuk proses pemilihan tersebut.
Workflow yang lebih aman:
Dataset
   │
   ├───────────────┐
   ▼               ▼
Training Data    Final Test Data
   │               │
   ▼               │
Cross-Validation   │
   │               │
   ▼               │
Model /            │
Hyperparameter     │
Selection          │
   │               │
   ▼               │
Best Parameters    │
   │               │
   ▼               │
Retrain Final Model│
   │               │
   └───────┬───────┘
           ▼
   Final Test Evaluation
Final test set disimpan untuk evaluasi akhir.
Sumber gambar: https://scikit-learn.org/stable/modules/cross_validation.html
Mean Cross-Validation Score
Setelah mendapatkan scores:
scores = cross_val_score(
    clf,
    X,
    y,
    cv=5,
    scoring="accuracy"
)
kita dapat menghitung mean:
mean_score = scores.mean()

print(f"Mean CV Score: {mean_score:.3f}")
Kita juga dapat menggunakan:
import numpy as np

mean_score = np.mean(scores)
Keduanya memberikan hasil yang sama untuk array NumPy tersebut.
Standar Deviasi Cross-Validation
Kita dapat menghitung variasi:
std_score = scores.std()

print(f"Std CV Score: {std_score:.3f}")
Misalnya:
Mean CV Score = 0.836
Std CV Score  = 0.024
Hasil tersebut memberikan dua informasi:
0.836 → rata-rata performa
0.024 → variasi skor antar-fold
Melaporkan Hasil Cross-Validation
Daripada hanya menampilkan:
0.836
kita dapat melaporkan:
Accuracy = 0.836 ± 0.024
atau:
Mean CV Accuracy: 83.6%
Standard Deviation: 2.4%
Pelaporan seperti ini memberikan informasi lebih lengkap mengenai performa model di beberapa fold.
Contoh Perbandingan Model
Cross-Validation juga dapat digunakan untuk membandingkan beberapa model.
import numpy as np

from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import cross_val_score

models = {
    "Logistic Regression": LogisticRegression(
        max_iter=1000
    ),
    "Random Forest": RandomForestClassifier(
        n_estimators=100,
        random_state=42
    )
}

for name, model in models.items():

    scores = cross_val_score(
        model,
        X,
        y,
        cv=5,
        scoring="accuracy"
    )

    print(
        f"{name}: "
        f"{np.mean(scores):.3f} "
        f"+/- {np.std(scores):.3f}"
    )
Dengan cara tersebut, setiap model dievaluasi menggunakan strategi Cross-Validation yang sama.
Hal yang Harus Konsisten Saat Membandingkan Model
Ketika membandingkan beberapa model menggunakan Cross-Validation, usahakan menggunakan:
Dataset yang sama
       +
Fold yang sama
       +
Metrik yang sama
       +
Preprocessing yang sesuai
Contohnya:
Model A → 5-Fold Accuracy
Model B → 5-Fold Accuracy
Model C → 5-Fold Accuracy
Dengan demikian perbandingan menjadi lebih bermakna.
Kapan Menggunakan Cross-Validation?
Cross-Validation sangat berguna ketika:
1. Dataset Relatif Terbatas
Jika data tidak terlalu banyak, Cross-Validation memungkinkan berbagai bagian data digunakan untuk training dan validation pada iterasi berbeda.
2. Membandingkan Model
Kita dapat membandingkan beberapa estimator menggunakan fold yang sama.
3. Hyperparameter Tuning
Cross-Validation banyak digunakan dalam:
GridSearchCV
RandomizedSearchCV
4. Mendapatkan Estimasi Performa yang Lebih Stabil
Daripada hanya bergantung pada satu split, kita dapat melihat beberapa hasil evaluasi.
Kapan Cross-Validation Bisa Mahal?
Cross-Validation membutuhkan training model beberapa kali.
Misalnya:
5-Fold
berarti model dilatih dan dievaluasi sebanyak lima iterasi untuk satu konfigurasi.
Jika kita melakukan:
5-fold CV
×
10 kombinasi hyperparameter
maka secara sederhana terdapat sekitar:
50 training runs
Belum termasuk proses tambahan dari parallelism atau konfigurasi pencarian lainnya.
Untuk model yang mahal dilatih, Cross-Validation dapat membutuhkan waktu yang signifikan.
Workflow Cross-Validation
Workflow lengkap dapat digambarkan:
Dataset
   │
   ▼
Tentukan X dan y
   │
   ▼
Pilih Model
   │
   ▼
Tentukan CV
   │
   ▼
Tentukan scoring
   │
   ▼
Cross-Validation
   │
   ├── Fold 1 → Score
   ├── Fold 2 → Score
   ├── Fold 3 → Score
   ├── Fold 4 → Score
   └── Fold 5 → Score
            │
            ▼
       Mean + Std
            │
            ▼
      Evaluasi Model
Contoh Lengkap
Berikut contoh lengkap menggunakan Random Forest Classifier.
import numpy as np

from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import cross_val_score

# 1. Membuat model
clf = RandomForestClassifier(
    n_estimators=100,
    random_state=42
)

# 2. Cross-Validation
scores = cross_val_score(
    clf,
    X,
    y,
    cv=5,
    scoring="accuracy"
)

# 3. Menampilkan skor setiap fold
print("Cross-Validation Scores:")
print(scores)

# 4. Menghitung mean
mean_score = np.mean(scores)

# 5. Menghitung standar deviasi
std_score = np.std(scores)

print(f"Mean Accuracy: {mean_score:.3f}")
print(f"Std Accuracy: {std_score:.3f}")
Membandingkan dengan Single Split
Kita dapat membandingkan evaluasi biasa dengan Cross-Validation.
from sklearn.model_selection import train_test_split

# Single train-test split
X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42,
    stratify=y
)

clf = RandomForestClassifier(
    n_estimators=100,
    random_state=42
)

clf.fit(X_train, y_train)

single_score = clf.score(
    X_test,
    y_test
)

# Cross-Validation
cv_scores = cross_val_score(
    clf,
    X,
    y,
    cv=5,
    scoring="accuracy"
)

cv_mean = np.mean(cv_scores)

print(f"Single Test Score: {single_score:.3f}")
print(f"Mean CV Score: {cv_mean:.3f}")
print(f"CV Std: {np.std(cv_scores):.3f}")
Perlu diperhatikan bahwa kedua angka tersebut tidak harus sama.
Single test score berasal dari satu pembagian data, sedangkan mean CV score berasal dari beberapa fold.
Kelebihan Cross-Validation
Beberapa kelebihan Cross-Validation:
- Mengurangi ketergantungan pada satu pembagian data
- Memberikan beberapa nilai evaluasi
- Dapat digunakan untuk menghitung mean dan variasi performa
- Berguna untuk membandingkan model
- Berguna untuk hyperparameter tuning
- Membantu mengevaluasi generalisasi model
Kekurangan Cross-Validation
Cross-Validation juga memiliki beberapa keterbatasan:
- Membutuhkan training model beberapa kali
- Dapat membutuhkan waktu lebih lama
- Tidak otomatis menyelesaikan data leakage
- Strategi fold harus disesuaikan dengan jenis data
- Pada data time series, K-Fold biasa dapat menyebabkan kebocoran informasi waktu
Untuk data time series, strategi validasi harus mempertahankan urutan waktu, misalnya menggunakan TimeSeriesSplit.
Cross-Validation pada Time Series
Misalnya kita memiliki data:
2022
2023
2024
2025
2026
Tidak tepat jika data masa depan digunakan untuk memprediksi masa lalu.
Untuk kasus seperti ini, kita membutuhkan strategi yang mempertahankan urutan waktu.
Scikit-Learn menyediakan:
from sklearn.model_selection import TimeSeriesSplit
Contoh:
cv = TimeSeriesSplit(
    n_splits=5
)
Kemudian dapat digunakan dengan:
scores = cross_val_score(
    model,
    X,
    y,
    cv=cv,
    scoring="r2"
)
Pemilihan strategi Cross-Validation harus mengikuti struktur dan tujuan dataset.
Ringkasan
Beberapa konsep penting dari materi ini:
.score()melakukan evaluasi berdasarkan satu set data yang diberikan.- Cross-Validation mengevaluasi model pada beberapa fold.
cross_val_score()digunakan untuk melakukan evaluasi Cross-Validation.cv=5berarti menggunakan 5 fold.- Setiap fold mendapat kesempatan menjadi validation set satu kali.
- Cross-Validation menghasilkan beberapa nilai score.
- Mean dari score dapat digunakan sebagai ringkasan performa.
- Standard deviation memberikan informasi mengenai variasi score antar-fold.
scoringdigunakan untuk menentukan metrik evaluasi secara eksplisit.scoring=Nonemembuatcross_val_score()menggunakan method.score()dari estimator.- Pada banyak classifier, default
.score()adalah accuracy. - Pada banyak regressor, default
.score()adalah R². - Scikit-Learn menggunakan konvensi bahwa nilai scoring yang lebih besar dianggap lebih baik.
- Karena itu, beberapa error metric seperti MAE tersedia dalam bentuk negatif, misalnya
neg_mean_absolute_error. - Cross-Validation tidak otomatis mencegah data leakage.
- Preprocessing sebaiknya dimasukkan ke dalam
Pipelineketika digunakan bersama Cross-Validation. - Cross-Validation dapat digunakan untuk membandingkan model dan melakukan hyperparameter tuning.
- Cross-Validation membutuhkan tambahan waktu komputasi karena model dilatih beberapa kali.
- Strategi Cross-Validation harus disesuaikan dengan jenis data.
- Untuk time series, gunakan strategi yang mempertahankan urutan waktu seperti
TimeSeriesSplit.
Latihan
Latihan 1 - 5-Fold Cross-Validation
Gunakan:
cross_val_score()
dengan:
cv=5
Kemudian tampilkan semua score.
Latihan 2 - Menghitung Mean
Hitung:
scores.mean()
Kemudian bandingkan dengan masing-masing score dari lima fold.
Latihan 3 - Menghitung Standard Deviation
Gunakan:
scores.std()
Kemudian jelaskan apa arti nilai tersebut.
Latihan 4 - Membandingkan cv
Bandingkan:
cv=3
cv=5
cv=10
Catat:
Mean Score
Standard Deviation
Kemudian amati bagaimana jumlah fold memengaruhi hasil evaluasi dan waktu komputasi.
Latihan 5 - Membandingkan Model
Bandingkan:
Logistic Regression
Random Forest
Gunakan:
5-Fold Cross-Validation
dan:
Accuracy
Kemudian catat:
Mean Accuracy
Standard Deviation
Latihan 6 - Menggunakan scoring
Coba beberapa scoring:
accuracy
precision
recall
f1
Kemudian bandingkan hasilnya.