Evaluasi Model dengan Parameter scoring pada Cross-Validation
Pada materi sebelumnya, kita telah mempelajari Cross-Validation menggunakan fungsi cross_val_score().
Cross-validation membantu kita mengevaluasi performa model dengan membagi dataset menjadi beberapa bagian atau fold. Model kemudian dilatih dan dievaluasi beberapa kali menggunakan kombinasi data train dan validation yang berbeda.
Namun, ada satu hal penting:
Bagaimana jika kita tidak ingin menggunakan metrik default dari model?
Misalnya, pada model klasifikasi kita tidak hanya ingin mengetahui accuracy, tetapi juga ingin mengetahui:
- Precision
- Recall
- F1-score
Begitu juga pada regresi, kita mungkin ingin mengevaluasi model menggunakan:
- R²
- MAE
- MSE
Untuk menentukan metrik yang digunakan dalam cross_val_score(), Scikit-Learn menyediakan parameter:
scoring
Pada materi ini kita akan mempelajari bagaimana menggunakan parameter scoring untuk memilih metrik evaluasi yang sesuai.
Konsep Dasar Cross-Validation
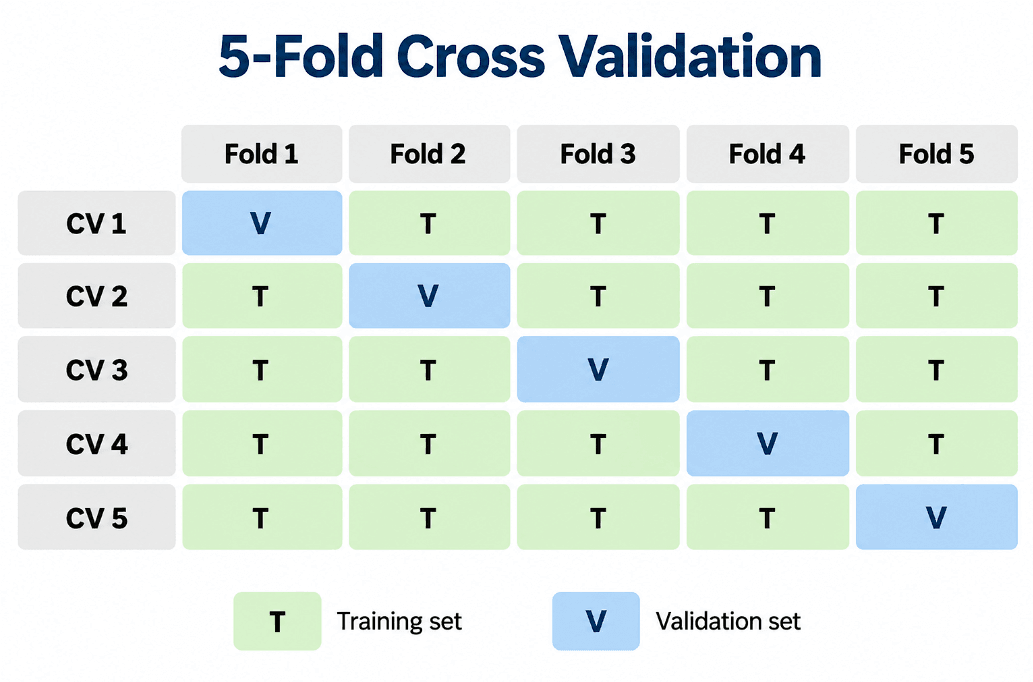
Fungsi cross_val_score() digunakan untuk mengevaluasi model menggunakan beberapa fold.
Contoh:
from sklearn.model_selection import cross_val_score

scores = cross_val_score(
    model,
    X,
    y,
    cv=5
)
Dengan cv=5, dataset dibagi menjadi 5 fold.
Secara sederhana:
Fold 1 → Train + Validation
Fold 2 → Train + Validation
Fold 3 → Train + Validation
Fold 4 → Train + Validation
Fold 5 → Train + Validation
Setiap fold secara bergantian digunakan sebagai data validasi, sedangkan fold lainnya digunakan untuk training.
Hasilnya adalah beberapa nilai score:
Fold 1 → 0.82
Fold 2 → 0.79
Fold 3 → 0.85
Fold 4 → 0.81
Fold 5 → 0.83
Kita kemudian dapat menghitung rata-ratanya:
import numpy as np

np.mean(scores)
Misalnya hasilnya:
0.82
Artinya, rata-rata score model berdasarkan 5 fold adalah 0.82.
Mengapa Menggunakan Cross-Validation?
Jika kita hanya menggunakan satu kali train_test_split(), hasil evaluasi dapat dipengaruhi oleh bagaimana dataset kebetulan terbagi.
Contohnya:
Train/Test Split

Training Data
       ↓
     Model
       ↓
   Test Data
       ↓
     Score
Jika pembagian datanya berbeda, hasil score juga dapat berubah.
Cross-validation melakukan evaluasi beberapa kali:
             ┌── Fold 1 → Score
             ├── Fold 2 → Score
Dataset ─────┼── Fold 3 → Score
             ├── Fold 4 → Score
             └── Fold 5 → Score
                     ↓
                Mean Score
Dengan demikian, kita memperoleh gambaran performa model yang lebih lengkap daripada hanya mengandalkan satu pembagian data.
Cross-validation bukan jaminan bahwa model bebas dari overfitting. Cross-validation terutama digunakan untuk memperoleh estimasi performa yang lebih stabil dan membantu proses pemilihan model atau hyperparameter.
Parameter scoring
Secara umum, penggunaan cross_val_score() adalah:
cross_val_score(
    estimator,
    X,
    y,
    cv=5,
    scoring=None
)
Parameter scoring menentukan metrik evaluasi yang digunakan.
Contohnya:
scoring="accuracy"
atau:
scoring="precision"
atau:
scoring="recall"
Untuk regresi:
scoring="r2"
atau:
scoring="neg_mean_absolute_error"
Apa yang Terjadi Jika scoring=None?
Jika kita tidak menentukan scoring, nilainya secara default adalah:
scoring=None
Dalam kondisi tersebut, cross_val_score() menggunakan metode .score() dari estimator yang digunakan.
Artinya, metrik default bergantung pada model.
Contohnya:
| Jenis Model | .score() Default |
|---|---|
RandomForestClassifier | Accuracy |
LogisticRegression | Accuracy |
RandomForestRegressor | R² |
LinearRegression | R² |
Jadi, lebih tepat memahami:
scoring=None
      ↓
Gunakan estimator.score()
      ↓
Metrik bergantung pada estimator
Bukan berarti scoring=None selalu menggunakan accuracy.
scoring pada Classification
Untuk masalah klasifikasi, kita dapat memilih berbagai metrik.
Beberapa metrik yang umum digunakan:
| Scoring | Metrik |
|---|---|
"accuracy" | Accuracy |
"precision" | Precision |
"recall" | Recall |
"f1" | F1-score |
"roc_auc" | ROC-AUC |
Pemilihan metrik bergantung pada tujuan evaluasi.
Menggunakan Accuracy
Kita dapat menggunakan dataset Heart Disease sebagai contoh.
Misalnya dataset sudah tersedia dalam DataFrame:
import numpy as np
from sklearn.model_selection import cross_val_score
from sklearn.ensemble import RandomForestClassifier

np.random.seed(42)

X = heart_disease.drop("target", axis=1)
y = heart_disease["target"]

clf = RandomForestClassifier(
    n_estimators=100,
    random_state=42
)
Kemudian lakukan cross-validation:
cv_acc = cross_val_score(
    clf,
    X,
    y,
    cv=5,
    scoring="accuracy"
)

print(cv_acc)
Contoh hasil:
[0.82 0.84 0.80 0.83 0.81]
Kita dapat menghitung rata-rata:
print(f"Cross-validated accuracy: {np.mean(cv_acc):.2f}")
Contoh:
Cross-validated accuracy: 0.82
Jika ingin menampilkan dalam bentuk persentase:
print(
    f"Cross-validated accuracy: "
    f"{np.mean(cv_acc) * 100:.2f}%"
)
Hasil:
Cross-validated accuracy: 82.00%
Accuracy dengan scoring=None
Karena RandomForestClassifier menggunakan accuracy sebagai default scorer untuk .score(), kode berikut juga dapat digunakan:
cv_acc = cross_val_score(
    clf,
    X,
    y,
    cv=5,
    scoring=None
)
Atau cukup:
cv_acc = cross_val_score(
    clf,
    X,
    y,
    cv=5
)
Keduanya menggunakan scorer default dari estimator.
Namun, jika kita ingin kode lebih eksplisit, kita dapat menuliskan:
scoring="accuracy"
Hal ini membuat pembaca kode langsung mengetahui metrik yang digunakan.
Menggunakan Precision
Accuracy tidak selalu cukup untuk mengevaluasi model klasifikasi.
Misalnya kita ingin mengetahui:
Dari seluruh data yang diprediksi sebagai positif, berapa banyak yang benar-benar positif?
Metrik yang digunakan adalah Precision.
Kita dapat menggunakan:
cv_precision = cross_val_score(
    clf,
    X,
    y,
    cv=5,
    scoring="precision"
)
Kemudian:
print(cv_precision)
Untuk menghitung rata-rata:
print(
    f"Cross-validated precision: "
    f"{np.mean(cv_precision):.2f}"
)
Contoh:
Cross-validated precision: 0.84
Menggunakan Recall
Recall menjawab pertanyaan:
Dari seluruh data yang sebenarnya positif, berapa banyak yang berhasil ditemukan oleh model?
Gunakan:
cv_recall = cross_val_score(
    clf,
    X,
    y,
    cv=5,
    scoring="recall"
)
Kemudian:
print(
    f"Cross-validated recall: "
    f"{np.mean(cv_recall):.2f}"
)
Contoh:
Cross-validated recall: 0.81
Menggunakan F1-Score
F1-score menggabungkan precision dan recall dalam satu metrik.
Gunakan:
cv_f1 = cross_val_score(
    clf,
    X,
    y,
    cv=5,
    scoring="f1"
)

print(
    f"Cross-validated F1-score: "
    f"{np.mean(cv_f1):.2f}"
)
Contoh:
Cross-validated F1-score: 0.82
F1-score sering berguna ketika kita ingin mempertimbangkan precision dan recall secara bersamaan.
Membandingkan Beberapa Metrik Klasifikasi
Kita dapat menghitung beberapa metrik sekaligus:
cv_acc = cross_val_score(
    clf,
    X,
    y,
    cv=5,
    scoring="accuracy"
)

cv_precision = cross_val_score(
    clf,
    X,
    y,
    cv=5,
    scoring="precision"
)

cv_recall = cross_val_score(
    clf,
    X,
    y,
    cv=5,
    scoring="recall"
)

cv_f1 = cross_val_score(
    clf,
    X,
    y,
    cv=5,
    scoring="f1"
)
Kemudian tampilkan hasilnya:
print(f"Accuracy : {np.mean(cv_acc):.2f}")
print(f"Precision: {np.mean(cv_precision):.2f}")
print(f"Recall   : {np.mean(cv_recall):.2f}")
print(f"F1-score : {np.mean(cv_f1):.2f}")
Contoh output:
Accuracy : 0.82
Precision: 0.84
Recall   : 0.81
F1-score : 0.82
Perhatikan bahwa satu model dapat memiliki beberapa nilai evaluasi karena setiap metrik mengukur aspek performa yang berbeda.
scoring pada Regression
Pada masalah regresi, scoring=None akan menggunakan .score() dari estimator.
Untuk estimator regresi yang umum, seperti:
RandomForestRegressor
dan:
LinearRegression
metode .score() secara default menggunakan R².
Contoh:
from sklearn.ensemble import RandomForestRegressor

model = RandomForestRegressor(
    n_estimators=100,
    random_state=42
)
Kemudian:
cv_r2 = cross_val_score(
    model,
    X,
    y,
    cv=5,
    scoring=None
)
Kita dapat menghitung rata-ratanya:
print(
    f"Cross-validated R²: "
    f"{np.mean(cv_r2):.2f}"
)
Kita juga dapat menuliskan scoring secara eksplisit:
cv_r2 = cross_val_score(
    model,
    X,
    y,
    cv=5,
    scoring="r2"
)
Menggunakan neg_mean_absolute_error
Sebelumnya kita telah mempelajari Mean Absolute Error atau MAE.
Secara konsep:
MAE lebih kecil → lebih baik
Namun Scikit-Learn memiliki konvensi berbeda untuk parameter scoring.
Prinsip Higher is Better
Scikit-Learn menggunakan prinsip:
Nilai scoring yang lebih tinggi selalu dianggap lebih baik.
Masalahnya, MAE secara normal memiliki prinsip:
MAE lebih kecil → lebih baik
Untuk menyesuaikan dengan konvensi Scikit-Learn, MAE ditulis sebagai:
scoring="neg_mean_absolute_error"
Scikit-Learn mengembalikan nilai negatif dari MAE.
Contoh:
cv_mae = cross_val_score(
    model,
    X,
    y,
    cv=5,
    scoring="neg_mean_absolute_error"
)

print(cv_mae)
Contoh hasil:
[-2.31 -2.48 -2.17 -2.35 -2.29]
Kemudian:
print(
    f"Cross-validated negative MAE: "
    f"{np.mean(cv_mae):.2f}"
)
Hasil:
Cross-validated negative MAE: -2.32
Mengubah Negative MAE Menjadi MAE
Karena hasil cross_val_score() menggunakan nilai negatif, kita dapat mengubahnya kembali menjadi MAE positif dengan memberikan tanda negatif:
mae = -np.mean(cv_mae)

print(f"Cross-validated MAE: {mae:.2f}")
Hasil:
Cross-validated MAE: 2.32
Dengan demikian, interpretasinya kembali seperti MAE biasa:
MAE = 2.32
Artinya, rata-rata absolute error model adalah sekitar 2.32 satuan target.
Mengapa Nilainya Dibuat Negatif?
Secara konseptual:
MAE asli

0.00 ← lebih baik
1.00
2.00
3.00 ← lebih buruk
Tetapi cross_val_score() mengikuti aturan:
nilai lebih tinggi → lebih baik
Maka Scikit-Learn menggunakan:
negative MAE

 0.00 ← lebih baik
-1.00
-2.00
-3.00 ← lebih buruk
Perhatikan:
-1.00 > -2.00
Sehingga nilai -1.00 dianggap lebih baik daripada -2.00.
Menggunakan neg_mean_squared_error
Hal yang sama berlaku untuk Mean Squared Error (MSE).
Secara normal:
MSE lebih kecil → lebih baik
Tetapi dalam scoring Scikit-Learn digunakan:
scoring="neg_mean_squared_error"
Contoh:
cv_mse = cross_val_score(
    model,
    X,
    y,
    cv=5,
    scoring="neg_mean_squared_error"
)
Kemudian:
print(cv_mse)
Contoh:
[-8.42 -9.15 -7.93 -8.76 -8.21]
Untuk mendapatkan MSE positif:
mse = -np.mean(cv_mse)

print(f"Cross-validated MSE: {mse:.2f}")
Contoh:
Cross-validated MSE: 8.49
Negative MSE dan RMSE
Jika kita ingin mendapatkan RMSE, kita dapat menghitung akar kuadrat dari MSE.
Contoh:
import numpy as np

cv_mse = cross_val_score(
    model,
    X,
    y,
    cv=5,
    scoring="neg_mean_squared_error"
)

mse = -np.mean(cv_mse)
rmse = np.sqrt(mse)

print(f"MSE : {mse:.2f}")
print(f"RMSE: {rmse:.2f}")
Misalnya:
MSE : 8.49
RMSE: 2.91
Dengan demikian, kita mendapatkan kembali MSE positif dan RMSE dalam satuan target.
Perbandingan Scoring Classification
Berikut beberapa scoring yang umum digunakan:
| Scoring | Metrik | Prinsip Umum |
|---|---|---|
"accuracy" | Accuracy | Lebih tinggi lebih baik |
"precision" | Precision | Lebih tinggi lebih baik |
"recall" | Recall | Lebih tinggi lebih baik |
"f1" | F1-score | Lebih tinggi lebih baik |
"roc_auc" | ROC-AUC | Lebih tinggi lebih baik |
Contoh:
scoring="accuracy"
scoring="precision"
scoring="recall"
scoring="f1"
Perbandingan Scoring Regression
Beberapa scoring yang umum digunakan:
| Scoring | Metrik | Nilai Lebih Tinggi |
|---|---|---|
"r2" | R² | Lebih baik |
"neg_mean_absolute_error" | Negative MAE | Lebih baik |
"neg_mean_squared_error" | Negative MSE | Lebih baik |
"neg_root_mean_squared_error" | Negative RMSE | Lebih baik |
Perhatikan bahwa metrik error menggunakan prefix:
neg_
karena Scikit-Learn menggunakan konvensi higher is better.
Hal Penting tentang neg_
Kesalahan umum yang sering terjadi adalah menganggap:
-2.0 lebih buruk daripada -3.0
Padahal dalam konteks scoring:
-2.0 > -3.0
Karena higher is better, maka:
-2.0 → lebih baik
-3.0 → lebih buruk
Tetapi ketika kita mengubahnya kembali menjadi MAE positif:
mae = -np.mean(cv_mae)
maka interpretasinya kembali menjadi:
MAE = 2.0 → lebih baik
MAE = 3.0 → lebih buruk
Jadi, jangan langsung menginterpretasikan nilai negatif sebagai MAE sebenarnya.
Contoh Lengkap Classification
Berikut contoh evaluasi beberapa metrik sekaligus:
import numpy as np
from sklearn.model_selection import cross_val_score
from sklearn.ensemble import RandomForestClassifier

X = heart_disease.drop("target", axis=1)
y = heart_disease["target"]

clf = RandomForestClassifier(
    n_estimators=100,
    random_state=42
)

cv_acc = cross_val_score(
    clf,
    X,
    y,
    cv=5,
    scoring="accuracy"
)

cv_precision = cross_val_score(
    clf,
    X,
    y,
    cv=5,
    scoring="precision"
)

cv_recall = cross_val_score(
    clf,
    X,
    y,
    cv=5,
    scoring="recall"
)

cv_f1 = cross_val_score(
    clf,
    X,
    y,
    cv=5,
    scoring="f1"
)

print(f"Accuracy : {np.mean(cv_acc):.2f}")
print(f"Precision: {np.mean(cv_precision):.2f}")
print(f"Recall   : {np.mean(cv_recall):.2f}")
print(f"F1-score : {np.mean(cv_f1):.2f}")
Output dapat terlihat seperti:
Accuracy : 0.82
Precision: 0.84
Recall   : 0.81
F1-score : 0.82
Contoh Lengkap Regression
Contoh evaluasi menggunakan R², MAE, dan MSE:
import numpy as np
from sklearn.model_selection import cross_val_score
from sklearn.ensemble import RandomForestRegressor

model = RandomForestRegressor(
    n_estimators=100,
    random_state=42
)

cv_r2 = cross_val_score(
    model,
    X,
    y,
    cv=5,
    scoring="r2"
)

cv_mae = cross_val_score(
    model,
    X,
    y,
    cv=5,
    scoring="neg_mean_absolute_error"
)

cv_mse = cross_val_score(
    model,
    X,
    y,
    cv=5,
    scoring="neg_mean_squared_error"
)

r2 = np.mean(cv_r2)
mae = -np.mean(cv_mae)
mse = -np.mean(cv_mse)
rmse = np.sqrt(mse)

print(f"R²  : {r2:.2f}")
print(f"MAE : {mae:.2f}")
print(f"MSE : {mse:.2f}")
print(f"RMSE: {rmse:.2f}")
Contoh output:
R²  : 0.78
MAE : 2.31
MSE : 8.42
RMSE: 2.90
Jangan Membandingkan Angka Metrik Secara Langsung
Penting untuk memahami bahwa setiap metrik mengukur sesuatu yang berbeda.
Misalnya:
R²   = 0.78
MAE  = 2.31
MSE  = 8.42
RMSE = 2.90
Kita tidak dapat mengatakan:
0.78 lebih baik daripada 2.31
atau:
2.31 lebih baik daripada 8.42
Karena metrik tersebut memiliki makna dan skala yang berbeda.
Yang benar adalah membandingkan model menggunakan metrik yang sama.
Contoh:
Model A → MAE = 2.31
Model B → MAE = 2.75
Untuk MAE, nilai yang lebih kecil menunjukkan error rata-rata yang lebih kecil.
Begitu juga:
Model A → R² = 0.78
Model B → R² = 0.71
Untuk R², nilai yang lebih tinggi menunjukkan performa yang lebih baik menurut metrik tersebut pada data evaluasi yang sama.
scoring dan Tujuan Evaluasi
Pemilihan scoring harus disesuaikan dengan tujuan machine learning.
Contohnya pada klasifikasi:
Apakah semua prediksi harus benar?
        ↓
    Accuracy
Jika fokus pada ketepatan prediksi positif:
Precision
Jika fokus pada menemukan sebanyak mungkin kasus positif:
Recall
Jika ingin mempertimbangkan precision dan recall secara bersamaan:
F1-score
Pada regresi:
Ingin proporsi variasi target yang dijelaskan?
        ↓
        R²
Jika ingin mengetahui rata-rata besar error dalam satuan target:
MAE
Jika ingin memberikan penalti lebih besar terhadap error yang besar:
MSE / RMSE
Cross-Validation Bukan Model Final
Hal penting lainnya adalah memahami bahwa:
cross_val_score()
digunakan untuk evaluasi, bukan menghasilkan satu model final yang siap digunakan sebagai model produksi.
Misalnya:
scores = cross_val_score(
    model,
    X,
    y,
    cv=5,
    scoring="accuracy"
)
Hasilnya adalah score dari beberapa fold:
Fold 1 → 0.82
Fold 2 → 0.84
Fold 3 → 0.80
Fold 4 → 0.83
Fold 5 → 0.81
Kemudian kita dapat menghitung:
np.mean(scores)
untuk memperoleh rata-rata score.
Jika setelah evaluasi kita sudah menentukan model dan hyperparameter yang akan digunakan, model final tetap perlu dilatih menggunakan data training yang sesuai.
Hindari Data Leakage
Jika preprocessing diperlukan, proses preprocessing sebaiknya dilakukan dengan benar di dalam proses cross-validation.
Contohnya, untuk scaling:
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression

model = Pipeline([
    ("scaler", StandardScaler()),
    ("model", LogisticRegression())
])
Kemudian:
scores = cross_val_score(
    model,
    X,
    y,
    cv=5,
    scoring="accuracy"
)
Dengan Pipeline, proses scaling dilakukan secara terpisah pada setiap training fold sehingga informasi dari validation fold tidak digunakan untuk mempelajari parameter preprocessing.
Ini membantu mencegah data leakage.
Alur Penggunaan scoring
Secara keseluruhan, workflow dapat digambarkan seperti berikut:
Dataset
   │
   ▼
Tentukan X dan y
   │
   ▼
Pilih Model
   │
   ▼
Tentukan Cross-Validation
   │
   ▼
Tentukan scoring
   │
   ├── accuracy
   ├── precision
   ├── recall
   ├── f1
   ├── r2
   ├── neg_mean_absolute_error
   └── neg_mean_squared_error
   │
   ▼
cross_val_score()
   │
   ▼
Score setiap Fold
   │
   ▼
Mean Score
   │
   ▼
Evaluasi Performa Model
Kesalahan yang Sering Terjadi
Menganggap scoring=None selalu Accuracy
Tidak selalu.
scoring=None
berarti cross_val_score() menggunakan scorer default dari estimator melalui .score().
Contoh umum:
Classifier → Accuracy
Regressor  → R²
Namun tetap periksa dokumentasi estimator yang digunakan jika ingin memastikan perilakunya.
Menganggap Negative MAE adalah MAE Sebenarnya
Jika hasil:
-2.31
jangan langsung mengatakan:
MAE = -2.31
MAE sebenarnya tidak bernilai negatif.
Gunakan:
mae = -np.mean(cv_mae)
sehingga:
MAE = 2.31
Membandingkan MAE dan MSE Secara Langsung
Misalnya:
MAE = 2.3
MSE = 8.4
Jangan menyimpulkan MSE lebih buruk hanya karena:
8.4 > 2.3
Keduanya memiliki skala dan satuan yang berbeda.
Menggunakan Metrik yang Tidak Sesuai Tujuan
Accuracy mungkin terlihat tinggi, tetapi belum tentu menjadi metrik yang paling informatif.
Misalnya dataset sangat tidak seimbang:
99% → Class 0
1%  → Class 1
Model yang selalu memprediksi Class 0 dapat memperoleh accuracy tinggi meskipun gagal menemukan Class 1.
Dalam situasi seperti ini, precision, recall, F1-score, atau metrik lain dapat memberikan informasi tambahan yang lebih relevan terhadap tujuan analisis.
Ringkasan
Parameter scoring pada cross_val_score() memungkinkan kita menentukan metrik evaluasi yang digunakan selama cross-validation.
Sintaks dasarnya:
cross_val_score(
    model,
    X,
    y,
    cv=5,
    scoring="accuracy"
)
Jika:
scoring=None
maka Scikit-Learn menggunakan scorer default dari estimator, yaitu metode .score().
Untuk klasifikasi, beberapa scoring yang umum adalah:
accuracy
precision
recall
f1
roc_auc
Untuk regresi:
r2
neg_mean_absolute_error
neg_mean_squared_error
neg_root_mean_squared_error
Metrik error menggunakan prefix neg_ karena Scikit-Learn menerapkan prinsip:
Higher is better
Sehingga:
Negative MAE
-1.5 → lebih baik
-2.5 → lebih buruk
Setelah dikonversi kembali:
MAE
1.5 → lebih baik
2.5 → lebih buruk
Cheat Sheet
Classification
cross_val_score(
    clf,
    X,
    y,
    cv=5,
    scoring="accuracy"
)
cross_val_score(
    clf,
    X,
    y,
    cv=5,
    scoring="precision"
)
cross_val_score(
    clf,
    X,
    y,
    cv=5,
    scoring="recall"
)
cross_val_score(
    clf,
    X,
    y,
    cv=5,
    scoring="f1"
)
Regression
cross_val_score(
    model,
    X,
    y,
    cv=5,
    scoring="r2"
)
cross_val_score(
    model,
    X,
    y,
    cv=5,
    scoring="neg_mean_absolute_error"
)
cross_val_score(
    model,
    X,
    y,
    cv=5,
    scoring="neg_mean_squared_error"
)
Kesimpulan
Parameter scoring memberikan fleksibilitas dalam mengevaluasi model menggunakan metrik yang sesuai dengan tujuan machine learning.
Hal terpenting yang perlu diingat:
cross_val_score()dapat melakukan evaluasi menggunakan beberapa fold.scoring=Nonemenggunakan scorer default dari estimator melalui.score().- Kita dapat menentukan metrik secara eksplisit menggunakan string.
- Classification dapat menggunakan accuracy, precision, recall, F1, ROC-AUC, dan metrik lainnya.
- Regression dapat menggunakan R², MAE, MSE, RMSE, dan metrik lainnya.
- Scikit-Learn menggunakan prinsip higher is better untuk
scoring. - Karena itu, metrik error seperti MAE dan MSE menggunakan bentuk
neg_. - Negative MAE atau Negative MSE perlu dikonversi kembali jika ingin mendapatkan nilai error positif.
- Model harus dibandingkan menggunakan metrik yang sama pada data evaluasi yang sama.
- Pemilihan scoring harus disesuaikan dengan tujuan dan karakteristik masalah machine learning.