Hyperparameter Tuning by Hand (Manual)
Setelah membuat baseline model, langkah berikutnya adalah mencoba meningkatkan performa model dengan melakukan hyperparameter tuning.
Pada materi sebelumnya kita telah mempelajari bahwa terdapat beberapa cara untuk melakukan tuning:
- Tuning secara manual atau by hand.
- Menggunakan
RandomizedSearchCV. - Menggunakan
GridSearchCV.
Pada materi ini kita akan fokus pada metode pertama:
Hyperparameter Tuning by Hand
Artinya, kita sendiri yang menentukan nilai hyperparameter, menjalankan model, mengevaluasi hasilnya, kemudian mencoba konfigurasi lainnya.
Secara sederhana:
Baseline Model
      ↓
   Evaluate
      ↓
Ubah Hyperparameter
      ↓
  Train Again
      ↓
 Evaluate Again
      ↓
  Bandingkan
      ↓
   Ulangi
Pendekatan ini sederhana dan sangat baik untuk memahami bagaimana hyperparameter memengaruhi performa model sebelum menggunakan metode tuning otomatis.
Mengapa Membutuhkan Validation Set?
Ketika kita hanya memiliki:
Training Set
Test Set
kita dapat menggunakan training set untuk melatih model dan test set untuk evaluasi.
Namun, jika kita terus-menerus melihat hasil test set untuk memilih hyperparameter terbaik, keputusan tuning secara tidak langsung mulai menyesuaikan model terhadap test set.
Karena itu, dalam konsep pembelajaran tiga pembagian data, kita dapat menggunakan:
Training Set
Validation Set
Test Set
Ketiga bagian tersebut memiliki fungsi berbeda.
Tiga Pembagian Data
Secara umum:
Dataset
   │
   ├───────────────┬───────────────┐
   ▼               ▼               ▼
Training       Validation        Test
  70-80%         10-15%         10-15%
   │               │               │
   ▼               ▼               ▼
Training         Tuning          Final
 Model          Selection      Evaluation
Persentase tersebut bukan aturan mutlak.
Pembagian aktual dapat disesuaikan dengan ukuran dataset, karakteristik data, dan metode evaluasi yang digunakan.
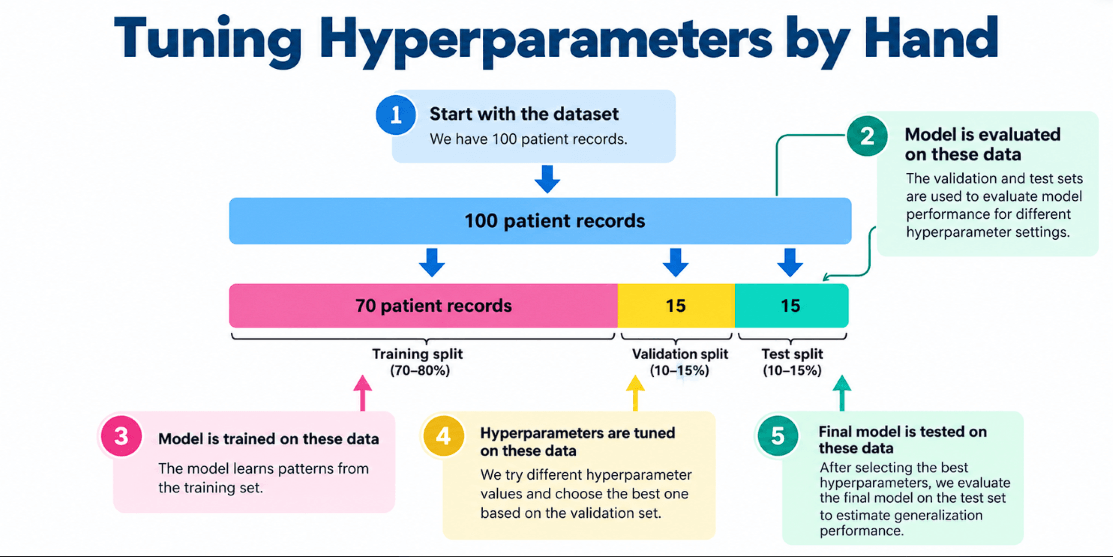
Training Set
Training set adalah data yang digunakan model untuk mempelajari pola.
Contohnya:
70% Training Data
Model akan melakukan:
model.fit(X_train, y_train)
Data training digunakan untuk mempelajari parameter internal model.
Analogi sederhananya adalah:
Training set seperti materi perkuliahan atau catatan yang digunakan untuk belajar.
Validation Set
Validation set digunakan untuk mengevaluasi model selama proses eksperimen dan membantu memilih konfigurasi model atau hyperparameter.
Contohnya:
15% Validation Data
Setelah model dilatih:
model.fit(X_train, y_train)
kita dapat mengevaluasinya:
y_valid_preds = model.predict(X_valid)
Kemudian:
evaluate_preds(
    y_valid,
    y_valid_preds
)
Validation set dapat dianalogikan sebagai:
Ujian latihan atau try out sebelum ujian akhir.
Kita dapat menggunakan hasil validation set untuk menentukan konfigurasi model yang akan digunakan.
Test Set
Test set digunakan untuk evaluasi akhir terhadap model yang sudah dipilih.
Contohnya:
15% Test Data
Idealnya, test set tidak digunakan berulang kali untuk memilih hyperparameter.
Setelah proses tuning selesai:
Best Configuration
       ↓
  Final Model
       ↓
   Test Set
       ↓
Final Evaluation
Analogi sederhananya:
Test set seperti ujian akhir.
Analogi Train, Validation, dan Test
Bayangkan kita sedang belajar untuk ujian.
Training
   ↓
Belajar materi

Validation
   ↓
Try Out
   ↓
Perbaiki strategi belajar

 Test
   ↓
Ujian Akhir
Jika kita terus melihat soal ujian akhir selama belajar, hasil ujian tidak lagi menjadi evaluasi yang benar-benar independen.
Hal yang sama berlaku pada Machine Learning.
Parameter vs Hyperparameter
Sebelum melakukan tuning, kita perlu mengingat kembali perbedaan antara parameter dan hyperparameter.
Parameters
Parameter dipelajari oleh model dari data training.
Contohnya:
Model
  ↓
Training Data
  ↓
Learn Parameters
Contoh pada model linear:
weight
coefficient
intercept
Hyperparameters
Hyperparameter merupakan konfigurasi yang kita tentukan untuk mengatur model.
Contohnya pada Random Forest:
RandomForestClassifier(
    n_estimators=100,
    max_depth=10
)
Beberapa hyperparameter yang dapat disesuaikan:
n_estimators
max_depth
max_features
min_samples_leaf
min_samples_split
RandomForestClassifier
Pada materi ini kita menggunakan:
RandomForestClassifier
Random Forest merupakan ensemble method yang terdiri dari banyak decision tree.
Secara sederhana:
Random Forest
      │
      ├── Decision Tree 1
      ├── Decision Tree 2
      ├── Decision Tree 3
      ├── Decision Tree 4
      └── ...
              │
              ▼
        Final Prediction
Beberapa hyperparameter Random Forest dapat memengaruhi kompleksitas, kapasitas, dan proses pembentukan forest.
Hyperparameter n_estimators
n_estimators menentukan jumlah tree yang digunakan dalam Random Forest.
Contoh:
RandomForestClassifier(
    n_estimators=100
)
Artinya model menggunakan 100 decision tree.
Contoh konfigurasi:
n_estimators=50
n_estimators=100
n_estimators=200
Semakin besar nilai n_estimators, jumlah tree yang dilatih semakin banyak sehingga waktu dan sumber daya komputasi juga dapat meningkat.
Penambahan tree dapat membantu performa sampai titik tertentu, tetapi tidak berarti semakin banyak tree selalu menghasilkan peningkatan performa yang signifikan.
Hyperparameter max_depth
max_depth menentukan kedalaman maksimum setiap decision tree.
Contoh:
RandomForestClassifier(
    max_depth=5
)
atau:
RandomForestClassifier(
    max_depth=10
)
Secara sederhana:
max_depth kecil
      ↓
Tree lebih dangkal
      ↓
Model lebih terbatas

max_depth besar
      ↓
Tree dapat lebih dalam
      ↓
Model dapat mempelajari pola lebih kompleks
Nilai yang terlalu kecil dapat menyebabkan model terlalu sederhana.
Nilai yang terlalu besar dapat meningkatkan kompleksitas dan berpotensi menyebabkan overfitting.
Hyperparameter max_features
max_features menentukan jumlah fitur yang dipertimbangkan ketika mencari split pada node.
Contoh:
RandomForestClassifier(
    max_features="sqrt"
)
atau nilai tertentu:
RandomForestClassifier(
    max_features=5
)
Hyperparameter ini memengaruhi seberapa banyak fitur yang dipertimbangkan dalam proses pembentukan setiap tree.
Hyperparameter min_samples_leaf
min_samples_leaf menentukan jumlah minimum sampel yang harus dimiliki oleh sebuah leaf node.
Contoh:
RandomForestClassifier(
    min_samples_leaf=2
)
Jika nilai ini diperbesar, leaf harus memiliki lebih banyak sampel.
Secara umum, pengaturan ini dapat membantu membatasi kompleksitas tree.
Hyperparameter min_samples_split
min_samples_split menentukan jumlah minimum sampel yang diperlukan agar sebuah node dapat dibagi menjadi child nodes.
Contoh:
RandomForestClassifier(
    min_samples_split=5
)
Misalnya:
min_samples_split = 2
maka node dapat dibagi dengan minimal 2 sampel.
Jika:
min_samples_split = 10
maka diperlukan minimal 10 sampel agar node dapat dibagi.
Melihat Hyperparameters
Scikit-Learn menyediakan:
get_params()
untuk melihat konfigurasi estimator.
Contoh:
from sklearn.ensemble import RandomForestClassifier

clf = RandomForestClassifier()

clf.get_params()
Hasilnya berupa dictionary yang berisi berbagai konfigurasi.
Contoh sebagian:
{
    'n_estimators': 100,
    'criterion': 'gini',
    'max_depth': None,
    'min_samples_split': 2,
    'min_samples_leaf': 1,
    ...
}
Nilai default dapat berbeda berdasarkan versi Scikit-Learn yang digunakan.
Mengambil Hyperparameter Tertentu
Kita dapat menyimpan hasil get_params():
params = clf.get_params()
Kemudian mengambil nilai tertentu:
print(params["n_estimators"])
Contoh:
100
Kita juga dapat melihat:
print(params["max_depth"])
atau:
print(params["min_samples_split"])
Cara ini berguna untuk memeriksa konfigurasi model sebelum melakukan eksperimen.
Membuat Fungsi Evaluasi
Ketika melakukan tuning secara manual, kita akan melatih dan mengevaluasi model berkali-kali.
Jika kita menulis kode evaluasi secara berulang:
accuracy_score(...)
precision_score(...)
recall_score(...)
f1_score(...)
kode dapat menjadi panjang dan berulang.
Untuk menghindarinya, kita dapat membuat sebuah fungsi.
Contoh:
from sklearn.metrics import (
    accuracy_score,
    precision_score,
    recall_score,
    f1_score
)

def evaluate_preds(y_true, y_preds):
    accuracy = accuracy_score(y_true, y_preds)
    precision = precision_score(y_true, y_preds)
    recall = recall_score(y_true, y_preds)
    f1 = f1_score(y_true, y_preds)

    metric_dict = {
        "accuracy": accuracy,
        "precision": precision,
        "recall": recall,
        "f1": f1
    }

    print(f"Accuracy : {accuracy:.2f}")
    print(f"Precision: {precision:.2f}")
    print(f"Recall   : {recall:.2f}")
    print(f"F1 Score : {f1:.2f}")

    return metric_dict
Sekarang fungsi tersebut dapat digunakan berkali-kali.
Prinsip DRY
Pendekatan tersebut menerapkan prinsip:
DRY
Don't Repeat Yourself
Daripada menulis:
accuracy_score(...)
precision_score(...)
recall_score(...)
f1_score(...)
berulang kali untuk setiap model, kita cukup memanggil:
evaluate_preds(
    y_valid,
    y_valid_preds
)
Dengan demikian, eksperimen menjadi lebih mudah dibaca dan dipelihara.
Menyiapkan Dataset
Misalnya kita memiliki DataFrame:
heart_disease
dengan target:
target
Kita dapat mengacak data terlebih dahulu.
heart_disease_shuffled = heart_disease.sample(
    frac=1,
    random_state=42
)
Parameter:
frac=1
berarti seluruh data digunakan, tetapi urutannya diacak.
random_state=42 membuat proses pengacakan dapat direproduksi.
Memisahkan Features dan Target
Setelah data diacak, pisahkan features dan target dari DataFrame yang sudah diacak.
X = heart_disease_shuffled.drop(
    "target",
    axis=1
)

y = heart_disease_shuffled["target"]
Sekarang:
X → Features
y → Target
Hal ini penting karena kita nantinya menggunakan slicing:
X[:train_split]
dan:
y[:train_split]
Jika X dan y dibuat dari DataFrame asli yang belum diacak, maka pembagian data tidak mengikuti urutan heart_disease_shuffled.
Memeriksa Jumlah Data
Kita dapat memeriksa jumlah seluruh data:
len(heart_disease_shuffled)
Misalnya hasilnya:
303
Kita kemudian akan membaginya menjadi:
Training   → 70%
Validation → 15%
Test       → 15%
Menghitung Batas Pembagian Data
Kita dapat menentukan indeks batas menggunakan:
train_split = round(
    0.7 * len(heart_disease_shuffled)
)

valid_split = round(
    train_split + 0.15 * len(heart_disease_shuffled)
)
Misalnya jumlah data:
303
Maka:
70% × 303 ≈ 212
15% × 303 ≈ 45
Sehingga validation berakhir sekitar:
212 + 45 = 257
Data dapat dibagi menjadi:
0 ───────────────── 212 ───────────── 257 ─────────── 303
│                   │                 │                │
│     Training      │   Validation    │      Test      │
│       70%         │      15%        │      15%       │
Full Code Pembagian Train, Validation, dan Test
Berikut adalah kode lengkap untuk membagi data menjadi training, validation, dan test set secara manual:
# Shuffle the data
heart_disease_shuffled = heart_disease.sample(
    frac=1,
    random_state=42
)

# Separate features and target
X = heart_disease_shuffled.drop(
    "target",
    axis=1
)

y = heart_disease_shuffled["target"]

# Split data into train, validation & test sets
train_split = round(
    0.7 * len(heart_disease_shuffled)
)  # 70% of data

valid_split = round(
    train_split + 0.15 * len(heart_disease_shuffled)
)  # 15% of data

X_train, y_train = X[:train_split], y[:train_split]

X_valid, y_valid = (
    X[train_split:valid_split],
    y[train_split:valid_split]
)

X_test, y_test = X[valid_split:], y[valid_split:]
Kode tersebut menghasilkan enam variabel:
X_train
y_train

X_valid
y_valid

X_test
y_test
Pembagiannya:
X_train, y_train
        ↓
    Training Set
       70%

X_valid, y_valid
        ↓
   Validation Set
       15%

X_test, y_test
        ↓
      Test Set
       15%
Memeriksa Hasil Pembagian
Setelah melakukan split, kita dapat memeriksa ukuran masing-masing dataset:
print(f"Training data  : {X_train.shape}")
print(f"Validation data: {X_valid.shape}")
print(f"Test data      : {X_test.shape}")
Kita juga dapat memeriksa target:
print(f"Training target  : {y_train.shape}")
print(f"Validation target: {y_valid.shape}")
print(f"Test target      : {y_test.shape}")
Untuk dataset dengan 303 samples, hasilnya kurang lebih:
Training data  : (212, ...)
Validation data: (45, ...)
Test data      : (46, ...)
Perbedaan satu sample dapat terjadi karena penggunaan round() pada batas indeks.
Mengapa Menggunakan round()?
Pada kode:
train_split = round(
    0.7 * len(heart_disease_shuffled)
)
kita mendapatkan indeks integer yang digunakan untuk slicing.
Misalnya:
0.7 × 303 = 212.1
Kemudian:
round(212.1)
menghasilkan:
212
Begitu juga dengan validation split.
Cara ini memudahkan pembagian data secara manual berdasarkan persentase.
Membuat Baseline Model
Setelah data dibagi, kita dapat membuat baseline model.
Contoh:
from sklearn.ensemble import RandomForestClassifier

clf = RandomForestClassifier(
    random_state=42
)
Kemudian training:
clf.fit(
    X_train,
    y_train
)
Membuat Baseline Predictions
Setelah model selesai dilatih:
y_valid_preds = clf.predict(
    X_valid
)
Sekarang kita dapat mengevaluasi baseline.
baseline_metrics = evaluate_preds(
    y_valid,
    y_valid_preds
)
Contoh output:
Accuracy : 0.78
Precision: 0.80
Recall   : 0.76
F1 Score : 0.78
Angka tersebut hanya contoh.
Yang penting adalah kita memiliki baseline sebagai titik pembanding.
Eksperimen Hyperparameter Pertama
Sekarang kita dapat membuat model kedua.
Misalnya kita ingin mengubah:
n_estimators
menjadi:
100
Contoh:
clf_2 = RandomForestClassifier(
    n_estimators=100,
    random_state=42
)
Kemudian:
clf_2.fit(
    X_train,
    y_train
)
Buat prediksi:
y_valid_preds_2 = clf_2.predict(
    X_valid
)
Kemudian evaluasi:
clf_2_metrics = evaluate_preds(
    y_valid,
    y_valid_preds_2
)
Membandingkan Baseline dan Model Kedua
Misalnya:
Baseline

Accuracy : 0.78
Precision: 0.80
Recall   : 0.76
F1 Score : 0.78
Model kedua:
n_estimators = 100

Accuracy : 0.81
Precision: 0.83
Recall   : 0.78
F1 Score : 0.80
Kita dapat membandingkan hasil tersebut:
Metric       Baseline    Model 2
---------------------------------
Accuracy       0.78       0.81
Precision      0.80       0.83
Recall         0.76       0.78
F1             0.78       0.80
Dalam contoh tersebut, konfigurasi kedua menghasilkan nilai yang lebih tinggi pada metrik-metrik yang diamati.
Namun, keputusan model terbaik sebaiknya mempertimbangkan tujuan problem dan evaluasi yang digunakan, bukan hanya satu angka.
Mencoba Hyperparameter Lain
Setelah mencoba:
n_estimators=100
kita dapat mencoba konfigurasi lain.
Misalnya:
clf_3 = RandomForestClassifier(
    n_estimators=200,
    random_state=42
)
Kemudian:
clf_3.fit(
    X_train,
    y_train
)

y_valid_preds_3 = clf_3.predict(
    X_valid
)

clf_3_metrics = evaluate_preds(
    y_valid,
    y_valid_preds_3
)
Kita dapat mengulang proses tersebut untuk berbagai konfigurasi.
Eksperimen Beberapa Hyperparameter
Tidak hanya n_estimators, kita juga dapat mencoba:
clf = RandomForestClassifier(
    n_estimators=200,
    max_depth=10,
    min_samples_split=5,
    min_samples_leaf=2,
    random_state=42
)
Kemudian:
clf.fit(
    X_train,
    y_train
)

y_valid_preds = clf.predict(
    X_valid
)

metrics = evaluate_preds(
    y_valid,
    y_valid_preds
)
Dengan cara ini kita dapat melihat pengaruh kombinasi beberapa hyperparameter.
Membuat Tabel Eksperimen
Agar eksperimen lebih mudah dilacak, kita dapat membuat tabel:
| Model | n_estimators | max_depth | Accuracy | Precision | Recall | F1 |
|---|---|---|---|---|---|---|
| Baseline | Default | Default | 0.78 | 0.80 | 0.76 | 0.78 |
| Model 2 | 100 | Default | 0.81 | 0.83 | 0.78 | 0.80 |
| Model 3 | 200 | 10 | 0.82 | 0.84 | 0.79 | 0.81 |
Tabel seperti ini sangat membantu dalam proses eksperimen.
Mengapa Tuning by Hand Bisa Melelahkan?
Bayangkan kita memiliki:
n_estimators → 5 pilihan
max_depth → 5 pilihan
min_samples_split → 5 pilihan
min_samples_leaf → 5 pilihan
Jumlah kombinasi:
5 × 5 × 5 × 5
= 625 kombinasi
Jika setiap konfigurasi harus dibuat dan diuji secara manual, prosesnya akan sangat panjang.
Kita juga berisiko:
- Lupa konfigurasi yang sudah dicoba.
- Salah mencatat hasil.
- Menulis banyak kode yang sama.
- Membutuhkan waktu lebih lama.
- Tidak sistematis dalam mengeksplorasi ruang hyperparameter.
Kelebihan Tuning by Hand
Meskipun sederhana, manual tuning memiliki beberapa kelebihan.
Mudah Dipahami
Kita dapat melihat secara langsung:
Hyperparameter
      ↓
    Model
      ↓
   Training
      ↓
  Evaluation
Hal ini sangat baik untuk belajar konsep hyperparameter.
Cocok untuk Eksperimen Kecil
Jika hanya ingin mencoba beberapa konfigurasi:
n_estimators = 100
n_estimators = 200
n_estimators = 300
manual tuning masih cukup praktis.
Membantu Memahami Model
Dengan mencoba nilai yang berbeda, kita dapat memahami bagaimana hyperparameter tertentu memengaruhi model.
Kekurangan Tuning by Hand
Membutuhkan Banyak Waktu
Semakin banyak hyperparameter, semakin banyak eksperimen yang harus dilakukan.
Sulit Jika Kombinasi Sangat Banyak
Contoh:
10 × 10 × 10
= 1.000 kombinasi
Tidak praktis jika semuanya diuji secara manual.
Risiko Human Error
Karena proses dilakukan manual, kita dapat:
- Salah menulis nilai.
- Salah mencatat hasil.
- Lupa konfigurasi.
- Salah membandingkan eksperimen.
Validation Set sebagai Dasar Pemilihan Model
Selama proses tuning manual:
Training Set
     ↓
Train Model
     ↓
Validation Set
     ↓
 Evaluate
     ↓
Ubah Hyperparameter
     ↓
Train Again
     ↓
Validation Again
Validation set digunakan untuk membantu memilih konfigurasi.
Setelah konfigurasi terbaik dipilih, test set dapat digunakan untuk evaluasi akhir.
Evaluasi Final pada Test Set
Misalnya setelah beberapa eksperimen kita memilih konfigurasi:
best_model = RandomForestClassifier(
    n_estimators=200,
    max_depth=10,
    random_state=42
)
Model tersebut kemudian dilatih pada data training yang sesuai:
best_model.fit(
    X_train,
    y_train
)
Setelah konfigurasi final dipilih, kita dapat mengevaluasi model pada test set:
y_test_preds = best_model.predict(
    X_test
)
Kemudian:
final_metrics = evaluate_preds(
    y_test,
    y_test_preds
)
Test set digunakan sebagai evaluasi akhir yang tidak dijadikan target tuning berulang kali.
Catatan tentang Tiga Data Split
Pembagian:
70% Train
15% Validation
15% Test
hanyalah contoh.
Tidak ada aturan universal bahwa dataset Machine Learning harus selalu dibagi persis seperti itu.
Pembagian aktual dapat disesuaikan dengan:
- Ukuran dataset.
- Karakteristik data.
- Kebutuhan eksperimen.
- Metode evaluasi.
- Ketersediaan data.
Untuk dataset kecil, menyisihkan validation set secara manual dapat mengurangi jumlah data yang tersedia untuk training.
Dalam praktik modern, cross-validation sering digunakan sebagai alternatif untuk memperoleh estimasi validasi yang lebih efisien, terutama ketika data terbatas.
Workflow Lengkap Hyperparameter Tuning by Hand
Secara keseluruhan:
                    Dataset
                       │
                       ▼
                Shuffle Data
                       │
                       ▼
             Split Train/Valid/Test
                       │
        ┌──────────────┼──────────────┐
        ▼              ▼              ▼
     Training       Validation       Test
        │              │              │
        ▼              │              │
  Baseline Model       │              │
        │              │              │
        ▼              │              │
    Predictions ───────┘              │
        │                             │
        ▼                             │
    Evaluation                        │
        │                             │
        ▼                             │
  Change Hyperparameters              │
        │                             │
        ▼                             │
   Train Again ───────────────────────┘
        │
        ▼
 Validation Evaluation
        │
        ▼
 Select Configuration
        │
        ▼
 Final Evaluation on Test Set
Full Code Hyperparameter Tuning by Hand
Berikut contoh kode lengkap yang menggabungkan proses:
1. Shuffle data
2. Membuat X dan y
3. Membagi train, validation, dan test
4. Membuat fungsi evaluasi
5. Membuat baseline model
6. Membuat model dengan hyperparameter berbeda
7. Membandingkan hasil
import pandas as pd
import numpy as np

from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import (
    accuracy_score,
    precision_score,
    recall_score,
    f1_score
)

# ==========================================
# 1. Shuffle the data
# ==========================================

heart_disease_shuffled = heart_disease.sample(
    frac=1,
    random_state=42
)

# ==========================================
# 2. Separate features and target
# ==========================================

X = heart_disease_shuffled.drop(
    "target",
    axis=1
)

y = heart_disease_shuffled["target"]

# ==========================================
# 3. Split data into train,
#    validation & test sets
# ==========================================

train_split = round(
    0.7 * len(heart_disease_shuffled)
)  # 70% of data

valid_split = round(
    train_split + 0.15 * len(heart_disease_shuffled)
)  # 15% of data

X_train, y_train = X[:train_split], y[:train_split]

X_valid, y_valid = (
    X[train_split:valid_split],
    y[train_split:valid_split]
)

X_test, y_test = X[valid_split:], y[valid_split:]

# ==========================================
# 4. Evaluation function
# ==========================================

def evaluate_preds(y_true, y_preds):
    accuracy = accuracy_score(
        y_true,
        y_preds
    )

    precision = precision_score(
        y_true,
        y_preds
    )

    recall = recall_score(
        y_true,
        y_preds
    )

    f1 = f1_score(
        y_true,
        y_preds
    )

    metrics = {
        "accuracy": accuracy,
        "precision": precision,
        "recall": recall,
        "f1": f1
    }

    print(f"Accuracy : {accuracy:.2f}")
    print(f"Precision: {precision:.2f}")
    print(f"Recall   : {recall:.2f}")
    print(f"F1 Score : {f1:.2f}")

    return metrics

# ==========================================
# 5. Baseline model
# ==========================================

clf = RandomForestClassifier(
    random_state=42
)

clf.fit(
    X_train,
    y_train
)

# Baseline predictions
y_valid_preds = clf.predict(
    X_valid
)

# Baseline evaluation
baseline_metrics = evaluate_preds(
    y_valid,
    y_valid_preds
)

# ==========================================
# 6. Model with tuned hyperparameters
# ==========================================

clf_2 = RandomForestClassifier(
    n_estimators=100,
    random_state=42
)

clf_2.fit(
    X_train,
    y_train
)

# Predictions
y_valid_preds_2 = clf_2.predict(
    X_valid
)

# Evaluation
clf_2_metrics = evaluate_preds(
    y_valid,
    y_valid_preds_2
)

# ==========================================
# 7. Another configuration
# ==========================================

clf_3 = RandomForestClassifier(
    n_estimators=200,
    max_depth=10,
    random_state=42
)

clf_3.fit(
    X_train,
    y_train
)

# Predictions
y_valid_preds_3 = clf_3.predict(
    X_valid
)

# Evaluation
clf_3_metrics = evaluate_preds(
    y_valid,
    y_valid_preds_3
)

# ==========================================
# 8. Display comparison
# ==========================================

results = pd.DataFrame({
    "Baseline": baseline_metrics,
    "Model 2": clf_2_metrics,
    "Model 3": clf_3_metrics
})

print(results)
Kode tersebut menunjukkan pola dasar tuning manual:
Model 1
   ↓
Evaluate

Model 2
   ↓
Evaluate

Model 3
   ↓
Evaluate

Compare Results
Full Code Evaluasi Model Final
Setelah melakukan beberapa eksperimen dan memilih konfigurasi model berdasarkan validation set, model final dapat dievaluasi pada test set.
Contoh:
# Create final model using the selected configuration
final_model = RandomForestClassifier(
    n_estimators=200,
    max_depth=10,
    random_state=42
)

# Train final model
final_model.fit(
    X_train,
    y_train
)

# Make predictions on test data
y_test_preds = final_model.predict(
    X_test
)

# Final evaluation
final_metrics = evaluate_preds(
    y_test,
    y_test_preds
)

print("\nFinal Test Metrics:")
print(final_metrics)
Alurnya:
Training Set
     │
     ▼
Final Model
     │
     ▼
Test Set
     │
     ▼
Final Predictions
     │
     ▼
Final Metrics
Test set pada tahap ini digunakan untuk memperoleh gambaran performa akhir model terhadap data yang tidak digunakan untuk memilih konfigurasi selama tuning.
Mengapa Test Set Tidak Digunakan Saat Tuning?
Misalnya kita melakukan:
Model A → Test Score
Model B → Test Score
Model C → Test Score
Model D → Test Score
Kemudian memilih model berdasarkan test score.
Walaupun model tidak dilatih langsung menggunakan test set, keputusan kita sudah menggunakan informasi dari test set.
Jika proses tersebut dilakukan berkali-kali, test set tidak lagi menjadi evaluasi akhir yang benar-benar independen.
Lebih baik:
Training Set
     ↓
 Training

Validation Set
     ↓
Tuning & Selection

 Test Set
     ↓
Final Evaluation
Kelebihan Tuning by Hand
Meskipun sederhana, manual tuning memiliki beberapa kelebihan.
Mudah Dipahami
Kita dapat melihat secara langsung:
Hyperparameter
      ↓
    Model
      ↓
   Training
      ↓
  Evaluation
Hal ini sangat baik untuk belajar konsep hyperparameter.
Cocok untuk Eksperimen Kecil
Jika hanya ingin mencoba beberapa konfigurasi:
n_estimators = 100
n_estimators = 200
n_estimators = 300
manual tuning masih cukup praktis.
Membantu Memahami Model
Dengan mencoba nilai yang berbeda, kita dapat memahami bagaimana hyperparameter tertentu memengaruhi model.
Kekurangan Tuning by Hand
Membutuhkan Banyak Waktu
Semakin banyak hyperparameter, semakin banyak eksperimen yang harus dilakukan.
Sulit Jika Kombinasi Sangat Banyak
Contoh:
10 × 10 × 10
= 1.000 kombinasi
Tidak praktis jika semuanya diuji secara manual.
Risiko Human Error
Karena proses dilakukan manual, kita dapat:
- Salah menulis nilai.
- Salah mencatat hasil.
- Lupa konfigurasi.
- Salah membandingkan eksperimen.
Checklist Hyperparameter Tuning by Hand
Sebelum melakukan tuning manual, pastikan:
- Sudah memiliki baseline model.
- Training set sudah ditentukan.
- Validation set sudah ditentukan.
- Test set disimpan untuk evaluasi akhir.
- Metric evaluasi sudah ditentukan.
- Hyperparameter yang akan diuji sudah ditentukan.
- Setiap eksperimen dicatat.
- Konfigurasi dibandingkan menggunakan prosedur evaluasi yang konsisten.
- Tidak menggunakan test set sebagai target tuning berulang kali.
- Model final dievaluasi pada test set setelah proses tuning selesai.
Ringkasan
Hyperparameter tuning by hand merupakan pendekatan paling sederhana untuk melakukan optimasi model.
Prosesnya:
1. Buat baseline
2. Train model
3. Evaluasi validation set
4. Ubah hyperparameter
5. Train kembali
6. Evaluasi kembali
7. Bandingkan hasil
8. Pilih konfigurasi
9. Evaluasi final pada test set
Pada RandomForestClassifier, beberapa hyperparameter yang dapat diuji adalah:
n_estimators
max_depth
max_features
min_samples_leaf
min_samples_split
Untuk menghindari pengulangan kode evaluasi, kita dapat membuat fungsi:
evaluate_preds()
Kemudian menggunakannya pada setiap eksperimen.
Cheat Sheet
Shuffle Data
heart_disease_shuffled = heart_disease.sample(
    frac=1,
    random_state=42
)
Membuat Features dan Target
X = heart_disease_shuffled.drop(
    "target",
    axis=1
)

y = heart_disease_shuffled["target"]
Membagi Data
train_split = round(
    0.7 * len(heart_disease_shuffled)
)

valid_split = round(
    train_split + 0.15 * len(heart_disease_shuffled)
)

X_train, y_train = X[:train_split], y[:train_split]

X_valid, y_valid = (
    X[train_split:valid_split],
    y[train_split:valid_split]
)

X_test, y_test = X[valid_split:], y[valid_split:]
Membuat Model
model = RandomForestClassifier(
    n_estimators=200,
    max_depth=10,
    random_state=42
)
Training
model.fit(
    X_train,
    y_train
)
Prediction
y_valid_preds = model.predict(
    X_valid
)
Evaluation
evaluate_preds(
    y_valid,
    y_valid_preds
)
Melihat Hyperparameters
model.get_params()
Evaluasi Final
y_test_preds = model.predict(
    X_test
)

evaluate_preds(
    y_test,
    y_test_preds
)
Kesimpulan
Hyperparameter tuning by hand membantu kita memahami bahwa performa model Machine Learning dapat dipengaruhi oleh konfigurasi hyperparameter.
Prosesnya dilakukan secara iteratif:
Baseline
   ↓
Evaluation
   ↓
Change Hyperparameter
   ↓
Training
   ↓
Validation
   ↓
Compare
   ↓
Repeat
Dalam pendekatan tiga pembagian data:
Training Set
   ↓
Melatih model

Validation Set
   ↓
Memilih dan menyesuaikan model

Test Set
   ↓
Evaluasi akhir
Beberapa hyperparameter RandomForestClassifier yang dapat dieksperimenkan antara lain:
n_estimators
max_depth
max_features
min_samples_leaf
min_samples_split
Tuning secara manual sangat berguna untuk memahami konsep dasar, tetapi menjadi semakin tidak efisien ketika jumlah kombinasi hyperparameter bertambah.
Karena itu, setelah memahami tuning secara manual, kita dapat menggunakan pendekatan otomatis dari Scikit-Learn:
RandomizedSearchCV
GridSearchCV
Kedua metode tersebut memungkinkan proses pencarian hyperparameter dilakukan secara lebih sistematis dengan memanfaatkan cross-validation.
Pada Materi Berikutnya
Pada materi berikutnya kita akan mempelajari Hyperparameter Tuning menggunakan RandomizedSearchCV, mulai dari membuat param_distributions, menentukan jumlah percobaan dengan n_iter, menggunakan cross-validation, menentukan scoring, hingga mendapatkan konfigurasi terbaik melalui best_params_.