Evaluasi Classification Model: Accuracy
Setelah model klasifikasi selesai dilatih, kita perlu mengevaluasi seberapa baik model tersebut melakukan prediksi.
Dalam Machine Learning, terdapat beberapa classification metrics yang umum digunakan untuk mengevaluasi model, antara lain:
- Accuracy
- Area Under ROC Curve (AUC / ROC-AUC)
- Confusion Matrix
- Classification Report
Setiap metrik memberikan sudut pandang yang berbeda terhadap performa model. Oleh karena itu, kita tidak selalu cukup hanya menggunakan satu metrik.
Pada materi ini, kita akan fokus terlebih dahulu pada Accuracy.
1. Apa Itu Accuracy?
Accuracy (akurasi) adalah metrik yang mengukur proporsi prediksi model yang benar dibandingkan dengan seluruh prediksi yang dilakukan.
Secara sederhana:
Accuracy menunjukkan seberapa banyak prediksi model yang benar dari seluruh sampel yang dievaluasi.
Rumus accuracy adalah:
Misalnya model melakukan prediksi terhadap 100 data dan terdapat 85 prediksi yang benar.
Maka:
atau:
Artinya, model menghasilkan prediksi yang benar pada 85 dari 100 sampel.
2. Accuracy pada Classification
Pada kasus klasifikasi, setiap prediksi dapat dibandingkan dengan label sebenarnya.
Misalnya kita mempunyai data:
| Data | Actual | Prediction | Benar? |
|---|---|---|---|
| A | 1 | 1 | Ya |
| B | 0 | 0 | Ya |
| C | 1 | 0 | Tidak |
| D | 0 | 0 | Ya |
| E | 1 | 1 | Ya |
Dari 5 sampel:
- 4 prediksi benar
- 1 prediksi salah
Maka:
atau:
3. Menghitung Accuracy dengan Scikit-Learn
Scikit-Learn menyediakan beberapa cara untuk menghitung accuracy.
Dua pendekatan yang umum adalah:
- Menggunakan
.score() - Menggunakan
cross_val_score()
4. Menggunakan .score()
Pada classifier yang digunakan dalam Scikit-Learn, metode .score() umumnya mengembalikan accuracy.
Contohnya:
accuracy = clf.score(X_test, y_test)

print(f"Accuracy: {accuracy * 100:.2f}%")
Misalnya hasilnya:
Accuracy: 85.00%
Artinya:
Model menghasilkan prediksi yang benar pada sekitar 85% sampel dalam
X_test.
Penting
Makna .score() bergantung pada estimator yang digunakan.
Untuk banyak classifier di Scikit-Learn:
clf.score(X_test, y_test)
menghasilkan accuracy.
Namun, .score() tidak selalu berarti accuracy untuk semua jenis model.
Misalnya pada banyak regressor:
model.score(X_test, y_test)
menghasilkan R² (coefficient of determination).
Karena itu, selalu perhatikan estimator yang digunakan.
5. Menggunakan cross_val_score()
Selain mengevaluasi model pada satu train-test split, kita juga dapat menggunakan Cross-Validation.
Contohnya:
import numpy as np
from sklearn.model_selection import cross_val_score

cross_val_acc = np.mean(
    cross_val_score(clf, X, y, cv=5)
)

print(f"Cross-Validated Accuracy: {cross_val_acc * 100:.2f}%")
Jika hasilnya:
Cross-Validated Accuracy: 84.50%
maka rata-rata accuracy dari 5 fold adalah sekitar 84.50%.
Apa yang terjadi pada cv=5?
Dengan:
cv=5
data dibagi menjadi 5 fold.
Secara sederhana:
Dataset
   │
   ├── Fold 1
   ├── Fold 2
   ├── Fold 3
   ├── Fold 4
   └── Fold 5
Model kemudian dievaluasi sebanyak 5 kali.
Setiap iterasi menggunakan:
- 4 fold untuk training
- 1 fold untuk validation
Proses tersebut dilakukan secara bergantian sampai setiap fold pernah menjadi validation set.
Hasil akhirnya berupa beberapa nilai accuracy:
Fold 1 → 0.82
Fold 2 → 0.86
Fold 3 → 0.85
Fold 4 → 0.84
Fold 5 → 0.86
Kemudian kita dapat menghitung rata-ratanya:
Hasilnya:
atau:
6. .score() vs cross_val_score()
Kedua pendekatan tersebut memiliki tujuan yang sedikit berbeda.
| Pendekatan | Tujuan |
|---|---|
.score() | Mengevaluasi model pada data tertentu |
cross_val_score() | Mengevaluasi model melalui beberapa fold |
.score() pada classifier | Umumnya accuracy |
.score() pada banyak regressor | R² |
cross_val_score() | Menghasilkan beberapa nilai score |
Contoh:
clf.score(X_test, y_test)
menghasilkan satu nilai.
Sedangkan:
cross_val_score(clf, X, y, cv=5)
dapat menghasilkan lima nilai:
[0.82, 0.86, 0.85, 0.84, 0.86]
Kita kemudian dapat melihat rata-rata dan penyebarannya:
scores = cross_val_score(clf, X, y, cv=5)

print("Scores:", scores)
print("Mean:", scores.mean())
print("Standard deviation:", scores.std())
7. Kapan Accuracy Cocok Digunakan?
Accuracy cukup informatif ketika distribusi kelas relatif seimbang.
Misalnya terdapat dataset klasifikasi:
| Kelas | Jumlah |
|---|---|
| Class 0 | 500 |
| Class 1 | 500 |
Total:
1000 data
Jika model mendapatkan accuracy 90%, maka secara umum angka tersebut memberikan gambaran yang cukup mudah dipahami tentang proporsi prediksi yang benar.
Namun, kita tetap perlu melihat metrik lain sesuai tujuan dan karakteristik masalah.
8. Masalah Accuracy pada Imbalanced Dataset
Accuracy dapat menjadi kurang informatif ketika dataset mengalami class imbalance.
Class imbalance terjadi ketika jumlah sampel antar kelas berbeda secara signifikan.
Contohnya:
Class 0 → 9.990 data
Class 1 →    10 data
Total:
10.000 data
Misalnya kasusnya adalah deteksi penyakit langka:
- 9.990 pasien sehat
- 10 pasien sakit
Sekarang bayangkan terdapat model yang selalu memprediksi:
Semua pasien → Sehat
Model tersebut tidak pernah mendeteksi pasien yang sakit.
Namun:
- 9.990 prediksi benar
- 10 prediksi salah
Maka:
atau:
Sekilas angka tersebut terlihat sangat tinggi.
Tetapi model sebenarnya gagal mendeteksi seluruh pasien yang sakit.
Inilah salah satu kelemahan accuracy pada dataset dengan ketidakseimbangan kelas yang ekstrem.
9. Mengapa Accuracy Bisa Menyesatkan?
Perhatikan contoh berikut:
Actual:

9990 → Sehat
  10 → Sakit
Model:
Semua → Sehat
Hasilnya:
Benar:
9990 pasien sehat

Salah:
10 pasien sakit
Accuracy:
99.9%
Tetapi:
Pasien sakit yang berhasil ditemukan = 0
Jadi, hanya melihat accuracy dapat membuat kita memperoleh gambaran yang tidak lengkap mengenai performa model.
Hal ini sangat penting terutama ketika kelas minoritas memiliki konsekuensi yang penting.
10. Accuracy Bukan Satu-Satunya Metrik
Dalam evaluasi classification model, accuracy sebaiknya dipandang sebagai salah satu metrik, bukan satu-satunya metrik.
Beberapa metrik lain yang sering digunakan adalah:
Confusion Matrix
Confusion Matrix menunjukkan jumlah:
- True Positive
- True Negative
- False Positive
- False Negative
Contoh:
                Predicted
              0          1
Actual  0    TN         FP
        1    FN         TP
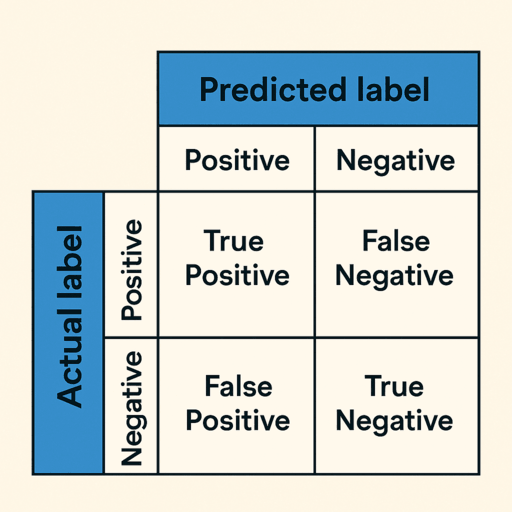
Confusion Matrix membantu kita melihat jenis kesalahan yang dilakukan model.
Precision
Precision menjawab pertanyaan:
Dari seluruh data yang diprediksi sebagai positif, berapa banyak yang benar-benar positif?
Rumus:
Recall
Recall menjawab pertanyaan:
Dari seluruh data yang sebenarnya positif, berapa banyak yang berhasil ditemukan model?
Rumus:
F1-Score
F1-score merupakan harmonic mean antara precision dan recall.
F1-score sering digunakan ketika kita ingin mempertimbangkan precision dan recall secara bersamaan.
ROC-AUC
ROC-AUC dapat digunakan untuk mengevaluasi kemampuan model dalam membedakan kelas berdasarkan berbagai threshold.
Metrik ini memberikan perspektif yang berbeda dari accuracy.
Pembahasan lebih detail mengenai ROC-AUC akan dilakukan pada materi berikutnya.
11. Accuracy pada Dataset Seimbang vs Tidak Seimbang
Perhatikan perbandingan berikut.
Dataset Seimbang
Class 0 → 500
Class 1 → 500
Misalnya:
Accuracy = 90%
Angka tersebut dapat memberikan gambaran yang cukup baik tentang jumlah prediksi yang benar.
Namun, tetap penting melihat confusion matrix dan metrik lainnya.
Dataset Tidak Seimbang
Class 0 → 9.990
Class 1 → 10
Model:
Selalu memprediksi Class 0
Menghasilkan:
Accuracy = 99.9%
Tetapi model tidak berhasil menemukan satu pun Class 1.
Situasi seperti ini menunjukkan bahwa accuracy saja tidak cukup untuk menggambarkan performa model.
12. Contoh Implementasi Accuracy
Misalnya kita menggunakan RandomForestClassifier.
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42,
    stratify=y
)

clf = RandomForestClassifier(
    n_estimators=100,
    random_state=42
)

clf.fit(X_train, y_train)

y_preds = clf.predict(X_test)
Kemudian kita dapat menghitung accuracy menggunakan accuracy_score:
accuracy = accuracy_score(y_test, y_preds)

print(f"Accuracy: {accuracy * 100:.2f}%")
Pendekatan ini secara eksplisit membandingkan:
y_test
   │
   │ dibandingkan
   ▼
y_preds
Kemudian menghitung proporsi prediksi yang benar.
13. Menggunakan accuracy_score
Scikit-Learn menyediakan fungsi:
from sklearn.metrics import accuracy_score
Kemudian:
accuracy_score(y_test, y_preds)
Contoh lengkap:
from sklearn.metrics import accuracy_score

y_preds = clf.predict(X_test)

accuracy = accuracy_score(y_test, y_preds)

print(f"Accuracy: {accuracy:.2f}")
print(f"Accuracy: {accuracy * 100:.2f}%")
Jika hasilnya:
Accuracy: 0.85
Accuracy: 85.00%
berarti sekitar 85% prediksi pada data evaluasi tersebut benar.
14. Accuracy dan Final Test Set
Jika kita sebelumnya telah menggunakan Cross-Validation untuk memilih model atau hyperparameter, final test set harus tetap disimpan.
Workflow-nya:
Dataset
   │
   ├───────────────┐
   ▼               ▼
Training Data    Final Test Data
   │               │
   ▼               │
Cross-Validation   │
   │               │
   ▼               │
Model /            │
Hyperparameter     │
Selection          │
   │               │
   ▼               │
Best Parameters    │
   │               │
   ▼               │
Retrain Final Model│
   │               │
   └───────┬───────┘
           ▼
   Final Test Evaluation
Final test set tidak digunakan untuk:
- training model,
- Cross-Validation,
- pemilihan model,
- pemilihan hyperparameter.
Final test set digunakan pada tahap evaluasi akhir.
Hal ini membantu memberikan estimasi performa model pada data yang belum digunakan dalam proses pemilihan model.
15. Hal yang Perlu Diingat
Beberapa poin penting mengenai accuracy:
- Accuracy menghitung proporsi prediksi yang benar.
- Accuracy dapat dihitung menggunakan
accuracy_score. - Pada banyak classifier,
.score()mengembalikan accuracy. cross_val_score()dapat digunakan untuk mengevaluasi accuracy melalui Cross-Validation.- Accuracy lebih mudah diinterpretasikan ketika distribusi kelas relatif seimbang.
- Accuracy dapat memberikan gambaran yang menyesatkan pada dataset dengan class imbalance ekstrem.
- Jangan hanya mengandalkan accuracy ketika kesalahan pada kelas tertentu memiliki konsekuensi yang berbeda.
- Confusion Matrix dapat membantu melihat jenis kesalahan model.
- Precision dan recall memberikan informasi yang tidak terlihat hanya dari accuracy.
- ROC-AUC memberikan perspektif tambahan mengenai kemampuan model membedakan kelas.
- Final test set sebaiknya tetap terpisah dari proses model selection dan hyperparameter tuning.
16. Ringkasan
Accuracy menjawab pertanyaan sederhana:
"Dari seluruh prediksi yang dilakukan model, berapa banyak yang benar?"
Rumusnya:
Contoh:
100 prediksi
85 benar
15 salah
Maka:
Accuracy = 85%
Namun, accuracy tidak selalu cukup.
Pada dataset dengan class imbalance, model dapat memperoleh accuracy sangat tinggi tetapi gagal mendeteksi kelas minoritas.
Karena itu, evaluasi classification model biasanya melibatkan beberapa metrik:
Classification Metrics
        │
        ├── Accuracy
        ├── ROC-AUC
        ├── Confusion Matrix
        └── Classification Report
Setiap metrik memberikan informasi yang berbeda mengenai performa model.