Scikit-Learn Workflow & Cheatsheet
Setelah mengenal Scikit-Learn pada materi sebelumnya, sekarang kita akan mempelajari Scikit-Learn Workflow & Cheatsheet.
Workflow merupakan urutan proses yang biasanya dilakukan ketika membangun model Machine Learning.
Secara sederhana:
Workflow ini akan menjadi pola dasar yang akan sering kita gunakan ketika membangun model Machine Learning menggunakan Scikit-Learn.
Tujuan Pembelajaran
Setelah mempelajari materi ini, kita diharapkan dapat:
- Memahami workflow Machine Learning menggunakan Scikit-Learn.
- Memisahkan feature dan target.
- Membagi dataset menjadi training dan testing.
- Memahami konsep estimator dan model.
- Melatih model menggunakan
fit(). - Membuat prediksi menggunakan
predict(). - Memahami
predict_proba(). - Melakukan evaluasi menggunakan
score(). - Memahami cross-validation.
- Menggunakan berbagai evaluation metrics.
- Memahami konsep hyperparameter tuning.
- Menyimpan dan memuat kembali model.
- Memahami pentingnya eksperimen dalam Machine Learning.
Gambaran Besar Workflow Scikit-Learn
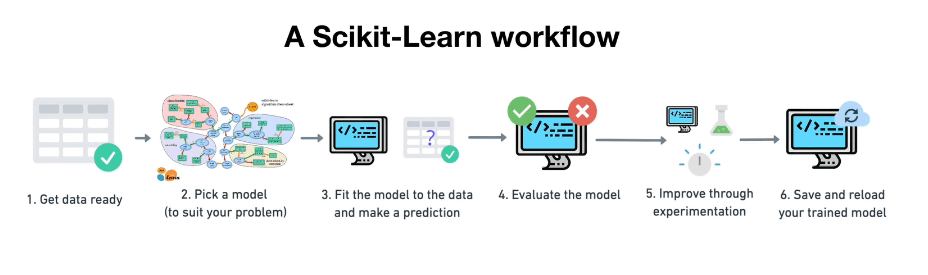
Workflow utama dapat digambarkan sebagai berikut:
Tidak semua proyek harus mengikuti diagram tersebut secara persis.
Namun, diagram tersebut memberikan kerangka berpikir yang sangat berguna ketika memulai proyek Machine Learning.
Step 1 - Get Data Ready
Tahap pertama adalah mempersiapkan data.
Data Machine Learning dapat berasal dari:
- CSV.
- Excel.
- Database.
- API.
- Sensor.
- Aplikasi.
- Dataset publik.
Contoh membaca dataset menggunakan Pandas:
import pandas as pd

df = pd.read_csv("data.csv")
Kemudian kita dapat melihat beberapa baris pertama:
df.head()
Kita juga dapat memeriksa informasi dataset:
df.info()
Dan statistik dasar:
df.describe()
Tujuan tahap ini adalah memahami data sebelum memasukkannya ke dalam model.
Mengapa Data Harus Dipahami Terlebih Dahulu?
Machine Learning bukan sekadar:
Load Dataset
     ↓
Train Model
Sebelum training, kita perlu memahami:
- Apa arti setiap kolom?
- Kolom mana yang merupakan fitur?
- Kolom mana yang merupakan target?
- Apakah terdapat missing value?
- Apakah terdapat data kategorikal?
- Apakah terdapat outlier?
- Apakah terdapat data yang tidak valid?
- Bagaimana distribusi target?
- Apakah terdapat data leakage?
Workflow yang lebih realistis:
Load Data
   ↓
Understand Data
   ↓
Clean Data
   ↓
Explore Data
   ↓
Prepare Data
   ↓
Build Model
Memisahkan Feature dan Target
Dalam supervised learning, dataset biasanya dibagi menjadi:
X = Features
y = Target
Feature
Feature adalah variabel yang digunakan model untuk membuat prediksi.
Misalnya kita ingin memprediksi harga rumah.
Feature dapat berupa:
Luas Rumah
Jumlah Kamar
Jumlah Kamar Mandi
Lokasi
Umur Bangunan
Target
Target adalah nilai yang ingin diprediksi.
Untuk kasus tersebut:
Harga Rumah
Secara sederhana:
Features (X)
     │
     ├── Luas
     ├── Kamar
     ├── Kamar Mandi
     ├── Lokasi
     └── Umur
     │
     ▼
   Model
     │
     ▼
Target (y)
     │
     └── Harga
Contoh Memisahkan X dan y
Misalnya DataFrame memiliki:
age
sex
chol
thalach
target
Jika:
target
merupakan target yang ingin diprediksi, kita dapat menulis:
X = df.drop("target", axis=1)
y = df["target"]
Sekarang:
X
├── age
├── sex
├── chol
└── thalach

y
└── target
Step 2 - Membagi Dataset
Setelah menentukan X dan y, kita biasanya membagi dataset menjadi beberapa bagian.
Pembagian sederhana:
Training Set
Testing Set
Scikit-Learn menyediakan:
train_test_split()
Import:
from sklearn.model_selection import train_test_split
Kemudian:
X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42
)
Memahami train_test_split()
Kode:
train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42
)
berarti kita meminta Scikit-Learn membagi data menjadi training dan testing.
Dengan:
test_size=0.2
sekitar 20% data digunakan sebagai test set dan sisanya sebagai training set.
Secara sederhana:
100% Dataset
│
├── 80% Training
│
└── 20% Testing
Angka tersebut hanya contoh. Proporsi yang tepat bergantung pada ukuran dan karakteristik dataset.
Mengapa Dataset Harus Dibagi?
Tujuan utamanya adalah menguji apakah model dapat bekerja pada data yang tidak digunakan untuk fitting.
Jika kita melatih dan mengevaluasi model menggunakan data yang sama:
Training Data
      ↓
    Model
      ↓
Training Data
      ↓
Evaluation
hasil evaluasi dapat memberikan gambaran yang terlalu optimistis tentang kemampuan model pada data baru.
Dengan train/test split:
Training Data
      ↓
    Model
      ↓
Testing Data
      ↓
Evaluation
kita mendapatkan evaluasi yang lebih relevan terhadap data yang tidak digunakan untuk fitting.
random_state
Pada contoh:
random_state=42
digunakan agar pembagian data dapat direproduksi.
Tanpa random_state, hasil pembagian dapat berubah ketika kode dijalankan kembali.
Contoh:
train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42
)
Jika kode dijalankan kembali dengan dataset dan lingkungan yang sama, pembagian acak dapat direproduksi.
Angka 42 bukan angka khusus.
Kita dapat menggunakan nilai integer lain.
Step 3 - Choose a Model
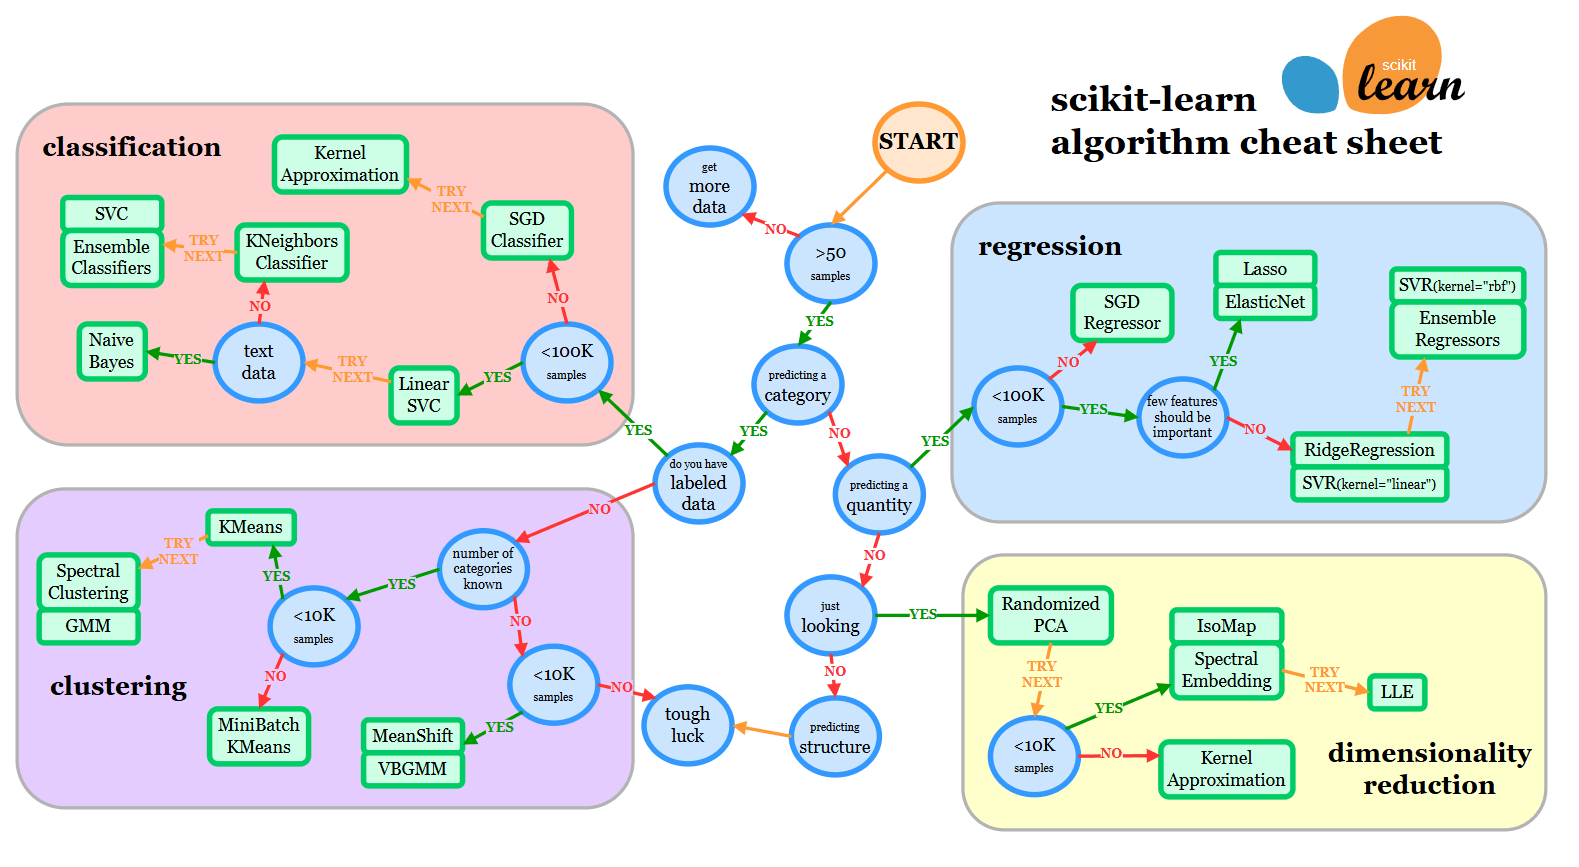
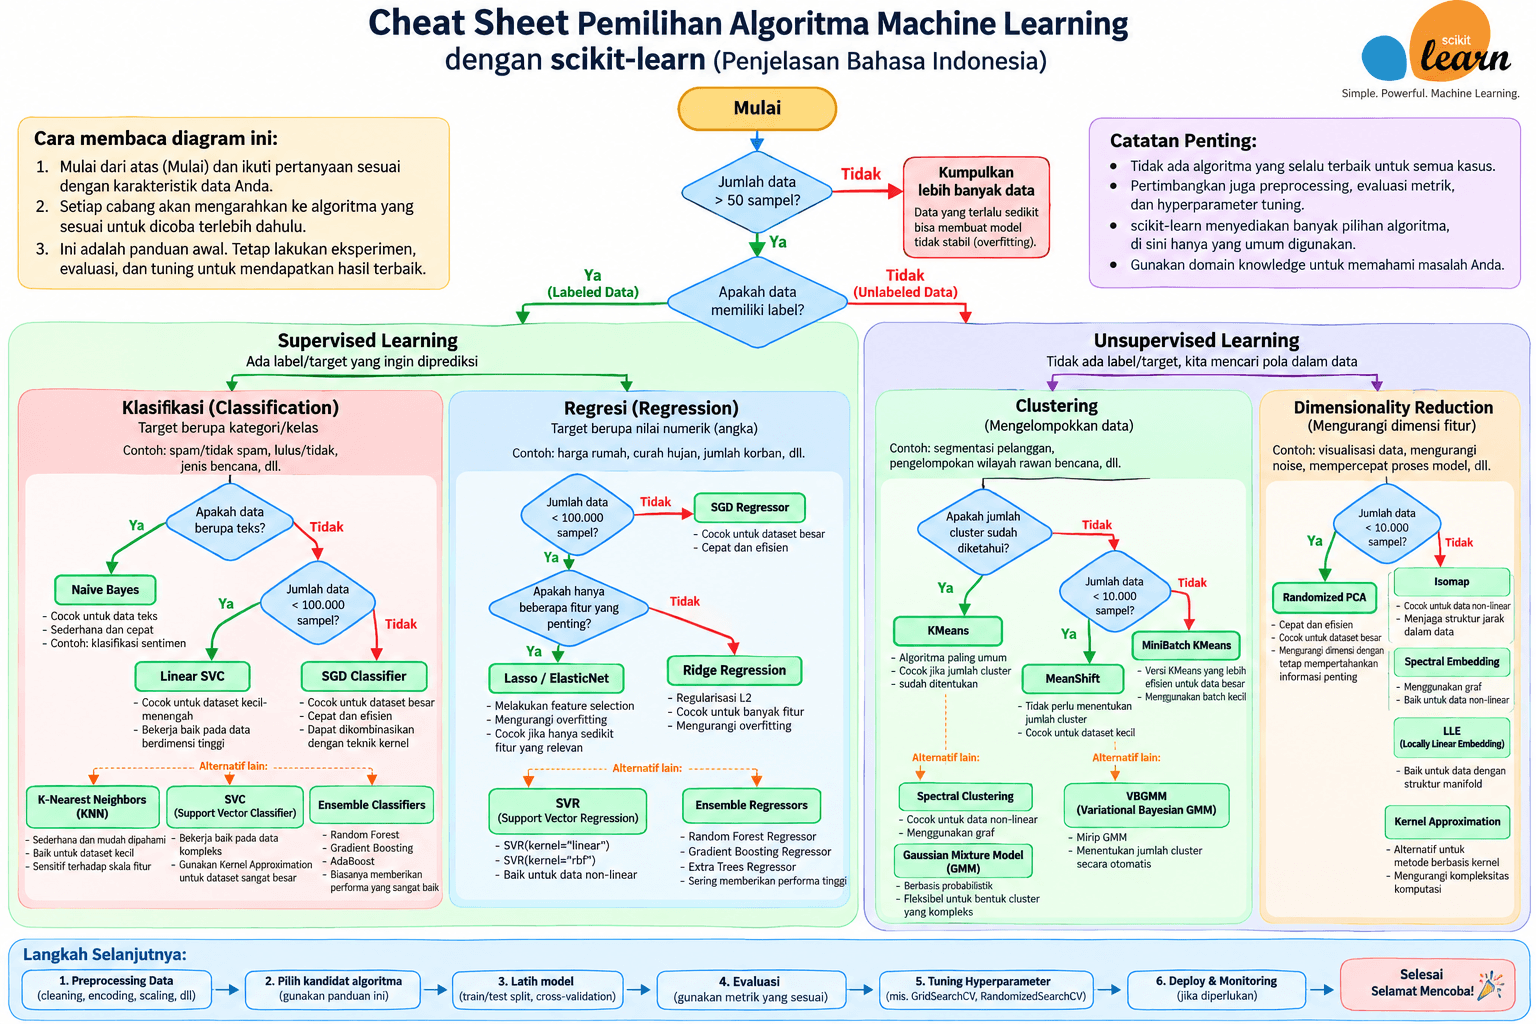
Sumber Gambar: Scikit-learn machine learning map.
Setelah data siap, kita perlu memilih model atau estimator.
Estimator adalah objek Scikit-Learn yang menyediakan mekanisme untuk belajar dari data.
Pemilihan estimator bergantung pada jenis permasalahan.
Secara umum:
Contoh:
Classification
Jika target berupa kategori:
Spam / Not Spam
0 / 1
Lulus / Tidak Lulus
kita dapat menggunakan:
RandomForestClassifier()
Regression
Jika target berupa angka:
Harga
Suhu
Penjualan
Pendapatan
kita dapat menggunakan:
RandomForestRegressor()
Classification vs Regression
Perbedaan sederhana:
| Jenis | Target | Contoh |
|---|---|---|
| Classification | Kategori | Spam / Not Spam |
| Classification | Kategori | Sakit / Tidak Sakit |
| Regression | Angka | Harga Rumah |
| Regression | Angka | Prediksi Penjualan |
Pemilihan algoritma harus dimulai dari memahami jenis permasalahan yang ingin diselesaikan.
Contoh Classification
Misalnya:
from sklearn.ensemble import RandomForestClassifier

model = RandomForestClassifier(
    random_state=42
)
Sekarang kita memiliki estimator:
RandomForestClassifier
yang dapat digunakan untuk permasalahan classification.
Contoh Regression
Untuk regression:
from sklearn.ensemble import RandomForestRegressor

model = RandomForestRegressor(
    random_state=42
)
Perhatikan bahwa nama estimator berbeda:
Memilih Model dengan Scikit-Learn
Scikit-Learn memiliki banyak estimator.
Contohnya:
Classification
├── Logistic Regression
├── KNN
├── SVM
├── Decision Tree
├── Random Forest
└── Gradient Boosting

Regression
├── Linear Regression
├── Ridge
├── Lasso
├── Decision Tree
├── Random Forest
└── Gradient Boosting
Tidak semua model harus dipelajari sekaligus.
Mulailah dengan beberapa model yang sesuai dengan jenis permasalahan, kemudian lakukan eksperimen dan evaluasi.
Step 4 - Fit the Model
Setelah memilih model, langkah berikutnya adalah melatihnya.
Gunakan:
model.fit(
    X_train,
    y_train
)
fit() merupakan salah satu method paling penting dalam API Scikit-Learn.
Secara sederhana:
X_train
   +
y_train
   ↓
model.fit()
   ↓
Trained Model
Model menggunakan training data untuk mempelajari parameter yang diperlukan algoritma.
Contoh Training
from sklearn.ensemble import RandomForestClassifier

model = RandomForestClassifier(
    random_state=42
)

model.fit(
    X_train,
    y_train
)
Setelah fit() selesai, model telah dilatih.
Step 5 - Make Predictions
Setelah model dilatih, kita dapat membuat prediksi.
Gunakan:
model.predict(X_test)
Contoh:
y_pred = model.predict(X_test)
Sekarang:
X_test
  ↓
Trained Model
  ↓
predict()
  ↓
y_pred
y_pred berisi hasil prediksi model.
predict() pada Classification
Misalnya target:
0
1
0
1
Model dapat menghasilkan:
y_pred = model.predict(X_test)
dengan hasil seperti:
[0, 1, 1, 1, 0]
Hasil aktual terdapat pada:
y_test
Keduanya kemudian dapat dibandingkan menggunakan evaluation metrics.
predict_proba()
Untuk beberapa model classification, kita juga dapat menggunakan:
model.predict_proba(X_test)
Method ini menghasilkan probabilitas untuk setiap kelas.
Contoh konseptual:
Data 1
Class 0 → 0.20
Class 1 → 0.80
Artinya model memberikan probabilitas relatif 20% untuk class 0 dan 80% untuk class 1.
Kemudian predict() biasanya memilih kelas berdasarkan aturan prediksi estimator tersebut.
Penting untuk memahami bahwa probabilitas yang dihasilkan estimator tidak selalu dapat diartikan sebagai probabilitas yang terkalibrasi dengan sempurna.
Kapan predict_proba() Berguna?
Probabilitas dapat berguna ketika kita membutuhkan lebih dari sekadar label.
Misalnya:
Prediksi:
Fraud
tidak memberikan informasi seberapa kuat model mendukung prediksi tersebut.
Sedangkan:
Fraud Probability = 0.92
memberikan informasi tambahan.
Hal ini dapat berguna dalam sistem yang memiliki threshold keputusan tertentu.
Namun, penggunaan threshold dan interpretasi probabilitas harus disesuaikan dengan masalah dan model yang digunakan.
Step 6 - Evaluate the Model
Setelah membuat prediksi, kita perlu mengevaluasi performa model.
Salah satu cara sederhana adalah menggunakan:
model.score(...)
Contoh classification:
model.score(
    X_test,
    y_test
)
Namun, arti score() bergantung pada estimator.
Karena itu, jangan menganggap score() selalu berarti accuracy untuk semua model.
Untuk memahami metric secara eksplisit, gunakan evaluation metrics yang sesuai.
Evaluation Metrics untuk Classification
Beberapa metric yang sering digunakan:
Accuracy
Precision
Recall
F1-score
ROC AUC
Confusion Matrix
Accuracy
Mengukur proporsi prediksi yang benar.
Contoh:
from sklearn.metrics import accuracy_score

accuracy = accuracy_score(
    y_test,
    y_pred
)
Precision
Precision berfokus pada proporsi prediksi positif yang benar-benar positif.
Secara konsep:
Dari semua yang diprediksi positif,
berapa banyak yang benar-benar positif?
Recall
Recall berfokus pada kemampuan model menemukan kasus positif yang sebenarnya ada.
Secara konsep:
Dari semua kasus positif yang sebenarnya,
berapa banyak yang berhasil ditemukan model?
F1-Score
F1-score menggabungkan precision dan recall dalam satu ukuran.
F1-score sering berguna ketika kita ingin mempertimbangkan kedua aspek tersebut secara bersamaan.
Confusion Matrix
Confusion matrix membantu melihat distribusi:
True Positive
True Negative
False Positive
False Negative
Contoh:
from sklearn.metrics import confusion_matrix

cm = confusion_matrix(
    y_test,
    y_pred
)
Evaluation Metrics untuk Regression
Untuk regression, beberapa metric yang umum digunakan:
R²
MAE
MSE
RMSE
R²
R² memberikan ukuran seberapa baik variasi target dapat dijelaskan oleh model dalam konteks tertentu.
MAE
Mean Absolute Error atau MAE menghitung rata-rata nilai absolut kesalahan prediksi.
Contoh:
from sklearn.metrics import mean_absolute_error

mae = mean_absolute_error(
    y_test,
    y_pred
)
MSE
Mean Squared Error menghitung rata-rata kuadrat error.
from sklearn.metrics import mean_squared_error

mse = mean_squared_error(
    y_test,
    y_pred
)
RMSE
Root Mean Squared Error merupakan akar dari MSE.
Dalam versi Scikit-Learn yang mendukung API tersebut, kita dapat menghitungnya dengan:
from sklearn.metrics import root_mean_squared_error

rmse = root_mean_squared_error(
    y_test,
    y_pred
)
Alternatif yang lebih umum secara matematis:
rmse = mean_squared_error(
    y_test,
    y_pred
) ** 0.5
Step 7 - Cross-Validation
Train/test split bukan satu-satunya cara mengevaluasi model.
Scikit-Learn juga menyediakan cross-validation.
Salah satu fungsi yang dapat digunakan:
from sklearn.model_selection import cross_val_score
Contoh:
scores = cross_val_score(
    model,
    X,
    y,
    cv=5
)
Dengan:
cv=5
data secara umum dibagi menjadi lima bagian atau fold.
Model kemudian dilatih dan dievaluasi beberapa kali dengan kombinasi fold yang berbeda.
Secara konsep:
Fold 1 → Test
Fold 2 → Test
Fold 3 → Test
Fold 4 → Test
Fold 5 → Test
Pada setiap iterasi, fold yang berbeda digunakan sebagai data validasi.
Mengapa Cross-Validation Berguna?
Jika kita hanya menggunakan satu pembagian train/test:
80% Train
20% Test
hasil evaluasi dapat dipengaruhi oleh pembagian data tersebut.
Cross-validation memberikan beberapa hasil evaluasi dari pembagian yang berbeda.
Contoh:
Fold 1 → 0.82
Fold 2 → 0.85
Fold 3 → 0.81
Fold 4 → 0.87
Fold 5 → 0.84
Kita dapat menghitung rata-rata:
scores.mean()
dan melihat variasinya:
scores.std()
Hal ini memberikan gambaran yang lebih lengkap mengenai performa model.
Cross-Validation Bukan Pengganti Test Set dalam Semua Situasi
Jika kita memiliki test set yang disimpan untuk evaluasi akhir, cross-validation biasanya dilakukan pada data development/training untuk pemilihan model atau hyperparameter.
Secara sederhana:
Full Dataset
│
├── Development Data
│      │
│      └── Cross-Validation
│
└── Test Data
       │
       └── Final Evaluation
Dengan pendekatan ini, test set tetap relatif terisolasi dari proses pemilihan model.
Step 8 - Improve Through Experimentation
Model pertama yang kita buat belum tentu menjadi model yang sesuai dengan kebutuhan.
Machine Learning biasanya membutuhkan eksperimen.
Kita dapat mencoba:
Model berbeda
     ↓
Feature berbeda
     ↓
Preprocessing berbeda
     ↓
Hyperparameter berbeda
     ↓
Evaluation
Kemudian membandingkan hasilnya berdasarkan metric yang sesuai.
Hyperparameter
Hyperparameter merupakan konfigurasi model yang ditentukan sebelum atau selama proses training dan bukan parameter internal yang dipelajari langsung dari training data.
Contoh Random Forest:
RandomForestClassifier(
    n_estimators=100,
    max_depth=10,
    random_state=42
)
Di sini:
n_estimators
max_depth
merupakan contoh hyperparameter.
Hyperparameter Tuning
Kita dapat menguji berbagai kombinasi hyperparameter.
Misalnya:
n_estimators
├── 50
├── 100
└── 200
dan:
max_depth
├── 5
├── 10
└── 20
Kemudian kita dapat mengevaluasi kombinasi tersebut.
Scikit-Learn menyediakan:
GridSearchCV
dan:
RandomizedSearchCV
untuk membantu proses pencarian hyperparameter.
Contoh Konsep Grid Search
Misalnya kita memiliki:
n_estimators = [50, 100, 200]

max_depth = [5, 10, 20]
Grid search akan mengevaluasi berbagai kombinasi:
50  + 5
50  + 10
50  + 20

100 + 5
100 + 10
100 + 20

200 + 5
200 + 10
200 + 20
Kemudian kita dapat memilih konfigurasi berdasarkan metric yang ditentukan pada proses validasi.
Step 9 - Save and Reload Model
Setelah mendapatkan model yang ingin digunakan, kita mungkin ingin menyimpannya.
Salah satu library yang umum digunakan adalah:
joblib
Contoh:
import joblib

joblib.dump(
    model,
    "trained-model.pkl"
)
Kemudian model dapat dimuat:
model = joblib.load(
    "trained-model.pkl"
)
Setelah dimuat kembali:
y_pred = model.predict(X_new)
Model dapat digunakan tanpa melakukan training ulang.
Mengapa Model Perlu Disimpan?
Bayangkan training membutuhkan waktu:
1 menit
10 menit
1 jam
10 jam
Kita tentu tidak ingin melakukan training ulang setiap kali aplikasi dijalankan.
Dengan menyimpan model:
Training
   ↓
Save
   ↓
model.pkl
   ↓
Load
   ↓
Prediction
model dapat digunakan kembali.
Perhatikan Preprocessing
Jika model membutuhkan preprocessing, jangan hanya menyimpan estimator tanpa memastikan preprocessing yang diperlukan juga tersedia.
Misalnya:
Raw Data
   ↓
Scaler
   ↓
Model
Ketika deployment:
New Data
   ↓
Scaler yang sama
   ↓
Model
   ↓
Prediction
Scaler harus menggunakan parameter yang dipelajari dari data training.
Karena itu, penggunaan Scikit-Learn Pipeline sering membantu menjaga preprocessing dan model tetap menjadi satu workflow.
Step 10 - Putting It All Together
Sekarang kita gabungkan seluruh proses.
Contoh sederhana:
import pandas as pd

from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score

# 1. Load data
df = pd.read_csv("data.csv")

# 2. Define features dan target
X = df.drop("target", axis=1)
y = df["target"]

# 3. Split data
X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42
)

# 4. Create model
model = RandomForestClassifier(
    random_state=42
)

# 5. Fit model
model.fit(
    X_train,
    y_train
)

# 6. Make predictions
y_pred = model.predict(X_test)

# 7. Evaluate
accuracy = accuracy_score(
    y_test,
    y_pred
)

print("Accuracy:", accuracy)
Workflow tersebut:
Load Data
   ↓
X dan y
   ↓
Train/Test Split
   ↓
Choose Model
   ↓
  Fit
   ↓
Predict
   ↓
Evaluate
Workflow yang Lebih Lengkap
Dalam proyek nyata, workflow dapat menjadi lebih kompleks:
Raw Data
   ↓
Data Cleaning
   ↓
Exploratory Data Analysis
   ↓
Feature Engineering
   ↓
Train / Validation / Test
   ↓
Preprocessing
   ↓
Choose Model
   ↓
Cross-Validation
   ↓
Hyperparameter Tuning
   ↓
Final Evaluation
   ↓
Save Pipeline
   ↓
Deployment
   ↓
Monitoring
Semakin besar proyek, semakin penting menjaga workflow tetap terstruktur.
Pendekatan Eksperimental
Machine Learning bukan proses:
Train sekali
↓
Selesai
Lebih tepat jika dipandang sebagai proses iteratif:
Experiment
    ↓
Train
    ↓
Evaluate
    ↓
Analyze
    ↓
Improve
    ↓
Experiment Again
Misalnya:
Model A
Accuracy = 0.78

        ↓

Model B
Accuracy = 0.83

        ↓

Model C
Accuracy = 0.85
Namun, jangan hanya mengejar angka metric yang lebih tinggi.
Kita juga perlu mempertimbangkan:
- jenis metric,
- generalisasi,
- interpretabilitas,
- latency,
- ukuran model,
- biaya komputasi,
- kebutuhan bisnis,
- dan risiko kesalahan prediksi.
Jangan Hanya Mengandalkan .score()
Scikit-Learn menyediakan:
model.score(...)
yang praktis untuk evaluasi awal.
Namun arti nilai tersebut bergantung pada estimator.
Karena itu, untuk analisis yang lebih jelas, gunakan metric yang secara eksplisit sesuai dengan masalah.
Misalnya classification:
from sklearn.metrics import accuracy_score

accuracy_score(
    y_test,
    y_pred
)
Untuk regression:
from sklearn.metrics import mean_absolute_error

mean_absolute_error(
    y_test,
    y_pred
)
Dengan demikian kita mengetahui metric apa yang sebenarnya sedang dihitung.
Membaca Dokumentasi
Ketika menggunakan Scikit-Learn, jangan ragu membuka dokumentasi.
Misalnya kita ingin mengetahui parameter:
RandomForestClassifier
Kita perlu memahami:
- parameter yang tersedia,
- default value,
- tipe parameter,
- atribut,
- method,
- dan catatan penggunaan.
Di Jupyter Notebook, kita juga dapat menggunakan:
Shift + Tab
untuk melihat informasi fungsi atau method.
Contoh:
train_test_split(
kemudian tekan:
Shift + Tab
Fitur ini dapat membantu ketika kita lupa signature sebuah fungsi.
Prinsip "If in Doubt, Run the Code"
Ketika tidak yakin dengan perilaku suatu fungsi, cobalah menjalankan kode.
Misalnya:
X_train.shape
atau:
X_test.shape
atau:
model.get_params()
atau:
y_pred[:10]
Kemudian perhatikan outputnya.
Workflow belajar:
Tidak yakin
    ↓
Eksperimen
    ↓
Run Code
    ↓
Lihat Output
    ↓
Analisis
    ↓
Baca Dokumentasi
    ↓
Coba Lagi
Kemampuan melakukan eksperimen kecil seperti ini merupakan bagian penting dari proses belajar Machine Learning.
Kesalahan yang Sering Terjadi
Langsung Training Tanpa Memahami Data
Hindari pola:
Download Dataset
↓
model.fit()
Biasakan memeriksa dataset terlebih dahulu.
Salah Menentukan Target
Pastikan:
X
berisi fitur dan:
y
berisi target yang ingin diprediksi.
Data Leakage
Hindari membiarkan informasi dari data evaluasi memengaruhi proses training atau pemilihan model secara tidak semestinya.
Contohnya adalah melakukan preprocessing seperti scaling pada seluruh dataset sebelum train/test split:
Seluruh Data
   ↓
fit scaler
   ↓
Split
Pendekatan yang lebih aman:
Split
  ↓
Training Data → fit scaler
  ↓
Test Data → transform menggunakan scaler yang sama
Dalam praktik, Pipeline dapat membantu menjaga proses ini.
Terlalu Sering Melihat Test Set
Test set sebaiknya dipertahankan sebagai evaluasi akhir.
Jika kita berkali-kali memilih model berdasarkan hasil test set, test set secara tidak langsung ikut memengaruhi proses pengembangan.
Gunakan validation atau cross-validation untuk pemilihan model dan tuning, lalu gunakan test set untuk evaluasi akhir.
Hanya Membandingkan Accuracy
Accuracy tidak selalu cocok untuk semua masalah.
Misalnya dataset sangat tidak seimbang:
Class 0 = 99%
Class 1 = 1%
Model yang selalu memprediksi class 0 dapat memperoleh accuracy tinggi tetapi gagal menemukan class 1.
Karena itu, gunakan metric yang sesuai dengan tujuan masalah.
Ringkasan Workflow
Workflow utama Scikit-Learn dapat diringkas menjadi:
1. Get Data Ready
       ↓
2. Define X and y
       ↓
3. Split Data
       ↓
4. Pick Model / Estimator
       ↓
5. Fit Model
       ↓
6. Make Predictions
       ↓
7. Evaluate
       ↓
8. Improve Through Experimentation
       ↓
9. Save Model
       ↓
10. Use / Deploy
Ringkasan Fungsi dan Method Penting
| Fungsi / Method | Kegunaan |
|---|---|
train_test_split() | Membagi dataset |
fit() | Melatih estimator |
predict() | Membuat prediksi |
predict_proba() | Menghasilkan probabilitas kelas pada estimator yang mendukung |
score() | Menghasilkan skor default estimator |
cross_val_score() | Evaluasi menggunakan cross-validation |
accuracy_score() | Evaluasi accuracy classification |
confusion_matrix() | Membuat confusion matrix |
classification_report() | Ringkasan beberapa metric classification |
mean_absolute_error() | Menghitung MAE |
mean_squared_error() | Menghitung MSE |
GridSearchCV | Pencarian hyperparameter secara sistematis |
RandomizedSearchCV | Pencarian hyperparameter secara acak |
joblib.dump() | Menyimpan objek/model |
joblib.load() | Memuat objek/model |
Konsep Utama yang Harus Dipahami
Jangan hanya menghafal:
model.fit()
model.predict()
Pahami hubungan antar proses:
X_train + y_train
        ↓
      fit()
        ↓
 Trained Model
        ↓
      X_test
        ↓
    predict()
        ↓
      y_pred
        ↓
Compare with y_test
        ↓
    Evaluation
Inilah salah satu pola dasar yang akan terus digunakan ketika bekerja dengan Scikit-Learn.
Kesimpulan
Scikit-Learn menyediakan workflow yang relatif konsisten untuk membangun model Machine Learning.
Proses utamanya dimulai dari:
Data
kemudian:
Prepare
↓
Split
↓
Choose Model
↓
Fit
↓
Predict
↓
Evaluate
↓
Improve
↓
Save
Hal yang paling penting bukan sekadar menghafal fungsi Scikit-Learn, tetapi memahami mengapa setiap langkah diperlukan dan bagaimana setiap langkah berhubungan dengan langkah berikutnya.
Machine Learning juga merupakan proses eksperimental. Kita dapat mencoba beberapa model, melakukan evaluasi, mengubah preprocessing atau hyperparameter, kemudian mengulangi proses tersebut sampai mendapatkan solusi yang sesuai dengan kebutuhan.