Memilih Model
Setelah memahami workflow dasar Scikit-Learn, langkah berikutnya adalah menentukan estimator atau algoritma yang sesuai dengan masalah machine learning yang sedang kita hadapi.
Memilih algoritma bukan berarti langsung mencari satu model yang pasti paling baik. Dalam praktiknya, kita biasanya memilih beberapa kandidat model, melatihnya, kemudian membandingkan performanya menggunakan metode evaluasi yang sesuai.
Scikit-Learn menyediakan banyak estimator untuk berbagai jenis masalah, seperti classification, regression, clustering, dan lainnya.
Istilah Dasar dalam Scikit-Learn
Sebelum memilih algoritma, kita perlu memahami beberapa istilah yang sering digunakan dalam Scikit-Learn.
Estimator
Estimator adalah istilah umum yang digunakan Scikit-Learn untuk objek yang digunakan dalam proses machine learning.
Estimator dapat berupa model atau algoritma yang memiliki pola penggunaan seperti:
model.fit(X_train, y_train)
Kemudian digunakan untuk melakukan prediksi:
predictions = model.predict(X_test)
Contoh estimator:
from sklearn.linear_model import Ridge
from sklearn.ensemble import RandomForestRegressor

model_1 = Ridge()
model_2 = RandomForestRegressor()
Keduanya merupakan estimator, tetapi digunakan untuk pendekatan regresi yang berbeda.
Classifier
Classifier adalah estimator yang digunakan untuk masalah classification.
Classification digunakan ketika target yang ingin diprediksi berupa kategori atau kelas.
Contohnya:
- Pasien sakit atau tidak sakit
- Email spam atau bukan spam
- Transaksi fraud atau bukan fraud
- Hewan termasuk kucing atau anjing
Contoh estimator classification:
from sklearn.ensemble import RandomForestClassifier

clf = RandomForestClassifier()
Variabel clf sering digunakan sebagai singkatan dari classifier, meskipun sebenarnya kita bebas menggunakan nama variabel lain.
Contoh:
clf.fit(X_train, y_train)

predictions = clf.predict(X_test)
Regressor
Regressor adalah estimator yang digunakan untuk masalah regression.
Regression digunakan ketika target yang ingin diprediksi berupa nilai numerik kontinu.
Contohnya:
- Harga rumah
- Harga kendaraan
- Suhu
- Pendapatan
- Konsumsi listrik
Contoh estimator:
from sklearn.linear_model import Ridge

model = Ridge()
Estimator tersebut dapat digunakan untuk memprediksi nilai numerik:
model.fit(X_train, y_train)

predictions = model.predict(X_test)
Classification vs Regression
Salah satu langkah pertama dalam memilih estimator adalah menentukan jenis masalah yang sedang kita hadapi.
| Masalah | Target | Contoh |
|---|---|---|
| Classification | Kategori | Sakit / Tidak Sakit |
| Classification | Kategori | Spam / Bukan Spam |
| Regression | Angka kontinu | Harga rumah |
| Regression | Angka kontinu | Prediksi suhu |
| Regression | Angka kontinu | Prediksi pendapatan |
Cara sederhananya:
Apa yang ingin diprediksi?
            │
            ▼
Apakah hasilnya kategori?
            │
   ┌────────┴───────┐
   │                │
  Ya              Tidak
   │                │
   ▼                ▼
Classification   Regression
Contoh Classification
Misalnya kita ingin memprediksi apakah seseorang memiliki penyakit tertentu.
Target:
0 = Tidak
1 = Ya
Karena target menunjukkan kategori, masalah tersebut merupakan classification.
Contoh Regression
Misalnya kita ingin memprediksi harga rumah.
Target:
185000
245000
310000
425000
Karena target berupa nilai numerik kontinu, masalah tersebut merupakan regression.
Scikit-Learn ML Map
Scikit-Learn menyediakan panduan untuk membantu pengguna menentukan estimator berdasarkan jenis masalah dan karakteristik dataset.
Secara umum, proses pemilihannya dapat dimulai dari beberapa pertanyaan:
- Berapa banyak data yang tersedia?
- Apa yang ingin diprediksi?
- Apakah target berupa kategori atau angka?
- Berapa banyak fitur yang tersedia?
- Apakah kita membutuhkan model yang sederhana atau model yang lebih kompleks?
Salah satu konsep penting adalah jangan langsung mengasumsikan satu algoritma pasti paling baik.
Gunakan algoritma sebagai titik awal eksperimen.
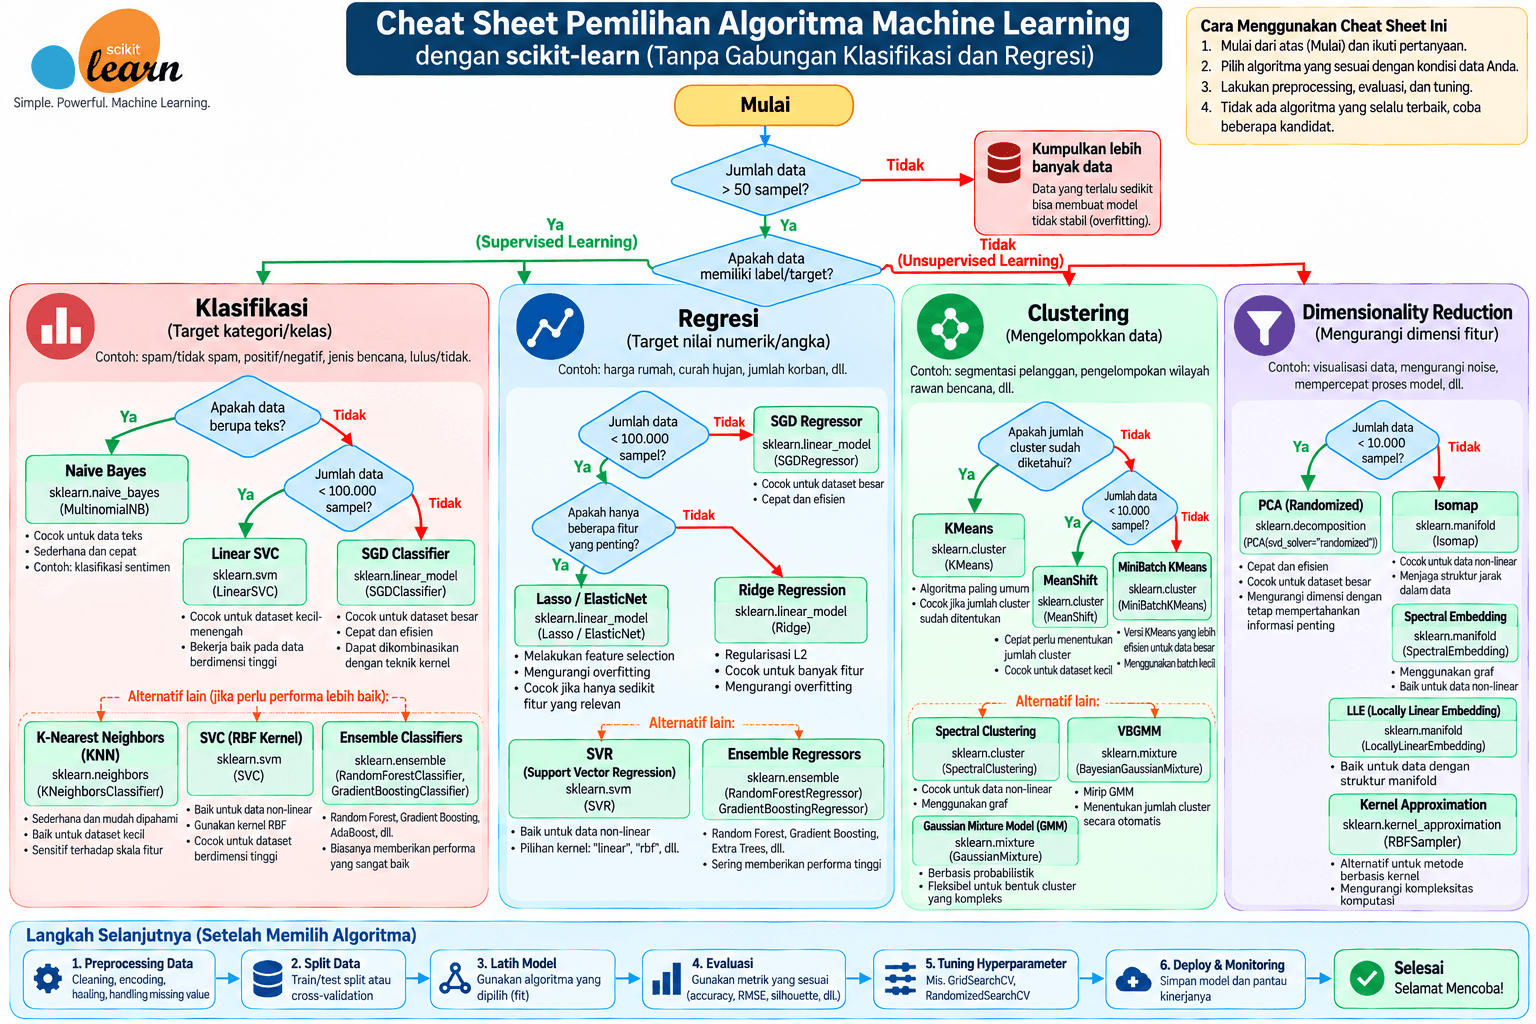
Baca juga: https://scikit-learn.org/stable/machine_learning_map.html
Langkah 1 - Periksa Jumlah Sampel
Sebelum memilih model, perhatikan jumlah sampel yang tersedia.
Misalnya dataset memiliki:
50 baris
500 baris
10.000 baris
100.000 baris
1.000.000 baris
Jumlah data dapat memengaruhi pilihan algoritma, waktu training, dan strategi evaluasi.
Dalam beberapa panduan sederhana, dataset dengan jumlah sampel yang sangat sedikit sebaiknya dipertimbangkan untuk mendapatkan lebih banyak data terlebih dahulu.
Namun, angka seperti 50 sampel bukan aturan universal.
Kebutuhan jumlah data bergantung pada:
- kompleksitas masalah
- jumlah fitur
- kualitas data
- noise
- kompleksitas model
- target yang ingin diprediksi
- metode evaluasi
Jadi, gunakan jumlah sampel sebagai salah satu pertimbangan, bukan sebagai aturan mutlak.
Langkah 2 - Tentukan Jenis Masalah
Pertanyaan berikutnya:
Apa yang ingin diprediksi?
Jika jawabannya berupa kategori, gunakan pendekatan classification.
Jika jawabannya berupa nilai numerik kontinu, gunakan pendekatan regression.
Contoh:
Prediksi penyakit
        ↓
Classification
Sedangkan:
Prediksi harga rumah
    ↓
Regression
Langkah 3 - Pilih Beberapa Kandidat Model
Setelah menentukan jenis masalah, pilih beberapa estimator yang sesuai untuk dijadikan kandidat.
Untuk regression, misalnya:
from sklearn.linear_model import Ridge
from sklearn.ensemble import RandomForestRegressor
Untuk classification:
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import RandomForestClassifier
Kita kemudian dapat melatih dan membandingkan model-model tersebut.
Jangan Mencari Algoritma "Terbaik" Sejak Awal
Dalam machine learning, kita biasanya tidak mengetahui sejak awal model mana yang akan memberikan hasil terbaik pada dataset tertentu.
Sebagai contoh, kita memiliki dataset regression.
Kita dapat mencoba:
Ridge
Random Forest
Support Vector Regression
Gradient Boosting
Kemudian membandingkan performanya.
Contoh workflow:
Dataset
   │
   ▼
Tentukan X dan y
   │
   ▼
Train/Test Split
   │
   ├── Ridge
   │
   ├── Random Forest
   │
   ├── SVR
   │
   └── Gradient Boosting
          │
          ▼
      Evaluasi
          │
          ▼
    Bandingkan hasil
Model yang dipilih pada akhirnya harus mempertimbangkan kebutuhan proyek, bukan hanya satu angka evaluasi.
Contoh Praktis: California Housing Dataset
Untuk memahami proses pemilihan estimator, kita akan menggunakan dataset California Housing yang tersedia di Scikit-Learn.
Dataset ini merupakan contoh masalah regression karena target yang diprediksi berupa nilai numerik.
Kita akan menggunakan:
fetch_california_housing()
Import Library
Pertama, import library yang diperlukan.
from sklearn.datasets import fetch_california_housing
from sklearn.model_selection import train_test_split
from sklearn.linear_model import Ridge

import pandas as pd
import numpy as np
Mengambil Dataset
Gunakan fetch_california_housing() untuk mengambil dataset.
housing = fetch_california_housing()
Kita dapat melihat struktur dataset:
housing
Dataset tersebut memiliki data fitur dan target.
Membuat DataFrame
Agar lebih mudah digunakan, data dapat dimasukkan ke dalam Pandas DataFrame.
housing_df = pd.DataFrame(
    housing["data"],
    columns=housing["feature_names"]
)
Kemudian tambahkan target:
housing_df["target"] = housing["target"]
Lihat beberapa data pertama:
housing_df.head()
Kita juga dapat melihat ukuran dataset:
housing_df.shape
Melihat nama kolom:
housing_df.columns
Memisahkan Features dan Target
Dalam machine learning, kita biasanya memisahkan dataset menjadi:
X= featuresy= target
Pada dataset ini, kolom target merupakan nilai yang ingin diprediksi.
X = housing_df.drop("target", axis=1)
y = housing_df["target"]
Periksa bentuk data:
print("X shape:", X.shape)
print("y shape:", y.shape)
Secara konsep:
X
│
├── MedInc
├── HouseAge
├── AveRooms
├── AveBedrms
├── Population
├── AveOccup
├── Latitude
└── Longitude

y
│
└── target
X berisi informasi yang digunakan model untuk membuat prediksi, sedangkan y merupakan nilai yang ingin diprediksi.
Membagi Data Train dan Test
Selanjutnya, kita membagi dataset menjadi data training dan testing.
X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42
)
Parameter:
test_size=0.2berarti sekitar 20% data digunakan sebagai test set.random_state=42membuat pembagian data dapat direproduksi.
Kita dapat memeriksa ukurannya:
print("X_train:", X_train.shape)
print("X_test:", X_test.shape)
print("y_train:", y_train.shape)
print("y_test:", y_test.shape)
Membuat Model Ridge
Sekarang kita memilih estimator Ridge Regression.
model = Ridge()
Ridge merupakan salah satu algoritma regression berbasis linear regression dengan regularisasi L2.
Melatih Model
Gunakan method fit() untuk melatih model.
model.fit(X_train, y_train)
Secara sederhana:
X_train + y_train
       │
       ▼
    Ridge
       │
       ▼
Model yang sudah dilatih
Membuat Prediksi
Setelah model dilatih, kita dapat membuat prediksi terhadap test set.
y_preds = model.predict(X_test)
Lihat beberapa hasil prediksi:
print(y_preds[:10])
Bandingkan dengan nilai sebenarnya:
print(y_test[:10].to_numpy())
Perlu diperhatikan bahwa prediksi model tidak harus sama persis dengan nilai sebenarnya.
Model machine learning biasanya menghasilkan prediksi berdasarkan pola yang dipelajari dari data training.
Mengevaluasi Model
Kita dapat menggunakan:
model.score(X_test, y_test)
Untuk estimator Ridge, method score() menggunakan R² (coefficient of determination).
Contoh:
score = model.score(X_test, y_test)

print(f"R-squared Score: {score:.3f}")
Nilai tersebut dapat digunakan sebagai salah satu ukuran performa model regression.
Memahami R²
R² atau coefficient of determination digunakan untuk mengukur seberapa baik model menjelaskan variasi pada target dibandingkan baseline tertentu.
Secara matematis:
Keterangan:
- = nilai sebenarnya
- = nilai prediksi model
- = rata-rata nilai target
Secara sederhana:
R² tinggi
   ↓
Prediksi relatif mampu menjelaskan
variasi target pada data evaluasi
Sedangkan:
R² rendah
   ↓
Kemampuan model dalam menjelaskan
variasi target masih terbatas
Apakah R² Selalu Berada di Antara 0 dan 1?
Tidak selalu.
Sering kali R² memiliki nilai antara 0 dan 1 pada model yang performanya lebih baik daripada baseline mean, tetapi secara matematis R² dapat bernilai negatif.
Contohnya:
R² = 0.80
dapat menunjukkan model menjelaskan sebagian besar variasi target pada data evaluasi.
Sedangkan:
R² = -0.20
berarti model pada data tersebut memiliki performa yang lebih buruk daripada baseline yang selalu memprediksi rata-rata target.
Karena itu, jangan menggunakan aturan:
"Semakin dekat ke 1 pasti selalu lebih baik dalam semua kondisi."
Nilai R² harus dilihat berdasarkan dataset, baseline, metode evaluasi, dan tujuan machine learning.
score() pada Scikit-Learn
Salah satu hal penting yang perlu diperhatikan adalah method:
model.score(X_test, y_test)
tidak selalu berarti accuracy.
Arti score() bergantung pada estimator yang digunakan.
Untuk beberapa contoh:
| Estimator | Jenis masalah | score() |
|---|---|---|
Ridge | Regression | R² |
LinearRegression | Regression | R² |
RandomForestRegressor | Regression | R² |
LogisticRegression | Classification | Accuracy |
RandomForestClassifier | Classification | Accuracy |
Karena itu, ketika membaca kode machine learning, selalu periksa dokumentasi estimator yang digunakan untuk mengetahui arti score().
Mencoba Estimator Lain
Salah satu cara belajar memilih estimator adalah menggunakan dataset yang sama untuk mencoba beberapa algoritma.
Misalnya kita mencoba:
from sklearn.ensemble import RandomForestRegressor

model_rf = RandomForestRegressor(
    n_estimators=100,
    random_state=42
)

model_rf.fit(X_train, y_train)

rf_score = model_rf.score(X_test, y_test)

print(f"Random Forest R²: {rf_score:.3f}")
Kemudian kita dapat membandingkannya dengan Ridge:
ridge_score = model.score(X_test, y_test)

print(f"Ridge R²: {ridge_score:.3f}")
print(f"Random Forest R²: {rf_score:.3f}")
Mencoba Support Vector Regression
Kita juga dapat mencoba Support Vector Regression (SVR).
from sklearn.svm import SVR

model_svr = SVR()

model_svr.fit(X_train, y_train)

svr_score = model_svr.score(X_test, y_test)

print(f"SVR R²: {svr_score:.3f}")
Namun, SVR memiliki sensitivitas terhadap skala fitur pada banyak kondisi. Karena itu, pada praktik machine learning yang lebih baik, kita biasanya mempertimbangkan preprocessing seperti feature scaling dan menggunakan Pipeline.
Contoh sederhana:
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVR

model_svr = make_pipeline(
    StandardScaler(),
    SVR()
)

model_svr.fit(X_train, y_train)

svr_score = model_svr.score(X_test, y_test)

print(f"SVR R²: {svr_score:.3f}")
Pendekatan menggunakan Pipeline membantu memastikan proses preprocessing diterapkan secara konsisten.
Membandingkan Beberapa Model
Kita dapat membuat dictionary untuk menyimpan beberapa model.
from sklearn.linear_model import Ridge
from sklearn.ensemble import RandomForestRegressor
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVR

models = {
    "Ridge": Ridge(),
    "Random Forest": RandomForestRegressor(
        n_estimators=100,
        random_state=42
    ),
    "SVR": make_pipeline(
        StandardScaler(),
        SVR()
    )
}
Kemudian melatih dan mengevaluasi setiap model:
for name, model in models.items():
    model.fit(X_train, y_train)
    score = model.score(X_test, y_test)

    print(f"{name}: {score:.3f}")
Contoh output dapat terlihat seperti:
Ridge: 0.xxx
Random Forest: 0.xxx
SVR: 0.xxx
Angka aktual dapat berbeda tergantung konfigurasi model dan pembagian data.
Mengapa Kita Mencoba Beberapa Algoritma?
Tidak ada satu algoritma yang selalu unggul untuk semua dataset.
Performa model dipengaruhi oleh:
- ukuran dataset
- jumlah fitur
- distribusi data
- hubungan antar fitur
- noise
- outlier
- preprocessing
- hyperparameter
- karakteristik target
- kualitas data
Sebagai contoh:
Dataset A
    ↓
Ridge mungkin memberikan hasil yang baik

Dataset B
    ↓
Random Forest mungkin lebih sesuai

Dataset C
    ↓
SVR mungkin menjadi kandidat yang menarik
Karena itu, machine learning merupakan proses eksperimentasi dan evaluasi, bukan sekadar memilih satu algoritma berdasarkan nama.
Jangan Hanya Membandingkan Satu Nilai
Misalnya kita mendapatkan hasil:
| Model | R² |
|---|---|
| Ridge | 0.60 |
| Random Forest | 0.75 |
| SVR | 0.68 |
Angka R² dapat membantu membandingkan performa, tetapi bukan satu-satunya pertimbangan.
Kita juga dapat mempertimbangkan:
- waktu training
- waktu inference
- penggunaan memory
- ukuran model
- interpretabilitas
- kompleksitas implementasi
- kebutuhan deployment
- kemampuan model menangani data baru
Dengan demikian, pemilihan model merupakan keputusan teknis yang mempertimbangkan kebutuhan aplikasi secara keseluruhan.
Workflow Memilih Estimator
Workflow sederhana yang dapat digunakan:
1. Pahami masalah
       ↓
2. Tentukan target
       ↓
3. Classification atau Regression?
       ↓
4. Periksa ukuran dan karakteristik data
       ↓
5. Pilih beberapa kandidat estimator
       ↓
6. Siapkan preprocessing
       ↓
7. Split data
       ↓
8. Train model
       ↓
9. Evaluasi
       ↓
10. Bandingkan model
       ↓
11. Tuning hyperparameter
       ↓
12. Evaluasi final
Perhatikan bahwa proses ini bersifat iteratif.
Jika performa belum sesuai kebutuhan, kita dapat kembali ke tahap preprocessing, feature engineering, pemilihan estimator, atau hyperparameter tuning.
Ringkasan
Pada materi ini kita telah mempelajari cara memilih estimator atau algoritma untuk masalah machine learning.
Hal-hal penting yang perlu diingat:
- Estimator adalah istilah umum untuk objek machine learning dalam Scikit-Learn.
- Classifier digunakan untuk classification.
- Regressor digunakan untuk regression.
- Tentukan terlebih dahulu apakah target berupa kategori atau nilai numerik kontinu.
- Jumlah sampel merupakan salah satu faktor dalam pemilihan algoritma, tetapi tidak boleh dianggap sebagai aturan mutlak.
- Tidak ada satu algoritma yang selalu terbaik untuk semua dataset.
- Gunakan beberapa kandidat model dan lakukan eksperimen.
fit()digunakan untuk melatih model.predict()digunakan untuk menghasilkan prediksi.score()memiliki arti yang bergantung pada estimator.- Untuk
Ridge,score()menghasilkan nilai R². - R² dapat digunakan untuk mengevaluasi regression.
- R² dapat bernilai negatif ketika performa model lebih buruk daripada baseline tertentu.
- Perbandingan model sebaiknya tidak hanya mempertimbangkan satu metrik.
- Preprocessing seperti scaling dapat menjadi bagian penting dalam pipeline model tertentu.
Tantangan Eksperimen
Gunakan kembali dataset California Housing dan lakukan eksperimen berikut.
Tantangan 1 - Bandingkan Model
Bandingkan minimal tiga model:
Ridge
RandomForestRegressor
SVR
Catat nilai R² masing-masing model.
Tantangan 2 - Gunakan Pipeline
Buat pipeline yang menggunakan:
StandardScaler
    ↓
SVR
Kemudian bandingkan hasilnya dengan SVR tanpa scaling.
Tantangan 3 - Ubah Hyperparameter
Coba ubah jumlah tree pada Random Forest:
RandomForestRegressor(
    n_estimators=50,
    random_state=42
)
Kemudian coba:
RandomForestRegressor(
    n_estimators=200,
    random_state=42
)
Bandingkan hasilnya.
Tantangan 4 - Buat Tabel Perbandingan
Buat DataFrame yang berisi:
Model
R²
Training Time
Kemudian gunakan hasil tersebut untuk memahami trade-off antar model.