Persiapan Tools
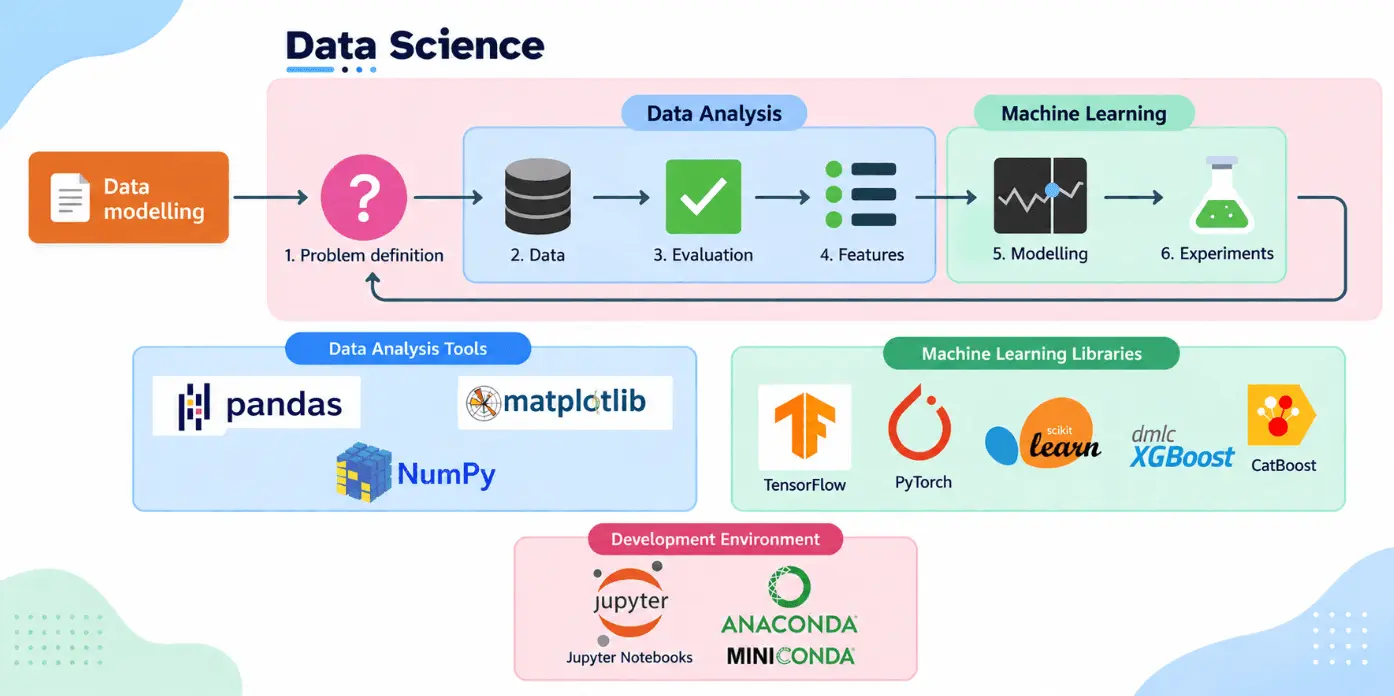
Sebelum memulai Exploratory Data Analysis (EDA) dan membangun model Machine Learning, kita perlu mempersiapkan tools dan library yang akan digunakan dalam project Heart Disease Classification.
Pada tahap ini, kita akan mengimpor library untuk analisis data, visualisasi, pemodelan, serta evaluasi model ke dalam Jupyter Notebook.
Dengan menyiapkan library di awal, kita dapat menjalankan eksperimen dengan lebih terstruktur dan mengurangi kebutuhan untuk mengimpor library berulang kali.
Library untuk Analisis Data dan Visualisasi
Library berikut digunakan untuk membaca, memanipulasi, dan memahami dataset.
| Library | Kegunaan |
|---|---|
| NumPy | Operasi numerik dan array |
| Pandas | Membaca, memanipulasi, dan menganalisis data dalam bentuk DataFrame |
| Matplotlib | Membuat grafik dan visualisasi data |
| Seaborn | Membuat visualisasi statistik dengan tampilan yang informatif |
Mengimpor Library
Buat sel kode pada Jupyter Notebook, kemudian jalankan kode berikut:
import numpy as np
import pandas as pd

import matplotlib.pyplot as plt
import seaborn as sns

%matplotlib inline
Keterangan:
import numpy as npmengimpor NumPy dengan aliasnp.import pandas as pdmengimpor Pandas dengan aliaspd.import matplotlib.pyplot as pltmengimpor fungsi plotting dari Matplotlib.import seaborn as snsmengimpor Seaborn untuk visualisasi statistik.%matplotlib inlinemerupakan IPython magic command yang menampilkan grafik langsung di dalam notebook pada lingkungan yang mendukungnya.
Perintah %matplotlib inline wajib ditulis pada versi Jupyter yang lama (terutama saat pertama kali dirilis) agar browser tahu bahwa grafik harus digambar di dalam sel halaman web, bukan dilempar ke jendela pop-up terpisah.
Library untuk Model Machine Learning
Project Heart Disease Classification merupakan masalah Supervised Learning dengan pendekatan Binary Classification. Oleh karena itu, kita akan mempersiapkan beberapa algoritma klasifikasi untuk dibandingkan.
| Algoritma | Kegunaan |
|---|---|
| Logistic Regression | Model klasifikasi yang menggunakan hubungan antara fitur dan probabilitas kelas |
| K-Nearest Neighbors (KNN) | Mengklasifikasikan data berdasarkan tetangga terdekat |
| Random Forest Classifier | Menggabungkan sejumlah Decision Tree untuk menghasilkan prediksi |
Mengimpor Model
Tambahkan kode berikut ke dalam sel kode Jupyter Notebook:
from sklearn.linear_model import LogisticRegression
from sklearn.neighbors import KNeighborsClassifier
from sklearn.ensemble import RandomForestClassifier
Ketiga algoritma tersebut dapat digunakan sebagai model awal untuk eksperimen klasifikasi.
Pada tahap pemodelan nanti, kita akan melatih dan mengevaluasi model untuk mengetahui bagaimana performanya terhadap dataset.
Library untuk Pembagian Data dan Evaluasi Model
Selain model Machine Learning, kita membutuhkan fungsi untuk membagi dataset dan mengevaluasi hasil prediksi.
1. Train-Test Split
train_test_split digunakan untuk membagi dataset menjadi training set dan test set.
from sklearn.model_selection import train_test_split
Training set digunakan untuk melatih model, sedangkan test set digunakan untuk mengevaluasi performa model pada data yang tidak digunakan selama training.
2. Cross-Validation
cross_val_score digunakan untuk mengevaluasi model melalui beberapa pembagian data (cross-validation folds).
from sklearn.model_selection import cross_val_score
Cross-validation membantu memberikan gambaran performa model yang lebih stabil dibandingkan hanya mengandalkan satu pembagian training dan test. Penggunaannya akan dibahas lebih lanjut pada tahap evaluasi model.
3. Classification Metrics
Kita juga memerlukan metrik untuk mengukur kualitas prediksi model.
from sklearn.metrics import (
    accuracy_score,
    precision_score,
    recall_score,
    f1_score,
    confusion_matrix,
    classification_report
)
Berikut fungsi dari beberapa metrik tersebut:
| Metrik | Kegunaan |
|---|---|
| Accuracy | Mengukur proporsi prediksi yang benar |
| Precision | Mengukur proporsi prediksi positif yang benar |
| Recall | Mengukur proporsi kasus positif aktual yang berhasil ditemukan |
| F1-score | Menggabungkan Precision dan Recall melalui rata-rata harmonik |
| Confusion Matrix | Menampilkan jumlah prediksi benar dan salah untuk setiap kelas |
| Classification Report | Menampilkan ringkasan Precision, Recall, F1-score, dan Support |
Untuk kasus penyakit jantung, jangan hanya mengandalkan Accuracy. Recall pada kelas positif juga penting karena menunjukkan seberapa banyak pasien yang benar-benar memiliki kondisi tersebut berhasil diidentifikasi oleh model.
4. ROC Curve dan AUC
ROC Curve digunakan untuk melihat hubungan antara True Positive Rate dan False Positive Rate pada berbagai threshold prediksi. AUC merangkum kemampuan model dalam membedakan kedua kelas berdasarkan kurva tersebut.
Pada Scikit-Learn modern, kita dapat menggunakan RocCurveDisplay untuk membuat visualisasi ROC Curve.
from sklearn.metrics import RocCurveDisplay, roc_auc_score
ROC Curve dan AUC akan lebih relevan ketika model menghasilkan skor prediksi atau probabilitas yang dapat digunakan untuk mengevaluasi berbagai threshold. Keduanya tidak wajib digunakan dalam setiap project klasifikasi.
Menggabungkan Semua Import
Agar seluruh library yang dibutuhkan tersedia sejak awal, kita dapat menggabungkan import di atas ke dalam satu sel kode.
# Data analysis
import numpy as np
import pandas as pd

# Data visualization
import matplotlib.pyplot as plt
import seaborn as sns

# Machine learning models
from sklearn.linear_model import LogisticRegression
from sklearn.neighbors import KNeighborsClassifier
from sklearn.ensemble import RandomForestClassifier

# Data splitting and cross-validation
from sklearn.model_selection import train_test_split, cross_val_score

# Evaluation metrics
from sklearn.metrics import (
    accuracy_score,
    precision_score,
    recall_score,
    f1_score,
    confusion_matrix,
    classification_report,
    RocCurveDisplay,
    roc_auc_score
)

# Display plots inside Jupyter Notebook
%matplotlib inline
Setelah menjalankan sel tersebut, seluruh library yang digunakan pada materi ini telah diimpor.
Jika muncul ModuleNotFoundError, kemungkinan library terkait belum terpasang pada environment Python yang sedang digunakan.
Untuk memasang library utama menggunakan Conda, jalankan perintah berikut di terminal dengan environment project sudah aktif:
conda install numpy pandas matplotlib seaborn scikit-learn jupyter
Jika library sudah terpasang, tidak perlu menjalankan instalasi ulang.
Catatan Penting
Mengapa Library Diimpor di Awal?
Mengimpor library yang dibutuhkan di awal notebook memberikan beberapa keuntungan:
- Memudahkan pembaca mengetahui tools yang digunakan dalam project.
- Membantu menjaga struktur notebook tetap rapi.
- Mengurangi pengulangan import di berbagai bagian notebook.
- Mempermudah identifikasi masalah jika library belum tersedia.
Namun, tidak semua library harus diimpor sekaligus. Untuk project yang lebih besar, import dapat dikelompokkan berdasarkan kebutuhan setiap tahap.
Menghadapi Warning dan Error
Dalam proses coding, terkadang muncul warning atau error akibat perbedaan versi library, kesalahan sintaks, atau ketidaksesuaian penggunaan fungsi.
Beberapa langkah yang dapat dilakukan:
- Baca pesan error untuk mengetahui penyebab masalah.
- Periksa apakah library sudah terpasang pada environment yang benar.
- Periksa dokumentasi fungsi yang digunakan.
- Sesuaikan kode dengan versi library yang terpasang.
Sebagai contoh, plot_roc_curve merupakan fungsi lama yang telah dihapus dari Scikit-Learn versi modern. Gunakan RocCurveDisplay untuk membuat ROC Curve.
Ringkasan
Pada materi ini, kita telah menyiapkan library untuk project Heart Disease Classification, meliputi:
- Data Analysis: NumPy dan Pandas.
- Data Visualization: Matplotlib dan Seaborn.
- Machine Learning Models: Logistic Regression, KNN, dan Random Forest Classifier.
- Data Splitting:
train_test_split. - Cross-Validation:
cross_val_score. - Model Evaluation: Accuracy, Precision, Recall, F1-score, Confusion Matrix, Classification Report, serta ROC Curve dan AUC.
Import library ini menjadi fondasi untuk tahap berikutnya, yaitu membaca dan mengeksplorasi dataset Heart Disease.