Eksplorasi: Scatter Plot & Distribusi Data
Setelah mempelajari dasar Exploratory Data Analysis (EDA), kita akan mengeksplorasi hubungan antarfitur untuk menemukan pola yang mungkin berguna dalam project Heart Disease Classification.
Pada materi ini, kita akan membahas tiga hal:
- Membandingkan usia (
age), detak jantung maksimal (thalach), dan target (target) menggunakan Scatter Plot. - Memeriksa distribusi usia menggunakan Histogram dan mengenali kemungkinan outliers.
- Membandingkan jenis nyeri dada (
cp) dengan target menggunakan tabel silang dan diagram batang.
Tujuan utamanya adalah membangun intuisi terhadap data sebelum melanjutkan ke analisis statistik dan pemodelan Machine Learning.
1. Scatter Plot: Usia vs Detak Jantung Maksimal
Scatter Plot atau grafik pencar digunakan untuk melihat hubungan antara dua variabel numerik. Setiap titik pada grafik mewakili satu sampel data.
Pada project ini, kita menggunakan tiga kolom:
| Kolom | Arti |
|---|---|
age | Usia pasien |
thalach | Detak jantung maksimal yang dicapai dalam pemeriksaan |
target | Label kelas penyakit jantung dalam dataset |
Kita ingin melihat apakah terdapat pola hubungan antara usia dan detak jantung maksimal serta bagaimana distribusinya berdasarkan nilai target.
Mengapa Menggunakan Scatter Plot?
Kolom thalach memiliki banyak nilai numerik yang berbeda. Jika setiap nilai ditampilkan menggunakan diagram batang secara terpisah, grafik dapat menjadi padat dan sulit dibaca.
Scatter Plot lebih sesuai karena dapat menampilkan hubungan antara dua variabel numerik sekaligus.
Membuat Scatter Plot
Jalankan kode berikut di Jupyter Notebook:
import matplotlib.pyplot as plt

# Pisahkan data berdasarkan target
positive = df[df["target"] == 1]
negative = df[df["target"] == 0]

# Buat scatter plot
plt.figure(figsize=(10, 6))

plt.scatter(
    positive["age"],
    positive["thalach"],
    color="salmon",
    label="Disease (target = 1)",
    alpha=0.7
)

plt.scatter(
    negative["age"],
    negative["thalach"],
    color="lightblue",
    label="No Disease (target = 0)",
    alpha=0.7
)

plt.title("Age vs Maximum Heart Rate")
plt.xlabel("Age (years)")
plt.ylabel("Maximum Heart Rate (thalach)")
plt.legend()
plt.tight_layout()
plt.show()
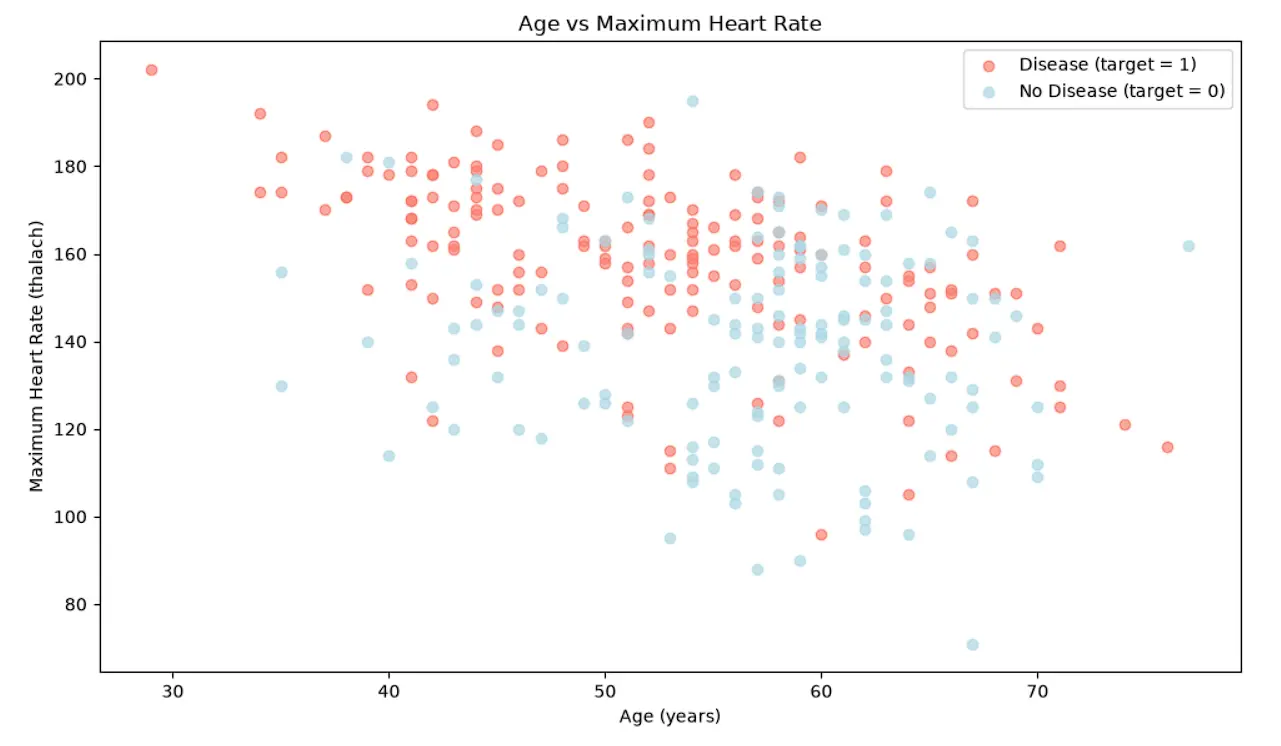
Penjelasan Kode
df[df["target"] == 1]memilih baris dengan target bernilai1.df[df["target"] == 0]memilih baris dengan target bernilai0.plt.figure(figsize=(10, 6))menentukan ukuran grafik.plt.scatter()membuat grafik pencar.colormenentukan warna titik.labelmemberikan nama kelompok pada legenda.alpha=0.7mengatur transparansi titik agar area yang padat lebih mudah diamati.plt.xlabel()danplt.ylabel()memberikan keterangan sumbu.plt.legend()menampilkan legenda untuk membedakan kelompok.
Cara Membaca Grafik
Pada grafik:
- Sumbu X menunjukkan usia pasien.
- Sumbu Y menunjukkan detak jantung maksimal.
- Warna salmon menunjukkan sampel dengan
target = 1. - Warna biru muda menunjukkan sampel dengan
target = 0.
Kita dapat mengamati apakah titik-titik membentuk pola tertentu dan seberapa jauh kedua kelompok saling tumpang tindih.
Jika titik-titik pada usia yang lebih tinggi cenderung memiliki nilai thalach yang lebih rendah, hal tersebut mengindikasikan hubungan negatif antara usia dan detak jantung maksimal pada dataset ini.
Namun, pola tersebut harus diperiksa berdasarkan data aktual. Scatter Plot saja tidak membuktikan bahwa usia menyebabkan penurunan detak jantung maksimal.
Kedua kelompok juga dapat saling tumpang tindih. Artinya, usia dan thalach saja mungkin belum cukup untuk memisahkan kedua kelas secara sempurna.
2. Memeriksa Distribusi Usia dengan Histogram
Selain melihat hubungan dua variabel, kita perlu memahami distribusi satu variabel.
Histogram merupakan grafik yang menunjukkan seberapa banyak nilai data berada dalam rentang tertentu.
Pada project ini, kita menggunakan Histogram untuk memeriksa distribusi usia pasien.
Membuat Histogram
plt.figure(figsize=(10, 6))

plt.hist(
    df["age"],
    bins=10,
    edgecolor="black"
)

plt.title("Age Distribution")
plt.xlabel("Age (years)")
plt.ylabel("Frequency")
plt.tight_layout()
plt.show()

Penjelasan Kode
plt.hist()membuat Histogram.df["age"]menentukan kolom yang divisualisasikan.bins=10membagi rentang nilai menjadi 10 interval.edgecolor="black"memberikan garis pembatas pada batang.Frequencyberarti jumlah sampel yang masuk ke setiap interval usia.
Jumlah interval memengaruhi bentuk grafik. Terlalu sedikit interval dapat menyembunyikan pola, sedangkan terlalu banyak interval dapat membuat distribusi terlihat berisik.
Cara Membaca Histogram
Perhatikan bagian grafik yang memiliki batang paling tinggi. Bagian tersebut menunjukkan rentang usia dengan jumlah sampel terbanyak.
Pada dataset Heart Disease yang umum digunakan dalam project ini, banyak sampel berada di sekitar usia 50–60 tahun. Akan tetapi, rentang yang tepat perlu dilihat dari hasil Histogram yang dihasilkan.
Histogram yang menyerupai kurva lonceng dapat terlihat seperti distribusi normal, tetapi bentuk yang menyerupai kurva lonceng tidak cukup untuk membuktikan bahwa data mengikuti distribusi normal.
Untuk memastikan distribusi normal, diperlukan pemeriksaan tambahan sesuai kebutuhan analisis.
3. Mengenali Outliers
Outliers adalah observasi yang nilainya jauh berbeda dari sebagian besar data lainnya.
Contohnya, jika sebagian besar usia pasien berada pada rentang usia dewasa hingga lanjut usia, tetapi ditemukan nilai usia yang sangat ekstrem, kita perlu memeriksa apakah nilai tersebut benar.
Outliers dapat muncul karena:
- Kesalahan input data.
- Kesalahan pengukuran.
- Karakteristik sampel yang memang berbeda.
- Variasi alami dalam data.
Outliers tidak selalu merupakan kesalahan. Oleh karena itu, kita tidak boleh langsung menghapusnya tanpa memahami penyebabnya.
Memeriksa Statistik Usia
df["age"].describe()
Contoh output:
count    303.000000
mean      54.366337
std        9.082101
min       29.000000
25%       47.500000
50%       55.000000
75%       61.000000
max       77.000000
Name: age, dtype: float64
Output tersebut merupakan ringkasan statistik dari versi dataset Heart Disease yang umum digunakan.
Interpretasi:
count: jumlah observasi yang memiliki nilai usia.mean: rata-rata usia.std: standar deviasi, yang menunjukkan tingkat penyebaran data.min: usia minimum.25%: kuartil pertama.50%: median atau nilai tengah.75%: kuartil ketiga.max: usia maksimum.
Pada contoh ini, usia minimum adalah 29 tahun dan maksimum 77 tahun. Tidak ditemukan nilai usia seperti 150 tahun pada ringkasan tersebut.
Memeriksa Outliers dengan Box Plot
Box Plot dapat membantu mengidentifikasi nilai yang berada jauh dari rentang utama distribusi.
plt.figure(figsize=(10, 3))

plt.boxplot(df["age"], orientation="horizontal")

plt.title("Box Plot of Age")
plt.xlabel("Age (years)")
plt.tight_layout()
plt.show()

Box Plot menampilkan median, kuartil, dan kemungkinan nilai ekstrem berdasarkan aturan statistik yang digunakan untuk membentuk whisker.
Titik yang berada di luar whisker biasanya ditandai sebagai kandidat outlier. Namun, titik tersebut belum tentu merupakan data yang salah.
Jika ditemukan nilai yang mencurigakan, periksa kembali sumber data dan dokumentasinya sebelum memutuskan apakah nilai tersebut perlu diperbaiki, dipertahankan, atau dikeluarkan.
4. Membandingkan Jenis Nyeri Dada (cp) dengan Target
Selanjutnya, kita akan memeriksa hubungan antara kolom cp dan target.
Kolom cp merupakan kode kategori jenis nyeri dada dalam dataset Heart Disease.
Pada versi dataset klasik yang umum digunakan:
Nilai cp | Kode kategori |
|---|---|
0 | Typical angina |
1 | Atypical angina |
2 | Non-anginal pain |
3 | Asymptomatic |
Istilah tersebut merupakan label kategori pada dataset. Penafsirannya dalam konteks klinis harus mengacu pada dokumentasi sumber data dan validasi pakar medis.
Membuat Tabel Silang
Gunakan pd.crosstab() untuk menghitung jumlah sampel pada setiap kombinasi cp dan target.
cp_target = pd.crosstab(
    df["cp"],
    df["target"]
)

print(cp_target)
Contoh output untuk dataset klasik yang umum digunakan:
target    0   1
cp
0        104  39
1          9  41
2         18  69
3          7  16
Tabel tersebut menunjukkan jumlah sampel untuk setiap kategori nyeri dada dan label target.
Sebagai contoh, pada kategori cp = 2, terdapat 69 sampel dengan target = 1 dan 18 sampel dengan target = 0.
Angka ini menunjukkan distribusi label dalam kategori tersebut, bukan bukti bahwa kategori nyeri dada itu menyebabkan penyakit jantung.
Membuat Diagram Batang
cp_target.plot(
    kind="bar",
    figsize=(10, 6),
    color=["lightblue", "salmon"]
)

plt.title("Chest Pain Type vs Heart Disease Target")
plt.xlabel("Chest Pain Type (cp)")
plt.ylabel("Number of Patients")

plt.legend(
    title="Target",
    labels=["No Disease (0)", "Disease (1)"]
)

plt.xticks(rotation=0)
plt.tight_layout()
plt.show()

Grafik ini membantu kita membandingkan jumlah sampel pada setiap kategori cp.
Namun, jumlah sampel antar kategori bisa berbeda. Untuk membandingkan proporsi target dengan lebih adil, kita dapat menggunakan persentase.
Membandingkan Proporsi Target
cp_target_pct = pd.crosstab(
    df["cp"],
    df["target"],
    normalize="index"
) * 100

print(cp_target_pct.round(2))
Contoh output:
target       0      1
cp
0        72.73  27.27
1        18.00  82.00
2        20.69  79.31
3        30.43  69.57
Angka tersebut menunjukkan persentase setiap kelas target di dalam masing-masing kategori cp.
Contohnya, pada kategori cp = 2, sekitar 79,31% sampel memiliki target = 1 dalam dataset ini.
Persentase tersebut merupakan proporsi dalam sampel, bukan estimasi risiko penyakit pada populasi umum.
5. Peran Domain Expert
Dalam project data science, tidak semua pola yang ditemukan mudah dijelaskan hanya dengan melihat angka atau grafik.
Karena itu, Domain Expert atau pakar bidang terkait berperan membantu memvalidasi interpretasi hasil analisis.
Dalam project penyakit jantung, domain expert dapat berupa tenaga medis yang memahami karakteristik klinis pasien dan definisi kategori dalam dataset.
Diskusi dengan pakar diperlukan untuk:
- Memastikan arti setiap variabel dan kode kategori.
- Memahami apakah pola yang ditemukan masuk akal secara klinis.
- Membedakan hubungan statistik dari hubungan sebab-akibat.
- Menilai apakah hasil analisis layak digunakan untuk pertanyaan penelitian tertentu.
EDA merupakan langkah eksplorasi, bukan pengganti penilaian medis atau validasi klinis.
6. Ringkasan
Pada materi ini, kita telah mempelajari tiga teknik eksplorasi lanjutan:
- Scatter Plot untuk membandingkan usia dan detak jantung maksimal berdasarkan target.
- Histogram dan Box Plot untuk memahami distribusi usia serta memeriksa kandidat outliers.
- Cross-tabulation dan Bar Plot untuk membandingkan kategori nyeri dada dengan target.
Teknik tersebut membantu kita menemukan pola awal, memahami karakteristik dataset, dan menentukan pertanyaan yang perlu dianalisis lebih lanjut.
Penting untuk membedakan pola dalam dataset dengan kesimpulan yang berlaku untuk populasi lebih luas.