Hyperparameter Tuning dengan RandomizedSearchCV
Pada materi sebelumnya, kita telah melakukan tuning manual terhadap K-Nearest Neighbors (KNN) dengan mencoba beberapa nilai n_neighbors.
Hasil eksperimen dapat menunjukkan bahwa KNN belum memberikan performa yang kompetitif dibandingkan model lain. Oleh karena itu, pada tahap ini kita akan memfokuskan eksperimen pada dua algoritma:
- Logistic Regression
- Random Forest Classifier
Untuk mencari konfigurasi yang lebih baik, kita akan menggunakan RandomizedSearchCV dari Scikit-Learn. Metode ini menggabungkan pencarian hyperparameter secara acak dengan Cross-Validation sehingga kita tidak perlu menulis loop manual untuk setiap kombinasi parameter.
Tujuan pembelajaran:
- Memahami konsep Cross-Validation.
- Memahami perbedaan Grid Search dan Randomized Search.
- Menentukan hyperparameter yang akan diuji.
- Membuat ruang pencarian untuk Logistic Regression dan Random Forest.
- Menyiapkan eksperimen tuning yang dapat direproduksi.
- Mengevaluasi model terpilih menggunakan test set yang terpisah.
1. Mengapa Menggunakan RandomizedSearchCV?
Pada tuning manual, kita menulis perulangan untuk mencoba berbagai nilai parameter dan menghitung skor setiap konfigurasi.
Pendekatan tersebut cukup mudah untuk satu parameter, tetapi semakin sulit dikelola ketika jumlah parameter dan kombinasi meningkat.
Sebagai contoh, Random Forest memiliki banyak hyperparameter yang dapat disesuaikan:
- Jumlah pohon keputusan.
- Kedalaman maksimum pohon.
- Jumlah minimum sampel untuk membagi simpul.
- Jumlah minimum sampel pada daun pohon.
Jika setiap parameter memiliki banyak pilihan, jumlah kombinasi yang perlu diperiksa dapat meningkat dengan cepat.
RandomizedSearchCV membantu mengatasi masalah tersebut dengan mengambil sejumlah kombinasi parameter dari ruang pencarian yang ditentukan.
1.1 Apa Itu RandomizedSearchCV?
RandomizedSearchCV adalah kelas Scikit-Learn yang menjalankan pencarian hyperparameter dengan memilih kombinasi parameter secara acak, lalu mengevaluasinya menggunakan Cross-Validation.
Secara sederhana, prosesnya adalah:
- Kita menentukan model yang akan dioptimalkan.
- Kita menentukan ruang pencarian hyperparameter.
- Kita menentukan jumlah kombinasi yang akan dicoba.
- Setiap konfigurasi dievaluasi menggunakan Cross-Validation.
- Sistem membandingkan skor validasi.
- Konfigurasi dengan skor terbaik dipilih berdasarkan metrik yang ditentukan.
Contoh import:
from sklearn.model_selection import RandomizedSearchCV
1.2 Perbedaan Grid Search dan Randomized Search
| Aspek | GridSearchCV | RandomizedSearchCV |
|---|---|---|
| Cara mencari | Menguji seluruh kombinasi yang ditentukan | Mengambil sejumlah kombinasi secara acak |
| Jumlah eksperimen | Bergantung pada seluruh kombinasi | Dapat dibatasi dengan n_iter |
| Kecepatan | Dapat lambat jika kombinasi banyak | Dapat lebih hemat komputasi |
| Ruang pencarian besar | Biaya dapat meningkat dengan cepat | Berguna untuk eksplorasi awal |
| Jaminan kombinasi terbaik | Menguji semua kombinasi yang ditentukan | Tidak menjamin kombinasi terbaik dalam seluruh ruang |
Randomized Search tidak otomatis lebih baik daripada Grid Search. Pemilihan metode bergantung pada ukuran ruang pencarian, anggaran komputasi, dan kebutuhan eksperimen.
2. Memahami Cross-Validation
Sebelum menggunakan RandomizedSearchCV, kita perlu memahami Cross-Validation karena metode tersebut menggunakannya untuk mengevaluasi kombinasi hyperparameter.
2.1 Evaluasi dengan Train/Test Split
Pada materi sebelumnya, kita membagi dataset menjadi:
- 80% training set.
- 20% test set.
Model dilatih menggunakan training set, kemudian dievaluasi menggunakan test set.
Pembagian tersebut berguna untuk mengukur performa pada data yang tidak digunakan untuk pelatihan. Namun, jika kita hanya menggunakan satu pembagian data untuk memilih hyperparameter, hasil pemilihan dapat dipengaruhi oleh karakteristik pembagian tersebut.
2.2 Cara Kerja K-Fold Cross-Validation
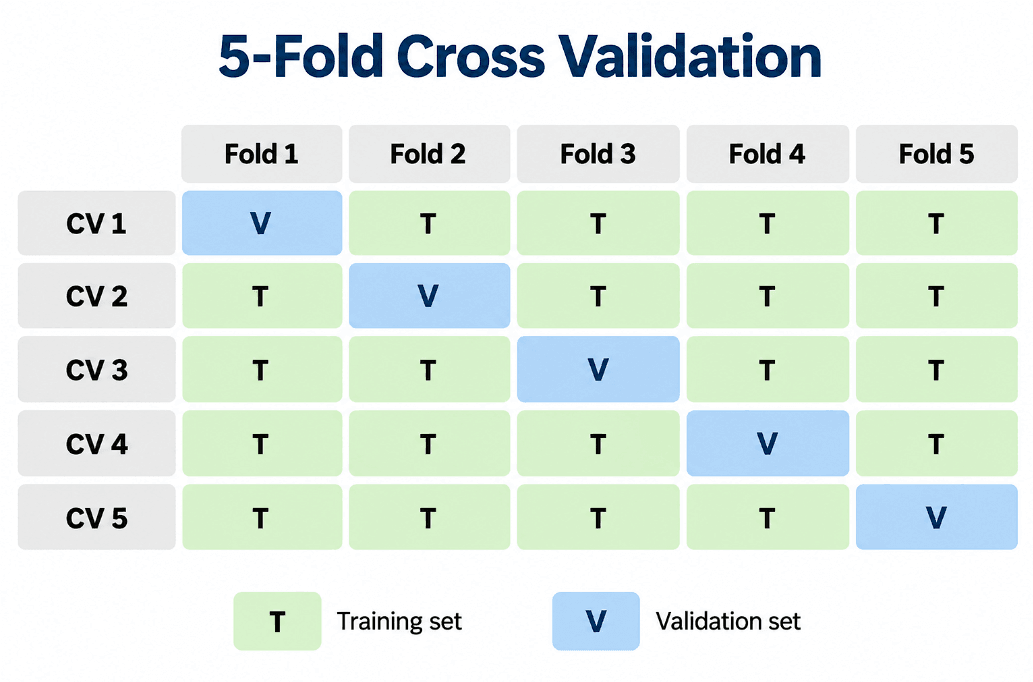
Dalam K-Fold Cross-Validation, data pelatihan dibagi menjadi beberapa bagian yang disebut fold.
Misalnya, kita menggunakan 5-fold Cross-Validation:
- Training set dibagi menjadi lima fold.
- Empat fold digunakan untuk pelatihan, sedangkan satu fold digunakan untuk validasi.
- Proses diulang lima kali sehingga setiap fold pernah menjadi data validasi.
- Skor dari lima putaran diringkas, misalnya dengan menghitung rata-ratanya.
Ilustrasi sederhana:
| Putaran | Data untuk Validasi | Data untuk Pelatihan |
|---|---|---|
| 1 | Fold 1 | Fold 2–5 |
| 2 | Fold 2 | Fold 1, 3–5 |
| 3 | Fold 3 | Fold 1–2, 4–5 |
| 4 | Fold 4 | Fold 1–3, 5 |
| 5 | Fold 5 | Fold 1–4 |
Dalam ilustrasi ini, setiap fold secara bergantian digunakan untuk validasi.
2.3 Mengapa Cross-Validation Penting?
Cross-Validation memberikan beberapa manfaat:
- Mengurangi ketergantungan evaluasi pada satu pembagian training/validasi.
- Membantu membandingkan konfigurasi model secara lebih sistematis.
- Memberikan gambaran variasi performa antar-fold.
- Membantu memilih hyperparameter sebelum evaluasi akhir pada test set.
Namun, Cross-Validation tidak menjamin model bebas dari overfitting. Model masih dapat mengalami overfitting terhadap proses pemilihan hyperparameter jika terlalu banyak konfigurasi dicoba dan hasil validasi terus dijadikan dasar keputusan.
Untuk menjaga evaluasi tetap valid, test set harus dipisahkan sejak awal dan tidak digunakan selama proses tuning.
3. Menentukan Ruang Pencarian Hyperparameter
Ruang pencarian (parameter search space) adalah kumpulan nilai atau distribusi yang dapat dipilih selama eksperimen tuning.
Kita akan menyiapkan ruang pencarian untuk Logistic Regression dan Random Forest.
4. Hyperparameter untuk Logistic Regression
Logistic Regression adalah model klasifikasi yang dapat digunakan untuk memprediksi kelas biner.
Beberapa hyperparameter yang dapat disesuaikan antara lain C dan solver.
4.1 Parameter C
Parameter C mengontrol kekuatan regularisasi secara terbalik.
Secara umum:
- Nilai
Ckecil berarti regularisasi lebih kuat. - Nilai
Cbesar berarti regularisasi lebih lemah.
Regularisasi membantu mengendalikan kompleksitas model. Namun, nilai terbaik bergantung pada dataset dan konfigurasi eksperimen.
Kita dapat membuat rentang nilai C menggunakan NumPy:
import numpy as np

log_reg_grid = {
    "C": np.logspace(-4, 4, 20),
    "solver": ["liblinear", "lbfgs"]
}
4.2 Memahami np.logspace()
Fungsi np.logspace() menghasilkan angka yang tersebar merata pada skala logaritmik.
Contoh:
import numpy as np

values = np.logspace(-4, 4, 20)

print(values)
Rentang tersebut dimulai dari:
hingga:
Angka di antara kedua batas tersebut tersebar secara logaritmik, bukan dengan selisih aritmetika yang tetap.
Pendekatan ini berguna ketika kita ingin mengeksplorasi nilai parameter dari beberapa orde magnitudo.
4.3 Parameter solver
solver menentukan algoritma optimasi yang digunakan untuk melatih Logistic Regression.
Contoh solver:
lbfgsliblinearnewton-cgsagsaga
Tidak semua solver mendukung setiap jenis konfigurasi. Untuk ruang pencarian pada materi ini, kita menggunakan lbfgs dan liblinear dengan konfigurasi regularisasi default yang kompatibel.
Pemilihan solver juga perlu mempertimbangkan ukuran dataset, jenis regularisasi, dan karakteristik masalah.
5. Hyperparameter untuk Random Forest
Random Forest membangun banyak pohon keputusan dan menggabungkan prediksinya.
Beberapa hyperparameter yang dapat memengaruhi kompleksitas dan performanya adalah n_estimators, max_depth, min_samples_split, dan min_samples_leaf.
5.1 Parameter n_estimators
n_estimators menentukan jumlah pohon keputusan dalam hutan.
Contoh:
from sklearn.ensemble import RandomForestClassifier

rf = RandomForestClassifier(
    n_estimators=100,
    random_state=42
)
Nilai yang lebih besar dapat meningkatkan stabilitas prediksi pada kondisi tertentu, tetapi juga membutuhkan waktu komputasi lebih banyak.
Untuk ruang pencarian:
"n_estimators": np.arange(10, 1000, 50)
Ekspresi tersebut menghasilkan nilai mulai dari 10 dengan kenaikan 50, selama nilainya kurang dari 1000.
5.2 Parameter max_depth
max_depth membatasi kedalaman maksimum setiap pohon.
Contoh nilai:
"max_depth": [None, 5, 10, 20, 30]
Maknanya:
None: tidak menetapkan batas kedalaman maksimum secara eksplisit.- Angka positif: membatasi kedalaman pohon.
Pohon yang terlalu dalam dapat mempelajari detail training set secara berlebihan. Membatasi kedalaman dapat membantu mengendalikan kompleksitas model, tetapi nilai terbaik perlu diuji.
5.3 Parameter min_samples_split
Parameter ini menentukan jumlah minimum sampel yang harus tersedia pada suatu simpul agar simpul tersebut dapat dibagi.
Contoh:
"min_samples_split": [2, 5, 10, 20]
Nilai yang lebih besar membatasi pemecahan simpul dan dapat menghasilkan pohon yang lebih sederhana.
5.4 Parameter min_samples_leaf
Parameter ini menentukan jumlah minimum sampel yang harus berada pada setiap daun pohon.
Contoh:
"min_samples_leaf": [1, 2, 4, 8]
Nilai yang lebih besar dapat membuat prediksi lebih halus dan mengurangi kompleksitas pohon.
5.5 Membuat Random Forest Parameter Space
rf_grid = {
    "n_estimators": np.arange(10, 1000, 50),
    "max_depth": [None, 5, 10, 20, 30],
    "min_samples_split": [2, 5, 10, 20],
    "min_samples_leaf": [1, 2, 4, 8]
}
Dictionary ini menentukan kumpulan pilihan untuk setiap parameter.
Karena ruang pencarian memiliki banyak kombinasi, RandomizedSearchCV dapat digunakan untuk menguji sejumlah kombinasi tanpa harus mencoba semuanya.
6. Memahami n_iter dan cv
Ketika membuat RandomizedSearchCV, ada dua parameter penting yang perlu dipahami.
6.1 Parameter n_iter
n_iter menentukan jumlah kombinasi hyperparameter yang akan dicoba.
Contoh:
n_iter=20
Artinya, proses pencarian akan mencoba 20 konfigurasi yang dipilih dari ruang pencarian.
Semakin besar n_iter, semakin banyak konfigurasi yang diuji. Namun, waktu komputasi juga dapat meningkat.
6.2 Parameter cv
Parameter cv menentukan strategi atau jumlah fold untuk Cross-Validation.
Contoh:
cv=5
Untuk klasifikasi, integer cv=5 pada Scikit-Learn umumnya menggunakan 5-fold StratifiedKFold, yang berusaha mempertahankan proporsi kelas pada setiap fold.
Jika terdapat 20 konfigurasi dan 5 fold, proses pencarian umumnya menjalankan sekitar:
proses pelatihan model untuk mengevaluasi seluruh konfigurasi.
Setelah konfigurasi terbaik dipilih, RandomizedSearchCV dengan refit=True secara default akan melatih ulang model terbaik menggunakan seluruh training set.
Jumlah proses sebenarnya dapat bertambah jika ada proses tambahan, pengulangan, atau konfigurasi yang gagal.
7. Menyiapkan RandomizedSearchCV
Setelah ruang pencarian tersedia, kita dapat membuat objek RandomizedSearchCV.
Contoh Logistic Regression:
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import RandomizedSearchCV

log_reg = LogisticRegression(
    max_iter=2000,
    random_state=42
)

rs_log_reg = RandomizedSearchCV(
    estimator=log_reg,
    param_distributions=log_reg_grid,
    n_iter=20,
    cv=5,
    scoring="accuracy",
    random_state=42,
    n_jobs=-1,
    refit=True
)
Penjelasan parameter:
| Parameter | Fungsi |
|---|---|
estimator | Model yang akan dioptimalkan |
param_distributions | Ruang pencarian hyperparameter |
n_iter=20 | Jumlah konfigurasi yang dicoba |
cv=5 | Menggunakan lima fold untuk validasi |
scoring="accuracy" | Menggunakan akurasi sebagai metrik pemilihan |
random_state=42 | Membantu mereproduksi pemilihan konfigurasi |
n_jobs=-1 | Menggunakan seluruh core CPU yang tersedia untuk pekerjaan paralel |
refit=True | Melatih ulang estimator terbaik menggunakan seluruh data yang diberikan ke fit() |
Pada proyek klasifikasi medis, akurasi tidak selalu menjadi metrik pemilihan terbaik. Jika recall kelas positif lebih penting bagi tujuan penelitian, metrik utama dapat diubah menjadi recall, f1, atau metrik lain yang sesuai.
8. Prinsip Evaluasi yang Benar
Sebelum menjalankan tuning, pastikan test set telah dipisahkan dari training set.
Alur yang disarankan:
- Pisahkan data menjadi training set dan test set.
- Jalankan tuning menggunakan training set dan Cross-Validation.
- Pilih konfigurasi terbaik berdasarkan skor validasi.
- Evaluasi model terpilih pada test set.
- Laporkan hasil beserta keterbatasan eksperimen.
Jangan menggunakan test set sebagai data validasi untuk memilih hyperparameter. Jika test set digunakan berulang kali untuk menentukan konfigurasi, hasil akhirnya dapat menjadi terlalu optimistis.
Untuk Logistic Regression dan Random Forest pada materi ini, ruang pencarian dapat dijalankan secara terpisah agar hasil setiap algoritma lebih mudah dianalisis.
9. Contoh Kode Lengkap: RandomizedSearchCV
Kode berikut menggabungkan persiapan data, ruang pencarian hyperparameter, tuning Logistic Regression dan Random Forest, serta evaluasi model terpilih.
Pastikan file heart-disease.csv tersedia di direktori kerja notebook dan memiliki kolom target bernama target.
# ============================================================
# 1. IMPORT LIBRARIES
# ============================================================

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

from sklearn.model_selection import (
    train_test_split,
    RandomizedSearchCV
)

from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import RandomForestClassifier

from sklearn.metrics import (
    accuracy_score,
    classification_report,
    ConfusionMatrixDisplay
)


# ============================================================
# 2. LOAD DATASET
# ============================================================

df = pd.read_csv("heart-disease.csv")

print("Dataset shape:", df.shape)
print("\nTarget distribution:")
print(df["target"].value_counts())


# ============================================================
# 3. SEPARATE FEATURES AND TARGET
# ============================================================

X = df.drop(columns=["target"])
y = df["target"]


# ============================================================
# 4. TRAIN/TEST SPLIT
# ============================================================

X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42,
    stratify=y
)

print("\nTraining shape:", X_train.shape)
print("Testing shape:", X_test.shape)


# ============================================================
# 5. LOGISTIC REGRESSION SEARCH SPACE
# ============================================================

log_reg_grid = {
    "logisticregression__C": np.logspace(-4, 4, 20),
    "logisticregression__solver": ["lbfgs", "liblinear"]
}

log_reg_pipeline = make_pipeline(
    StandardScaler(),
    LogisticRegression(
        max_iter=2000,
        random_state=42
    )
)

rs_log_reg = RandomizedSearchCV(
    estimator=log_reg_pipeline,
    param_distributions=log_reg_grid,
    n_iter=20,
    cv=5,
    scoring="accuracy",
    random_state=42,
    n_jobs=-1,
    refit=True
)


# ============================================================
# 6. RANDOM FOREST SEARCH SPACE
# ============================================================

rf_grid = {
    "n_estimators": np.arange(10, 1000, 50),
    "max_depth": [None, 5, 10, 20, 30],
    "min_samples_split": [2, 5, 10, 20],
    "min_samples_leaf": [1, 2, 4, 8]
}

rf = RandomForestClassifier(
    random_state=42
)

rs_rf = RandomizedSearchCV(
    estimator=rf,
    param_distributions=rf_grid,
    n_iter=20,
    cv=5,
    scoring="accuracy",
    random_state=42,
    n_jobs=-1,
    refit=True
)


# ============================================================
# 7. FIT RANDOMIZED SEARCH
# ============================================================

print("\nTuning Logistic Regression...")
rs_log_reg.fit(X_train, y_train)

print("\nTuning Random Forest...")
rs_rf.fit(X_train, y_train)


# ============================================================
# 8. DISPLAY BEST PARAMETERS AND CV SCORES
# ============================================================

print("\nLogistic Regression best parameters:")
print(rs_log_reg.best_params_)

print(
    "Logistic Regression best CV accuracy:",
    rs_log_reg.best_score_
)

print("\nRandom Forest best parameters:")
print(rs_rf.best_params_)

print(
    "Random Forest best CV accuracy:",
    rs_rf.best_score_
)


# ============================================================
# 9. EVALUATE BEST MODELS ON TEST SET
# ============================================================

best_models = {
    "Logistic Regression": rs_log_reg.best_estimator_,
    "Random Forest": rs_rf.best_estimator_
}

test_results = []

for name, model in best_models.items():
    y_pred = model.predict(X_test)
    accuracy = accuracy_score(y_test, y_pred)

    test_results.append({
        "Model": name,
        "CV Accuracy": (
            rs_log_reg.best_score_
            if name == "Logistic Regression"
            else rs_rf.best_score_
        ),
        "Test Accuracy": accuracy
    })

    print(f"\n{name}")
    print(f"Test accuracy: {accuracy:.4f}")

    print("\nClassification report:")
    print(
        classification_report(
            y_test,
            y_pred,
            zero_division=0
        )
    )

    ConfusionMatrixDisplay.from_predictions(
        y_test,
        y_pred,
        cmap="Blues"
    )

    plt.title(f"Confusion Matrix - {name}")
    plt.tight_layout()
    plt.show()


# ============================================================
# 10. COMPARE TUNED MODELS
# ============================================================

results_df = pd.DataFrame(test_results)

print("\nTuned model comparison:")
print(results_df.to_string(index=False))


# ============================================================
# 11. VISUALIZE TEST ACCURACY
# ============================================================

results_df.plot(
    x="Model",
    y="Test Accuracy",
    kind="bar",
    figsize=(9, 5),
    legend=False
)

plt.title("Test Accuracy After RandomizedSearchCV")
plt.xlabel("Model")
plt.ylabel("Accuracy")
plt.ylim(0, 1)
plt.xticks(rotation=0)
plt.tight_layout()
plt.show()
9.1 Memahami Kode Lengkap
Ada beberapa hal penting pada kode tersebut.
Pertama, Logistic Regression menggunakan Pipeline.
Parameter di dalam pipeline diberi nama dengan format:
logisticregression__Clogisticregression__solver
Bagian sebelum dua garis bawah adalah nama langkah pipeline, sedangkan bagian setelahnya adalah nama parameter model.
Dengan cara ini, RandomizedSearchCV dapat mencari hyperparameter Logistic Regression sekaligus menjalankan standardisasi dengan benar di dalam setiap fold.
Kedua, Random Forest tidak memerlukan StandardScaler untuk kebutuhan umum ini.
Random Forest berbasis pohon keputusan dan umumnya tidak membutuhkan standardisasi fitur seperti KNN atau Logistic Regression.
Ketiga, best_score_ dan test accuracy memiliki fungsi berbeda.
best_score_adalah skor validasi terbaik yang diperoleh selama Cross-Validation.Test Accuracyadalah akurasi model terpilih pada test set yang terpisah.
Kedua skor tersebut tidak harus sama. Perbedaan dapat muncul karena karakteristik data validasi dan test set berbeda.
Keempat, hasil tidak dijamin mencapai akurasi 95%.
Jika hasil tuning belum mencapai target, kita perlu memeriksa kualitas data, preprocessing, metrik lain, variasi skor, dan kemungkinan keterbatasan dataset. Jangan mengubah prosedur evaluasi hanya untuk memperoleh angka yang lebih tinggi.
10. Ringkasan Materi
Pada materi ini, kita telah mempelajari:
- Alasan melakukan hyperparameter tuning.
- Perbedaan Grid Search dan Randomized Search.
- Cara kerja K-Fold Cross-Validation.
- Hyperparameter Logistic Regression, termasuk
Cdansolver. - Hyperparameter Random Forest, termasuk
n_estimators,max_depth,min_samples_split, danmin_samples_leaf. - Penggunaan
n_iter,cv,scoring, danrandom_state. - Penerapan RandomizedSearchCV pada training set.
- Perbedaan skor validasi dan skor test.
- Evaluasi model terpilih menggunakan classification report dan confusion matrix.