Memilih Model Klasifikasi
Memilih Model Klasifikasi dan Membuat Fungsi Training & Evaluation
Pada tahap sebelumnya, kita telah memisahkan dataset menjadi fitur (X) dan label (y), kemudian membaginya menjadi training set dan test set.
Pada materi ini, kita mulai melatih beberapa model Machine Learning untuk menyelesaikan proyek Heart Disease Classification. Kita juga akan membuat fungsi otomatisasi agar proses pelatihan dan evaluasi beberapa model dapat dilakukan secara konsisten tanpa menulis kode yang sama berulang kali.
Tujuan pembelajaran:
- Memahami tiga algoritma klasifikasi yang akan dibandingkan.
- Menyimpan beberapa model dalam Python dictionary.
- Memahami fungsi
fit()danscore(). - Membuat fungsi
fit_and_score()untuk melatih dan mengevaluasi beberapa model. - Membandingkan hasil akurasi awal setiap model.
1. Memilih Model Machine Learning
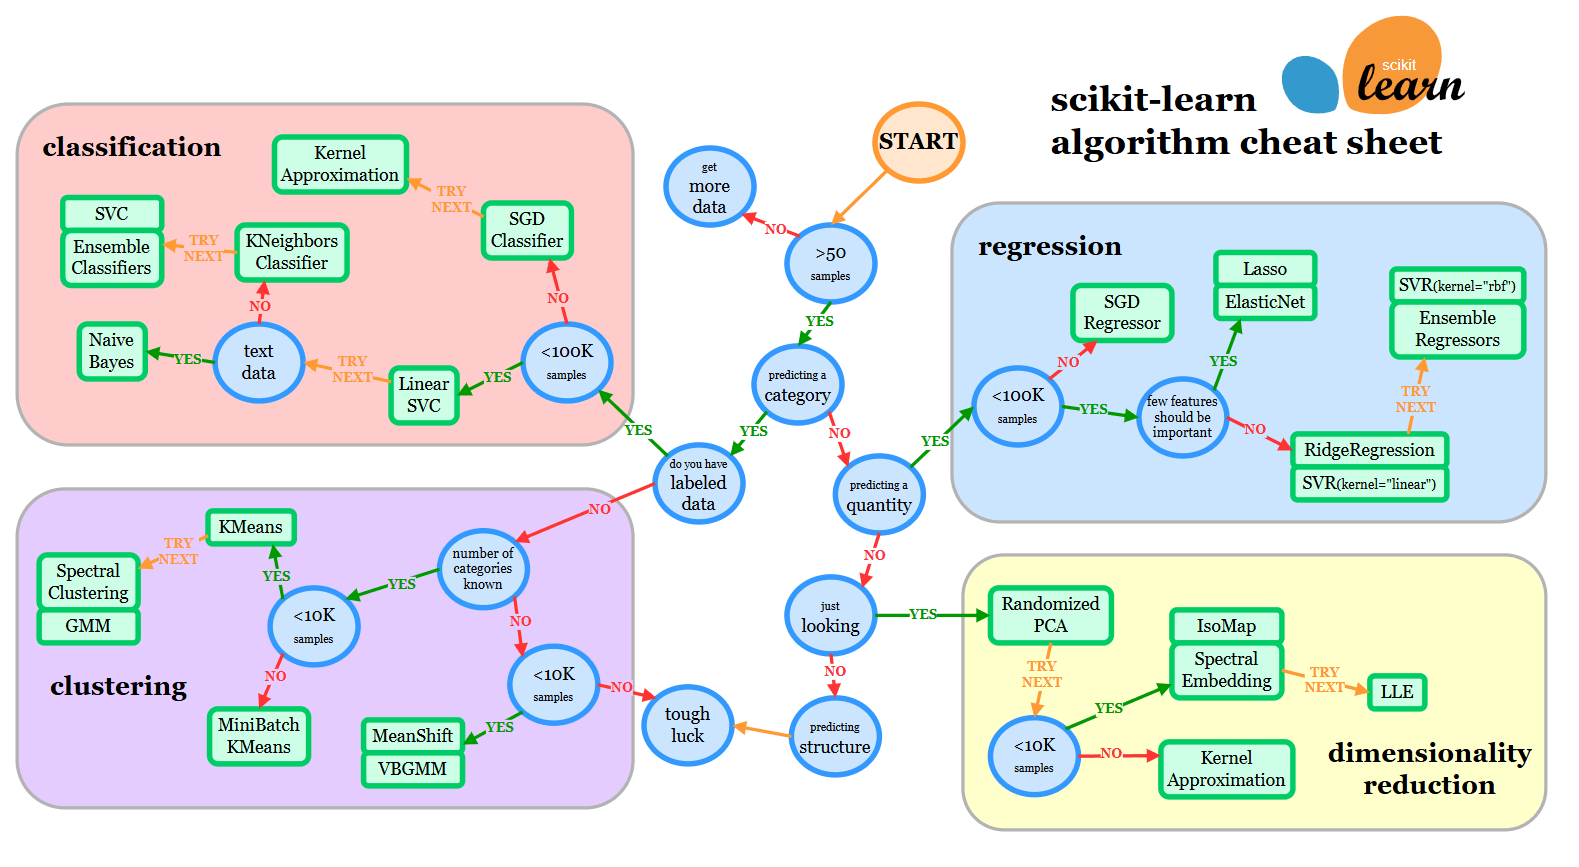
Tidak ada satu algoritma yang selalu memberikan hasil terbaik untuk semua dataset. Karena itu, kita akan menguji beberapa algoritma dan membandingkan performanya menggunakan data yang sama.
Dalam proyek ini, kita menggunakan tiga model klasifikasi:
- Logistic Regression
- K-Nearest Neighbors (KNN)
- Random Forest Classifier
1.1 Logistic Regression
Logistic Regression adalah algoritma yang umum digunakan untuk masalah klasifikasi, termasuk klasifikasi biner.
Meskipun memiliki kata regression pada namanya, algoritma ini dapat memperkirakan probabilitas suatu sampel termasuk ke dalam kelas tertentu.
Contoh implementasi:
from sklearn.linear_model import LogisticRegression

log_reg = LogisticRegression(
    max_iter=1000,
    random_state=42
)
Penjelasan:
LogisticRegression()membuat objek model.max_iter=1000menentukan batas maksimum iterasi optimasi.random_state=42membantu reproduksibilitas pada bagian algoritma yang menggunakan randomness.
Logistic Regression dapat menjadi model baseline yang baik. Untuk dataset dengan skala fitur yang berbeda, standardisasi fitur biasanya perlu dipertimbangkan.
1.2 K-Nearest Neighbors (KNN)
KNN mengklasifikasikan sampel berdasarkan kelas dari sejumlah tetangga terdekatnya.
Contoh implementasi:
from sklearn.neighbors import KNeighborsClassifier

knn = KNeighborsClassifier()
Parameter utama yang dapat diatur adalah n_neighbors, yaitu jumlah tetangga yang dipertimbangkan untuk menentukan prediksi.
Contoh:
knn = KNeighborsClassifier(
    n_neighbors=5
)
Artinya, model mempertimbangkan lima tetangga terdekat ketika membuat prediksi dengan konfigurasi tersebut.
KNN menggunakan perhitungan jarak sehingga sensitif terhadap skala fitur. Oleh sebab itu, standardisasi biasanya penting sebelum membandingkan KNN dengan algoritma lain.
1.3 Random Forest Classifier
Random Forest merupakan algoritma ensemble yang menggabungkan prediksi dari banyak decision tree.
Contoh implementasi:
from sklearn.ensemble import RandomForestClassifier

rf = RandomForestClassifier(
    random_state=42
)
Beberapa karakteristik Random Forest:
- Dapat mempelajari hubungan nonlinier.
- Menggabungkan banyak pohon keputusan.
- Umumnya tidak memerlukan standardisasi fitur seperti KNN.
- Memiliki parameter yang dapat disesuaikan, seperti
n_estimatorsdanmax_depth.
Ketiga model tersebut akan dilatih dan dievaluasi menggunakan pembagian data yang sama agar perbandingan awal lebih konsisten.
2. Menyimpan Model dalam Python Dictionary
Jika kita memiliki beberapa model, menuliskan proses pelatihan dan evaluasi secara terpisah untuk setiap model akan menghasilkan kode berulang.
Python menyediakan struktur data bernama dictionary yang dapat menyimpan pasangan kunci dan nilai (key-value pairs).
Dalam contoh ini:
- Key: Nama model.
- Value: Objek model Machine Learning.
2.1 Membuat Dictionary Model
from sklearn.linear_model import LogisticRegression
from sklearn.neighbors import KNeighborsClassifier
from sklearn.ensemble import RandomForestClassifier

models = {
    "Logistic Regression": LogisticRegression(
        max_iter=1000,
        random_state=42
    ),
    "KNN": KNeighborsClassifier(),
    "Random Forest": RandomForestClassifier(
        random_state=42
    )
}
Variabel models sekarang menyimpan tiga objek model.
2.2 Memeriksa Model yang Tersimpan
print(models.keys())
Contoh output:
dict_keys(['Logistic Regression', 'KNN', 'Random Forest'])
Kita juga dapat melakukan iterasi untuk melihat nama model:
for name, model in models.items():
    print(name, ":", type(model).__name__)
Contoh output:
Logistic Regression : LogisticRegression
KNN : KNeighborsClassifier
Random Forest : RandomForestClassifier
Penjelasan:
models.items()mengembalikan pasangan nama dan objek model.namemenyimpan nama model.modelmenyimpan objek algoritma yang akan dilatih.type(model).__name__menampilkan nama kelas objek model.
Dengan dictionary, kita dapat menambahkan model lain tanpa perlu menulis ulang seluruh alur pelatihan dan evaluasi.
3. Memahami fit() dan score()
Sebelum membuat fungsi otomatisasi, kita perlu memahami dua metode penting pada model Scikit-Learn, yaitu fit() dan score().
3.1 Fungsi fit()
Metode fit() digunakan untuk melatih model menggunakan data training.
Contoh:
model = LogisticRegression(
    max_iter=1000,
    random_state=42
)

model.fit(X_train, y_train)
Penjelasan:
X_trainberisi fitur untuk pelatihan.y_trainberisi label yang menjadi target pembelajaran.fit()menjalankan proses pembelajaran sesuai algoritma yang digunakan.
Setelah proses tersebut selesai, objek model telah mempelajari pola dari data training.
3.2 Fungsi score()
Untuk classifier Scikit-Learn yang digunakan dalam materi ini, metode score() secara default menghitung akurasi pada data yang diberikan.
Contoh:
accuracy = model.score(X_test, y_test)

print("Test accuracy:", accuracy)
Akurasi dihitung dengan rumus:
Sebagai contoh ilustratif, jika model menghasilkan 50 prediksi benar dari 61 sampel pengujian, akurasinya adalah:
Artinya, akurasi sekitar 81,97%.
Angka tersebut hanya contoh perhitungan, bukan hasil eksperimen dari model yang sedang kita bangun.
Catatan: Akurasi saja belum cukup untuk menilai model klasifikasi penyakit jantung. Pada tahap evaluasi lanjutan, kita juga akan memeriksa precision, recall, F1-score, dan confusion matrix.
4. Membuat Fungsi fit_and_score()
Kita akan membuat fungsi bernama fit_and_score() untuk mengotomatisasi proses pelatihan dan evaluasi beberapa model.
Fungsi ini akan:
- Menerima dictionary berisi model.
- Menerima data training dan testing.
- Melakukan iterasi terhadap setiap model.
- Melatih setiap model dengan
fit(). - Menghitung akurasi pada data testing menggunakan
score(). - Menyimpan hasil akurasi ke dalam dictionary.
- Mengembalikan seluruh skor model.
4.1 Implementasi Fungsi
def fit_and_score(
    models,
    X_train,
    X_test,
    y_train,
    y_test
):
    """
    Melatih beberapa model klasifikasi dan menghitung
    akurasi masing-masing pada data testing.

    Parameters
    ----------
    models : dict
        Dictionary yang berisi nama dan objek model.
    X_train : DataFrame atau array
        Fitur untuk pelatihan.
    X_test : DataFrame atau array
        Fitur untuk pengujian.
    y_train : Series atau array
        Label untuk pelatihan.
    y_test : Series atau array
        Label untuk pengujian.

    Returns
    -------
    dict
        Dictionary berisi nama model dan akurasi testing.
    """

    # tambahkan np.random.seed(42), jika model belum memiliki parameter random_state

    model_scores = {}

    for name, model in models.items():
        model.fit(X_train, y_train)

        score = model.score(X_test, y_test)

        model_scores[name] = score

    return model_scores
4.2 Memahami Setiap Bagian Fungsi
Bagian 1 - Parameter fungsi
def fit_and_score(
    models,
    X_train,
    X_test,
    y_train,
    y_test
):
Fungsi menerima lima parameter:
| Parameter | Fungsi |
|---|---|
models | Dictionary yang berisi model-model yang akan diuji |
X_train | Fitur data training |
X_test | Fitur data testing |
y_train | Label data training |
y_test | Label data testing |
Bagian 2 - Membuat dictionary skor
model_scores = {}
Dictionary kosong ini akan digunakan untuk menyimpan hasil akurasi setiap model.
Bagian 3 - Melakukan perulangan
for name, model in models.items():
Perulangan mengambil setiap pasangan nama dan objek model dari dictionary models.
Pada iterasi pertama, fungsi memproses Logistic Regression. Iterasi berikutnya memproses KNN, kemudian Random Forest.
Bagian 4 - Melatih model
model.fit(X_train, y_train)
Setiap model dilatih menggunakan data training yang sama.
Bagian 5 - Menghitung akurasi
score = model.score(X_test, y_test)
Model yang telah dilatih dievaluasi menggunakan fitur dan label dari test set.
Bagian 6 - Menyimpan hasil
model_scores[name] = score
Hasil akurasi disimpan menggunakan nama model sebagai kunci dictionary.
Bagian 7 - Mengembalikan hasil
return model_scores
Setelah seluruh model diproses, fungsi mengembalikan dictionary yang berisi skor setiap model.
5. Menjalankan Fungsi untuk Semua Model
Setelah fungsi selesai dibuat, kita dapat memanggilnya menggunakan dictionary model dan data yang telah disiapkan sebelumnya.
model_scores = fit_and_score(
    models=models,
    X_train=X_train,
    X_test=X_test,
    y_train=y_train,
    y_test=y_test
)

print(model_scores)
Output akan berupa dictionary yang berisi nama model dan skor akurasinya. Nilai sebenarnya bergantung pada data, pembagian training/testing, parameter, dan versi perangkat lunak yang digunakan.
Contoh ilustratif:
{
    'Logistic Regression': 0.82,
    'KNN': 0.75,
    'Random Forest': 0.80
}
Penting: Angka di atas hanya contoh untuk memperlihatkan bentuk output. Angka tersebut bukan hasil pengujian aktual dan tidak boleh digunakan sebagai kesimpulan penelitian.
6. Menampilkan Hasil dalam Bentuk Tabel
Agar hasil eksperimen lebih mudah dibaca, kita dapat mengubah dictionary skor menjadi Pandas DataFrame.
import pandas as pd

scores_df = pd.DataFrame(
    model_scores.items(),
    columns=["Model", "Accuracy"]
)

scores_df = scores_df.sort_values(
    by="Accuracy",
    ascending=False
)

print(scores_df)
Contoh tampilan ilustratif:
                 Model  Accuracy
0  Logistic Regression      0.82
2        Random Forest      0.80
1                   KNN      0.75
Dengan tabel ini, kita dapat melihat model dengan akurasi testing tertinggi pada eksperimen awal.
Namun, model dengan akurasi tertinggi belum tentu merupakan model terbaik secara keseluruhan. Kita masih perlu mempertimbangkan metrik lain dan memastikan evaluasi dilakukan dengan prosedur yang benar.
7. Catatan Penting tentang Validitas Eksperimen
Sebelum melanjutkan, ada beberapa hal yang perlu diperhatikan.
7.1 Jangan Menggunakan Test Set untuk Semua Keputusan
Fungsi di atas menghitung akurasi test set untuk setiap model. Ini berguna untuk demonstrasi awal, tetapi jika hasil test set terus digunakan untuk memilih model dan mengatur parameter, test set secara tidak langsung ikut memengaruhi proses pengembangan.
Untuk eksperimen yang lebih kuat:
- Gunakan training set untuk melatih model.
- Gunakan cross-validation pada training set untuk membandingkan model dan memilih parameter.
- Setelah keputusan pemodelan selesai, gunakan test set untuk evaluasi akhir.
7.2 Standardisasi untuk KNN dan Logistic Regression
KNN sangat dipengaruhi oleh skala fitur. Logistic Regression juga sering memperoleh manfaat dari standardisasi, khususnya ketika fitur memiliki rentang yang berbeda.
Standardisasi sebaiknya dimasukkan ke dalam Pipeline agar scaler hanya mempelajari statistik dari data training.
Contoh pipeline untuk KNN:
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.neighbors import KNeighborsClassifier

knn = make_pipeline(
    StandardScaler(),
    KNeighborsClassifier()
)
Pipeline ini dapat dimasukkan ke dalam dictionary models dan diproses menggunakan fungsi fit_and_score() yang sama.
Random Forest umumnya tidak membutuhkan standardisasi fitur dengan cara yang sama.
7.3 Perhatikan Metrik Selain Akurasi
Dalam proyek klasifikasi penyakit jantung, kita tidak sebaiknya hanya memilih model berdasarkan akurasi.
- Precision: Mengukur ketepatan prediksi positif.
- Recall: Mengukur proporsi label positif yang berhasil ditemukan.
- F1-score: Menggabungkan precision dan recall.
- Confusion matrix: Memperlihatkan prediksi benar dan salah untuk setiap kelas.
Model dengan akurasi lebih tinggi belum tentu memiliki recall yang lebih baik untuk kelas positif. Karena itu, interpretasi hasil harus sesuai dengan tujuan penelitian dan keterbatasan dataset.
8. Ringkasan Materi
Pada materi ini, kita telah mempelajari:
- Memilih Logistic Regression, KNN, dan Random Forest sebagai model awal.
- Menyimpan objek model dalam Python dictionary.
- Memahami proses pelatihan menggunakan
fit(). - Menghitung akurasi menggunakan
score(). - Membuat fungsi
fit_and_score()untuk mengurangi kode berulang. - Mengumpulkan skor model dalam dictionary.
- Menampilkan hasil perbandingan dalam tabel.
- Memahami keterbatasan akurasi dan pentingnya evaluasi yang valid.
Fungsi fit_and_score() dapat menjadi fondasi untuk eksperimen berikutnya. Kita dapat mengembangkannya agar menghasilkan beberapa metrik evaluasi, menjalankan cross-validation, dan membandingkan model dengan prosedur yang lebih sistematis.