AI, Machine Learning, Deep Learning & Data Science
Sebelum mempelajari Machine Learning lebih jauh, penting untuk memahami hubungan antara Artificial Intelligence (AI), Machine Learning (ML), Deep Learning, dan Data Science.
Keempat istilah tersebut sering digunakan secara bersamaan, tetapi sebenarnya memiliki cakupan dan tujuan yang berbeda.
Secara sederhana, hubungan konsepnya dapat digambarkan sebagai berikut:
Artificial Intelligence (AI)
│
└── Machine Learning (ML)
    │
    └── Deep Learning
Sementara Data Science merupakan bidang yang lebih luas dan bersinggungan dengan statistik, analisis data, pemrosesan data, dan Machine Learning.
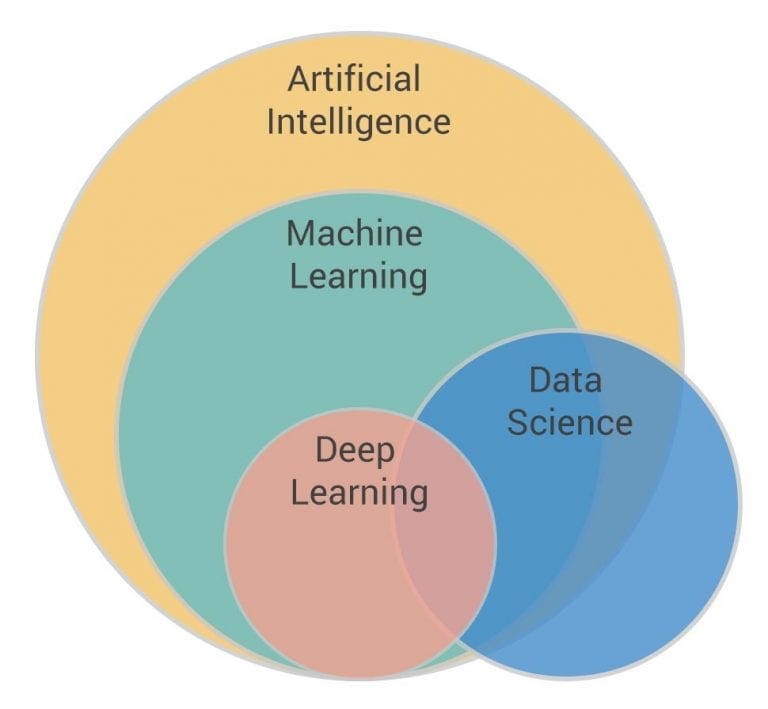
Artificial Intelligence (AI)
Artificial Intelligence (AI) atau kecerdasan buatan merupakan bidang ilmu komputer yang berfokus pada pembuatan sistem yang mampu melakukan tugas yang biasanya membutuhkan kecerdasan manusia.
Contohnya:
Mengenali gambar
Memahami bahasa
Mengambil keputusan
Mengenali suara
Memecahkan masalah
AI merupakan istilah yang memiliki cakupan sangat luas.
Machine Learning merupakan salah satu pendekatan yang digunakan untuk membangun sistem AI.
Machine Learning (ML)
Machine Learning merupakan cabang dari AI yang memungkinkan komputer mempelajari pola dari data.
Pada pemrograman tradisional, programmer biasanya menentukan aturan secara eksplisit.
Data + Rules
   ↓
Program
   ↓
Output
Sedangkan Machine Learning menggunakan pendekatan:
Data
 ↓
Algorithm
 ↓
Learning
 ↓
Model
 ↓
Prediction
Model belajar dari data yang diberikan sehingga dapat digunakan untuk menghasilkan prediksi atau keputusan terhadap data baru.
Contohnya:
Spam Detection
Prediksi Harga Rumah
Rekomendasi Produk
Klasifikasi Gambar
Prediksi Permintaan
Deep Learning
Deep Learning merupakan sub-bidang dari Machine Learning yang menggunakan neural network dengan banyak lapisan untuk mempelajari pola yang kompleks.
Deep Learning sangat banyak digunakan pada data yang kompleks seperti:
Gambar
Suara
Video
Teks
Hubungannya dapat digambarkan:
Artificial Intelligence
        ↓
Machine Learning
        ↓
Deep Learning
Dengan kata lain:
Semua Deep Learning merupakan bagian dari Machine Learning, tetapi tidak semua Machine Learning menggunakan Deep Learning.
Data Science
Data Science merupakan bidang interdisipliner yang menggunakan berbagai metode untuk mengolah data dan menghasilkan informasi atau insight yang berguna.
Data Science dapat menggabungkan:
Statistik
Pemrograman
Data Processing
Data Analysis
Data Visualization
Machine Learning
Tujuannya bukan hanya membuat model Machine Learning, tetapi juga memahami data dan menemukan informasi yang dapat membantu pengambilan keputusan.
Secara sederhana:
Data
 ↓
Collect
 ↓
Clean
 ↓
Analyze
 ↓
Visualize
 ↓
Find Insights
 ↓
Decision
Machine Learning dapat menjadi salah satu bagian dari workflow Data Science.
Perbedaan AI, ML, Deep Learning, dan Data Science
| Konsep | Fokus Utama |
|---|---|
| AI | Membuat sistem yang memiliki kemampuan "cerdas" |
| Machine Learning | Membuat sistem belajar dari data |
| Deep Learning | Machine Learning berbasis neural network berlapis |
| Data Science | Mengolah dan menganalisis data untuk menghasilkan insight |
Cara sederhana untuk mengingatnya:
AI
↓
Konsep kecerdasan buatan secara luas

ML
↓
Sistem belajar dari data

Deep Learning
↓
ML menggunakan neural network berlapis

Data Science
↓
Mengolah data untuk menemukan insight
Jenis-Jenis Machine Learning
Machine Learning memiliki beberapa pendekatan pembelajaran.
Tiga kategori yang umum diperkenalkan adalah:
Machine Learning
│
├── Supervised Learning
├── Unsupervised Learning
└── Reinforcement Learning
Supervised Learning
Supervised Learning adalah metode Machine Learning yang menggunakan data yang sudah memiliki label.
Model diberikan data beserta jawaban yang benar sehingga model dapat mempelajari hubungan antara input dan output.
Contoh:
Input                  Label
──────────────────────────────
Ukuran rumah           Harga
Lokasi rumah           Harga
Luas tanah             Harga
Model mempelajari hubungan tersebut untuk menghasilkan prediksi terhadap data baru.
Contoh penerapan:
Prediksi harga rumah
Klasifikasi email spam
Klasifikasi gambar
Prediksi nilai
Secara sederhana:
Data + Label
     ↓
Training
     ↓
   Model
     ↓
Prediksi
Unsupervised Learning
Unsupervised Learning menggunakan data yang tidak memiliki label.
Model mencoba menemukan struktur atau pola yang terdapat di dalam data secara mandiri.
Contohnya adalah customer clustering.
Misalnya kita memiliki data pelanggan:
Pelanggan A
Pelanggan B
Pelanggan C
Pelanggan D
Pelanggan E
Model dapat menemukan kelompok pelanggan berdasarkan karakteristik tertentu.
Data Pelanggan
      ↓
Clustering
      ↓
┌──────────┐
│ Group 1  │
├──────────┤
│ Group 2  │
├──────────┤
│ Group 3  │
└──────────┘
Contoh penerapan:
Customer Clustering
Segmentasi pelanggan
Menemukan pola data
Analisis kelompok
Reinforcement Learning
Reinforcement Learning menggunakan pendekatan berbeda.
Sebuah agent belajar mengambil keputusan dengan berinteraksi dengan environment.
Agent akan mendapatkan reward atau konsekuensi berdasarkan tindakan yang dilakukan.
Secara sederhana:
        Environment
             ↑
             │
          Action
             │
          Agent
             │
          Reward
             ↓
        Learning
Model belajar berdasarkan pengalaman dari interaksi tersebut.
Contoh penerapan:
Game
Robot
Sistem kontrol
Kendaraan otonom
Salah satu contoh yang mudah dibayangkan adalah AI yang belajar memainkan permainan.
Action
  ↓
Reward / Punishment
  ↓
Learning
  ↓
Better Action
Tools dalam Data Science dan Machine Learning
Ekosistem Python menyediakan berbagai library yang membantu proses pengolahan data dan Machine Learning.
Beberapa library dan platform yang umum digunakan adalah:
NumPy
Pandas
Matplotlib
Seaborn
scikit-learn
Jupyter Notebook
Kaggle
NumPy
NumPy digunakan untuk komputasi numerik dan manipulasi array.
NumPy banyak digunakan untuk:
Array
Operasi matematika
Vektor
Matriks
Komputasi numerik
Contoh sederhana:
import numpy as np

data = np.array([1, 2, 3, 4, 5])

print(data)
NumPy menjadi salah satu fondasi penting dalam ekosistem pengolahan data Python.
Pandas
Pandas digunakan untuk manipulasi dan analisis data.
Salah satu struktur data utama Pandas adalah:
DataFrame
DataFrame dapat dibayangkan seperti tabel:
Nama      Umur      Kota
-------------------------
Budi      25        Palu
Andi      30        Jakarta
Sinta     28        Bandung
Pandas banyak digunakan untuk:
Membaca dataset
Membersihkan data
Filtering
Transformasi data
Analisis data
Matplotlib dan Seaborn
Data sering kali lebih mudah dipahami melalui visualisasi.
Matplotlib digunakan untuk membuat berbagai jenis grafik.
Seaborn menyediakan API visualisasi statistik yang dibangun di atas Matplotlib.
Contoh visualisasi:
Line Chart
Bar Chart
Scatter Plot
Histogram
Visualisasi membantu kita memahami:
Tren
Distribusi
Hubungan antar variabel
Pola data
Outlier
Scikit-learn
scikit-learn merupakan salah satu library Python yang banyak digunakan untuk Machine Learning.
Library ini menyediakan berbagai tools untuk:
Classification
Regression
Clustering
Preprocessing
Model Selection
Model Evaluation
Dengan scikit-learn, kita dapat melakukan berbagai tahap Machine Learning tanpa harus mengimplementasikan setiap algoritma dari awal.
Jupyter Notebook
Jupyter Notebook menyediakan lingkungan interaktif untuk menjalankan kode, menampilkan hasil, membuat visualisasi, dan menulis penjelasan dalam satu dokumen.
Workflow sederhananya:
Code
 ↓
Run
 ↓
Output
 ↓
Analysis
 ↓
Visualization
Jupyter Notebook sangat populer dalam proses eksplorasi data dan pembelajaran Machine Learning.
Kaggle
Kaggle merupakan platform yang menyediakan berbagai dataset, notebook, dan kompetisi Data Science serta Machine Learning.
Kaggle dapat digunakan untuk:
Mencari dataset
Berlatih Machine Learning
Mempelajari notebook
Mengikuti kompetisi
Melihat solusi dari pengguna lain
Bagi pembelajar, Kaggle dapat menjadi tempat yang baik untuk mendapatkan pengalaman menggunakan dataset nyata.
Workflow Machine Learning
Membangun model Machine Learning bukan hanya tentang memilih algoritma.
Terdapat beberapa tahap yang biasanya dilakukan.
Data Collection
      ↓
Data Preprocessing
      ↓
Data Splitting
      ↓
Model Selection
      ↓
Model Training
      ↓
Model Evaluation
      ↓
Model Tuning
      ↓
Deployment
Setiap tahap memiliki tujuan masing-masing.
Data Collection
Tahap pertama adalah mengumpulkan data yang dibutuhkan.
Data dapat berasal dari berbagai sumber:
CSV
Database
API
Sensor
Website
Kaggle
Contohnya, jika ingin membuat model untuk memprediksi harga rumah, kita membutuhkan dataset yang berisi informasi seperti:
Luas rumah
Jumlah kamar
Lokasi
Luas tanah
Harga
Data Preprocessing
Data mentah biasanya belum siap digunakan untuk Machine Learning.
Data perlu diperiksa dan dipersiapkan terlebih dahulu.
Beberapa proses yang dapat dilakukan:
Data Cleaning
Missing Value Handling
Data Transformation
Feature Selection
Feature Engineering
Tujuannya adalah menghasilkan dataset yang lebih siap digunakan untuk proses training.
Data Splitting
Dataset biasanya dibagi menjadi beberapa bagian.
Salah satu pembagian yang umum adalah:
Dataset
   │
   ├── Training Set
   │
   └── Test Set
Training Set
Digunakan untuk melatih model.
Training Data
      ↓
Model Learning
Test Set
Digunakan untuk menguji performa model terhadap data yang tidak digunakan dalam proses training.
Test Data
    ↓
Trained Model
    ↓
Prediction
    ↓
Evaluation
Pembagian data membantu kita mengetahui apakah model mampu bekerja dengan baik pada data yang belum pernah dilihat sebelumnya.
Model Selection
Setelah data siap, kita perlu memilih algoritma yang sesuai dengan masalah.
Contohnya:
Classification
     ↓
K-Nearest Neighbors

Regression
     ↓
Linear Regression

Clustering
     ↓
Clustering Algorithm
Pemilihan model bergantung pada jenis masalah, karakteristik data, dan tujuan yang ingin dicapai.
Model Training
Pada tahap training, model mempelajari pola dari training data.
Secara sederhana:
Training Data
    ↓
Algorithm
    ↓
Learning
    ↓
Trained Model
Model yang telah dilatih kemudian dapat digunakan untuk melakukan prediksi.
Model Evaluation
Model tidak cukup hanya dilatih.
Kita juga perlu mengetahui seberapa baik performanya.
Test Data
  ↓
Model
  ↓
Prediction
  ↓
Evaluation
Metode evaluasi bergantung pada jenis masalah yang sedang dikerjakan.
Contohnya, pada masalah klasifikasi kita dapat menggunakan metrik seperti:
Accuracy
Precision
Recall
F1 Score
Model Tuning
Jika performa model belum sesuai harapan, model dapat disesuaikan.
Proses ini dapat melibatkan:
Parameter Tuning
Feature Selection
Data Processing
Pemilihan Algorithm
Tujuannya adalah mendapatkan model dengan performa yang lebih baik.
Model Deployment
Setelah model selesai dibuat dan dievaluasi, model dapat digunakan dalam aplikasi atau sistem nyata.
Secara sederhana:
Training
   ↓
Evaluation
   ↓
 Model
   ↓
 Save
   ↓
Application
Model dapat disimpan menggunakan tools seperti joblib dan kemudian digunakan kembali oleh aplikasi.
Gambaran Besar Machine Learning
Jika seluruh konsep di atas digabungkan, workflow Machine Learning dapat digambarkan seperti berikut:
                 DATA
                  │
                  ▼
          Data Collection
                  │
                  ▼
         Data Preprocessing
                  │
                  ▼
            Data Splitting
             │          │
             ▼          ▼
         Training      Testing
             │          │
             ▼          │
        Model Training  │
             │          │
             └─────┬────┘
                   ▼
             Evaluation
                   │
                   ▼
             Model Tuning
                   │
                   ▼
              Deployment
Workflow tersebut tidak selalu berjalan secara linear. Dalam praktiknya, kita sering kembali ke tahap sebelumnya untuk memperbaiki data, fitur, atau model.
Ringkasan
Machine Learning merupakan bagian dari ekosistem yang lebih luas.
AI
│
└── Machine Learning
    │
    └── Deep Learning
Sedangkan Data Science menggunakan berbagai pendekatan untuk memahami dan menghasilkan insight dari data.
Tiga pendekatan Machine Learning yang perlu dikenali:
Supervised Learning
        ↓
Belajar dari data berlabel

Unsupervised Learning
        ↓
Menemukan pola dari data tanpa label

Reinforcement Learning
        ↓
Belajar melalui reward dan interaksi dengan environment
Beberapa tools penting dalam ekosistem Python:
| Tool | Fungsi |
|---|---|
NumPy | Komputasi numerik |
Pandas | Manipulasi dan analisis data |
Matplotlib | Visualisasi data |
Seaborn | Visualisasi statistik |
scikit-learn | Machine Learning |
Jupyter Notebook | Eksplorasi dan analisis interaktif |
Kaggle | Dataset, notebook, dan kompetisi |
Kesimpulan
Machine Learning bukan hanya tentang menjalankan sebuah algoritma dan mendapatkan prediksi.
Prosesnya dimulai dari data, kemudian data dipersiapkan, dibagi, digunakan untuk melatih model, dievaluasi, dan akhirnya dapat digunakan dalam aplikasi nyata.
Data
 ↓
Processing
 ↓
Training
 ↓
Model
 ↓
Evaluation
 ↓
Deployment
Memahami workflow tersebut akan menjadi dasar penting sebelum mulai mempelajari algoritma Machine Learning secara lebih mendalam.