Evaluation
Evaluation atau evaluasi merupakan langkah ketiga dalam Machine Learning Framework / Machine Learning Workflow.
Setelah kita:
- mendefinisikan masalah,
- memahami data,
kita perlu menentukan bagaimana cara mengetahui apakah solusi Machine Learning yang kita buat berhasil atau tidak.
Pertanyaan utama pada tahap ini adalah:
"What defines success for us?"
atau:
"Apa yang mendefinisikan keberhasilan bagi kita?"
Machine Learning tidak cukup hanya menghasilkan prediksi. Kita perlu mengetahui seberapa baik prediksi tersebut.
Untuk itu, kita menggunakan evaluation metrics atau metrik evaluasi.
Apa Itu Evaluation Metric?
Evaluation metric adalah ukuran yang digunakan untuk menilai performa sebuah model Machine Learning.
Misalnya kita membuat model untuk memprediksi apakah pasien memiliki penyakit tertentu.
Model menghasilkan:
Prediksi model:
Pasien A → Sakit
Pasien B → Tidak sakit
Pasien C → Sakit
Kita perlu membandingkan prediksi tersebut dengan kondisi sebenarnya.
Prediksi Model
      ↓
Dibandingkan
      ↓
Nilai Sebenarnya
      ↓
Evaluation Metric
      ↓
Performance Model
Hasil evaluasi kemudian dapat digunakan untuk menentukan apakah model sudah cukup baik.
Mengapa Evaluation Penting?
Tanpa evaluasi, kita tidak dapat menjawab pertanyaan:
"Apakah model ini bagus?"
Misalnya dua model menghasilkan:
Model A → Accuracy 85%
Model B → Accuracy 92%
Berdasarkan accuracy, Model B terlihat lebih baik.
Tetapi kita masih perlu bertanya:
- Apakah accuracy merupakan metric yang tepat?
- Apakah dataset seimbang?
- Kesalahan apa yang dibuat model?
- Apakah false positive lebih berbahaya?
- Apakah false negative lebih berbahaya?
- Apakah model memenuhi kebutuhan bisnis?
Jadi evaluasi bukan hanya tentang mencari angka paling tinggi.
Kita harus menggunakan metric yang sesuai dengan masalah.
Evaluation Harus Didefinisikan Sejak Awal
Salah satu tujuan utama tahap Evaluation adalah menentukan standar keberhasilan sebelum model dibuat.
Misalnya sebuah tim ingin membuat model untuk mendeteksi penyakit.
Mereka dapat menetapkan:
Target:
Recall >= 95%
Atau untuk masalah lain:
Target:
Accuracy >= 90%
Dengan adanya target, tim memiliki standar yang jelas.
Problem
   ↓
Evaluation Target
   ↓
Model
   ↓
Evaluation
   ↓
Apakah target tercapai?
Hal ini juga membantu anggota tim memiliki pemahaman yang sama mengenai tujuan proyek.
Evaluation Metric dan Business Goal
Metric Machine Learning sebaiknya berhubungan dengan tujuan nyata dari proyek.
Misalnya perusahaan ingin mengurangi email spam.
Tidak cukup hanya mengatakan:
Buat model spam detection.
Kita perlu menentukan:
Seberapa baik model harus bekerja?
Misalnya:
Accuracy >= 95%
Namun target tersebut harus dipilih berdasarkan kebutuhan sistem.
Untuk beberapa kasus, precision mungkin lebih penting.
Untuk kasus lain, recall mungkin lebih penting.
Karena itu:
Metric harus mengikuti tujuan masalah, bukan sebaliknya.
Evaluation pada Classification
Classification digunakan ketika model memprediksi kategori.
Contoh:
Spam / Bukan Spam
Sakit / Tidak Sakit
Lulus / Tidak Lulus
Kucing / Anjing
Untuk classification, beberapa metric yang umum digunakan adalah:
- Accuracy
- Precision
- Recall
- F1 Score
- ROC-AUC
Pada materi ini kita akan terlebih dahulu memahami Accuracy, Precision, dan Recall.
Confusion Matrix
Sebelum memahami Accuracy, Precision, dan Recall, kita perlu mengenal Confusion Matrix.
Confusion Matrix digunakan untuk melihat jenis prediksi yang benar dan salah.
Pada binary classification, terdapat empat kemungkinan:
                    Kondisi Sebenarnya:
                  Positive       Negative

Prediksi:
Positive          TP             FP

Negative          FN             TN
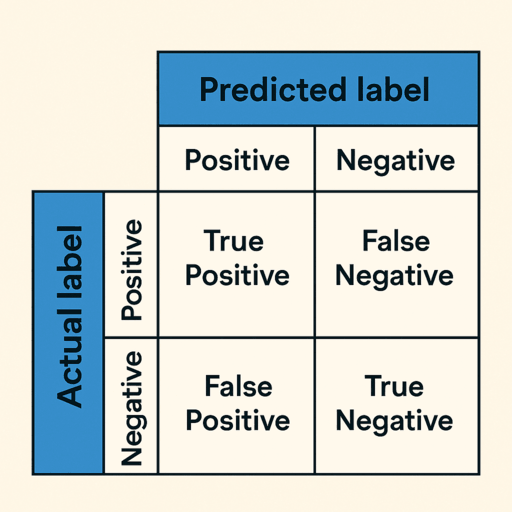
Keempat komponen tersebut adalah:
- TP - True Positive
- TN - True Negative
- FP - False Positive
- FN - False Negative
True Positive
True Positive terjadi ketika model memprediksi positif dan kondisi sebenarnya juga positif.
Contoh:
Model:
Pasien → Sakit

Kondisi sebenarnya:
Pasien → Sakit
Prediksi benar.
Maka:
True Positive
True Negative
True Negative terjadi ketika model memprediksi negatif dan kondisi sebenarnya juga negatif.
Contoh:
Model:
Pasien → Tidak sakit

Kondisi sebenarnya:
Pasien → Tidak sakit
Prediksi benar.
Maka:
True Negative
False Positive
False Positive terjadi ketika model memprediksi positif, tetapi kondisi sebenarnya negatif.
Contoh:
Model:
Pasien → Sakit

Kondisi sebenarnya:
Pasien → Tidak sakit
Model memberikan peringatan yang sebenarnya tidak diperlukan.
Maka:
False Positive
False Positive sering juga disebut false alarm.
False Negative
False Negative terjadi ketika model memprediksi negatif, tetapi kondisi sebenarnya positif.
Contoh:
Model:
Pasien → Tidak sakit

Kondisi sebenarnya:
Pasien → Sakit
Model gagal mendeteksi kondisi positif.
Maka:
False Negative
Pada beberapa kasus, False Negative dapat menjadi kesalahan yang sangat serius.
Misalnya pada sistem deteksi penyakit.
Accuracy
Accuracy mengukur proporsi seluruh prediksi yang benar dibandingkan dengan seluruh prediksi.
Rumus:
Accuracy =
(TP + TN)
----------------
(TP + TN + FP + FN)
Dengan kata lain:
Jumlah prediksi benar
---------------------
Jumlah seluruh prediksi
Contoh Accuracy
Misalnya terdapat 100 data.
Model menghasilkan:
True Positive  = 40
True Negative  = 50
False Positive = 5
False Negative = 5
Maka:
Accuracy =
(40 + 50) / 100

= 0.90

= 90%
Jadi accuracy model adalah:
90%
Accuracy dengan Scikit-learn
Dalam Python kita dapat menggunakan:
from sklearn.metrics import accuracy_score

accuracy = accuracy_score(
    y_test,
    y_pred
)

print("Accuracy:", accuracy)
Jika ingin menampilkan dalam persen:
print(f"Accuracy: {accuracy:.2%}")
Contoh output:
Accuracy: 90.00%
Precision
Precision menjawab pertanyaan:
"Dari semua data yang diprediksi positif oleh model, berapa banyak yang benar-benar positif?"
Rumus:
Precision =
TP
-----------
TP + FP
Precision berfokus pada kualitas prediksi positif.
Contoh Precision
Misalnya model mengatakan:
20 pasien → positif
Setelah diperiksa:
18 benar-benar positif
2 ternyata negatif
Maka:
TP = 18
FP = 2
Precision:
Precision =
18 / (18 + 2)

= 0.90

= 90%
Artinya:
Dari seluruh pasien yang diprediksi positif, 90% memang benar-benar positif.
Precision dengan Scikit-learn
from sklearn.metrics import precision_score

precision = precision_score(
    y_test,
    y_pred
)

print(f"Precision: {precision:.2%}")
Recall
Recall menjawab pertanyaan:
"Dari semua data yang sebenarnya positif, berapa banyak yang berhasil ditemukan oleh model?"
Rumus:
Recall =
TP
-----------
TP + FN
Recall berfokus pada kemampuan model menemukan seluruh kasus positif.
Contoh Recall
Misalnya terdapat:
100 pasien yang sebenarnya sakit
Model berhasil menemukan:
95 pasien
Tetapi:
5 pasien tidak terdeteksi
Maka:
TP = 95
FN = 5
Recall:
Recall =
95 / (95 + 5)

= 0.95

= 95%
Artinya:
Model berhasil menemukan 95% dari seluruh pasien yang sebenarnya positif.
Recall dengan Scikit-learn
from sklearn.metrics import recall_score

recall = recall_score(
    y_test,
    y_pred
)

print(f"Recall: {recall:.2%}")
Precision vs Recall
Precision dan Recall sering membingungkan bagi pemula.
Cara sederhana memahaminya:
Precision
Fokus pada:
Prediksi positif model dapat dipercaya atau tidak?
Semua yang diprediksi positif
             ↓
       Berapa yang benar?
Recall
Fokus pada:
Berapa banyak kasus positif yang berhasil ditemukan?
Semua yang sebenarnya positif
             ↓
       Berapa yang ditemukan?
Contoh Sederhana
Bayangkan kita memiliki sistem pendeteksi pencuri.
Model mengatakan:
10 orang → terdeteksi sebagai pencuri
Ternyata:
8 memang pencuri
2 bukan pencuri
Precision:
8 / 10 = 80%
Sekarang bayangkan sebenarnya terdapat:
20 pencuri
Model hanya berhasil menemukan:
8 pencuri
Recall:
8 / 20 = 40%
Jadi model memiliki:
Precision = 80%
Recall    = 40%
Model cukup akurat ketika mengatakan seseorang pencuri, tetapi masih gagal menemukan banyak pencuri.
Memilih Accuracy, Precision, atau Recall
Tidak ada satu metric yang selalu paling baik.
Pemilihan metric bergantung pada masalah.
Accuracy Cocok Ketika
Accuracy dapat berguna ketika:
- kelas relatif seimbang,
- biaya kesalahan relatif mirip,
- kita ingin mengetahui proporsi prediksi yang benar secara keseluruhan.
Contoh sederhana:
Kucing vs Anjing
Jika jumlah data relatif seimbang, accuracy dapat menjadi metric yang berguna.
Precision Penting Ketika False Positive Mahal
Precision menjadi penting ketika kita ingin mengurangi prediksi positif yang salah.
Contohnya:
Sistem rekomendasi tindakan tertentu
atau sistem yang memberikan peringatan dan kita ingin mengurangi false alarm.
Recall Penting Ketika False Negative Mahal
Recall menjadi penting ketika kita ingin menemukan sebanyak mungkin kasus positif.
Contohnya:
Deteksi penyakit
Deteksi fraud
Deteksi ancaman keamanan
Jika kita terlalu banyak menghasilkan False Negative, kasus penting dapat terlewat.
Evaluation pada Regression
Regression digunakan ketika model memprediksi nilai numerik.
Contoh:
Harga rumah
Harga mobil
Suhu
Penjualan
Pendapatan
Berbeda dengan classification, regression tidak menggunakan Accuracy sebagai metric utama.
Kita ingin mengetahui:
Seberapa dekat prediksi model dengan nilai sebenarnya?
Misalnya:
Harga sebenarnya = 500 juta
Prediksi model    = 480 juta
Error:
20 juta
Mean Absolute Error
Mean Absolute Error (MAE) menghitung rata-rata nilai absolut dari selisih antara prediksi dan nilai sebenarnya.
Rumus sederhananya:
MAE =
Σ |nilai_sebenarnya - prediksi|
--------------------------------
            n
Semakin kecil MAE, semakin dekat prediksi model dengan nilai sebenarnya.
Contoh MAE
Misalnya kita memiliki:
Actual:
[100, 200, 300]

Prediction:
[110, 180, 290]
Error absolut:
|100 - 110| = 10
|200 - 180| = 20
|300 - 290| = 10
MAE:
(10 + 20 + 10) / 3

= 13.33
Jadi:
MAE = 13.33
MAE dengan Scikit-learn
from sklearn.metrics import mean_absolute_error

mae = mean_absolute_error(
    y_test,
    y_pred
)

print("MAE:", mae)
Jika target berupa harga dalam rupiah, nilai MAE juga akan berada pada satuan yang sama.
Misalnya:
MAE = 25.000.000
Artinya secara rata-rata prediksi model memiliki selisih absolut sekitar:
Rp25.000.000
dari nilai sebenarnya.
Mean Squared Error
Mean Squared Error (MSE) menghitung rata-rata kuadrat error.
Rumus:
MSE =
Σ (nilai_sebenarnya - prediksi)²
---------------------------------
              n
Karena error dikuadratkan, error yang besar akan mendapatkan penalti yang lebih besar.
Contoh MSE
Menggunakan data sebelumnya:
Actual:
[100, 200, 300]

Prediction:
[110, 180, 290]
Error:
10
-20
10
Kuadrat error:
100
400
100
MSE:
(100 + 400 + 100) / 3

= 200
Jadi:
MSE = 200
MSE dengan Scikit-learn
from sklearn.metrics import mean_squared_error

mse = mean_squared_error(
    y_test,
    y_pred
)

print("MSE:", mse)
MAE vs MSE
Perbedaannya:
| MAE | MSE |
|---|---|
| Menggunakan nilai absolut | Menggunakan kuadrat error |
| Lebih mudah diinterpretasikan | Lebih sensitif terhadap error besar |
| Berada pada satuan target | Satuannya menjadi kuadrat |
| Cocok untuk melihat rata-rata error | Berguna ketika error besar perlu diberi penalti lebih kuat |
Secara sederhana:
MAE
→ Seberapa jauh rata-rata prediksi dari nilai sebenarnya?

MSE
→ Memberikan penalti lebih besar terhadap error yang besar.
Evaluation pada Recommendation System
Evaluation pada Recommendation System memiliki karakteristik yang berbeda.
Bayangkan sebuah marketplace memiliki:
10.000 produk
Kemudian sistem hanya menampilkan:
Top 10 rekomendasi
Kita tidak hanya bertanya:
"Apakah model benar?"
Tetapi:
"Seberapa relevan rekomendasi yang berada di posisi teratas?"
Precision at K
Salah satu metric yang dapat digunakan adalah Precision at K.
Misalnya:
K = 10
Artinya kita mengevaluasi:
10 rekomendasi teratas
Misalnya dari 10 rekomendasi:
7 relevan
3 tidak relevan
Maka:
Precision@10 = 7 / 10

= 70%
Semakin tinggi nilai tersebut, semakin banyak rekomendasi teratas yang relevan.
Studi Kasus: Klaim Asuransi Mobil
Sekarang kita gunakan contoh yang lebih nyata.
Sebuah perusahaan asuransi ingin membuat sistem Machine Learning untuk membantu menentukan pihak yang dianggap bertanggung jawab dalam sebuah kecelakaan berdasarkan teks klaim.
Input:
Teks klaim asuransi
Target:
Pihak A
atau
Pihak B
Karena target berupa kategori, masalah tersebut merupakan:
Supervised Learning
        ↓
Classification
Menentukan Target Keberhasilan
Perusahaan menetapkan:
Accuracy minimal = 95%
Artinya model harus memiliki accuracy setidaknya:
95%
Jika terdapat 20 klaim:
20 klaim
 ↓
maksimal sekitar 1 prediksi salah
Karena:
19 / 20 = 95%
Target tersebut memberikan standar yang jelas bagi tim.
Mengapa Target Harus Ditetapkan?
Bayangkan tim Machine Learning menghasilkan model:
Model A → Accuracy 87%
Tanpa target, seseorang mungkin mengatakan:
"87% sudah cukup bagus."
Tetapi jika target proyek adalah:
95%
maka:
87% < 95%
Artinya model belum memenuhi kriteria yang ditentukan.
Tim perlu melakukan eksperimen lebih lanjut.
Evaluation Bukan Hanya Satu Angka
Walaupun kita memiliki target:
Accuracy >= 95%
kita sebaiknya tidak berhenti pada satu angka.
Misalnya:
Accuracy  = 96%
Precision = 91%
Recall    = 84%
Model memiliki accuracy tinggi, tetapi recall relatif rendah.
Hal tersebut mungkin penting jika False Negative memiliki dampak besar.
Karena itu, kita perlu memahami konteks masalah.
Evaluation pada Data yang Belum Pernah Dilihat Model
Salah satu prinsip penting dalam evaluasi Machine Learning adalah model harus diuji pada data yang belum digunakan untuk training.
Misalnya:
Dataset
   ↓
Training Data
Test Data
Model belajar menggunakan:
Training Data
Kemudian performanya diuji menggunakan:
Test Data
Tujuannya adalah mengetahui bagaimana model bekerja pada data baru.
Mengapa Tidak Mengevaluasi pada Training Data?
Misalnya model mendapatkan:
Training Accuracy = 99%
Apakah berarti model sangat bagus?
Belum tentu.
Model mungkin terlalu menyesuaikan diri dengan training data.
Kita ingin mengetahui apakah model dapat melakukan generalisasi terhadap data yang belum pernah dilihat.
Karena itu kita menggunakan test set.
Contoh Evaluation dengan Classification
Berikut contoh sederhana menggunakan dataset Iris.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import (
    accuracy_score,
    precision_score,
    recall_score
)

# Load data
data = load_iris()

X = data.data
y = data.target

# Split data
X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42,
    stratify=y
)

# Create model
model = RandomForestClassifier(
    random_state=42
)

# Training
model.fit(X_train, y_train)

# Prediction
y_pred = model.predict(X_test)

# Evaluation
accuracy = accuracy_score(y_test, y_pred)

precision = precision_score(
    y_test,
    y_pred,
    average="weighted"
)

recall = recall_score(
    y_test,
    y_pred,
    average="weighted"
)

print(f"Accuracy : {accuracy:.2%}")
print(f"Precision: {precision:.2%}")
print(f"Recall   : {recall:.2%}")
Pada dataset multiclass seperti Iris, kita perlu memilih strategi averaging untuk metric seperti precision dan recall.
Classification Report
Scikit-learn juga menyediakan classification_report untuk melihat beberapa metric sekaligus.
from sklearn.metrics import classification_report

print(
    classification_report(
        y_test,
        y_pred
    )
)
Output akan memberikan informasi seperti:
precision
recall
f1-score
support
untuk masing-masing kelas.
Ini sangat berguna ketika kita ingin melakukan analisis classification yang lebih lengkap.
Contoh Evaluation dengan Regression
Contoh sederhana:
from sklearn.datasets import load_diabetes
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import (
    mean_absolute_error,
    mean_squared_error,
    r2_score
)

# Load data
data = load_diabetes()

X = data.data
y = data.target

# Split data
X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42
)

# Create model
model = LinearRegression()

# Training
model.fit(X_train, y_train)

# Prediction
y_pred = model.predict(X_test)

# Evaluation
mae = mean_absolute_error(
    y_test,
    y_pred
)

mse = mean_squared_error(
    y_test,
    y_pred
)

r2 = r2_score(
    y_test,
    y_pred
)

print("MAE:", mae)
print("MSE:", mse)
print("R²:", r2)
Dari contoh tersebut kita dapat melihat bahwa regression menggunakan metric yang berbeda dari classification.
Metric Evaluation Harus Bisa Berubah
Menentukan metric di awal sangat penting, tetapi bukan berarti metric tersebut tidak boleh berubah.
Ketika proyek berkembang, kita mungkin menemukan:
- karakteristik data baru,
- kebutuhan bisnis baru,
- distribusi kelas yang berbeda,
- risiko kesalahan tertentu,
- atau masalah pada metric awal.
Misalnya awalnya kita menggunakan:
Accuracy
Kemudian setelah memahami data lebih dalam, ternyata dataset sangat tidak seimbang.
Kita mungkin perlu menambahkan:
Precision
Recall
F1 Score
Dengan demikian proses evaluasi dapat diperbaiki seiring pemahaman kita terhadap masalah.
Evaluation sebagai Target Bersama Tim
Dalam proyek Machine Learning yang melibatkan banyak orang, metric juga berfungsi sebagai bahasa bersama.
Misalnya:
Data Scientist
→ Recall >= 95%

Machine Learning Engineer
→ Model harus memenuhi target tersebut

Product Team
→ Menentukan kebutuhan bisnis

Stakeholder
→ Mengetahui standar keberhasilan
Semua pihak memiliki referensi yang sama.
Tanpa target yang jelas, setiap orang dapat memiliki definisi "model bagus" yang berbeda.
Kesalahan Umum dalam Evaluation
Hanya Menggunakan Accuracy
Accuracy tidak selalu cukup.
Terutama ketika dataset tidak seimbang.
Contoh:
9.900 data negatif
100 data positif
Jika model selalu memprediksi:
Negatif
maka accuracy:
9.900 / 10.000
= 99%
Terlihat sangat bagus.
Padahal model gagal menemukan:
100 kasus positif
Dalam situasi seperti ini, accuracy dapat memberikan gambaran yang menyesatkan.
Menggunakan Metric yang Tidak Sesuai
Misalnya kita ingin memprediksi harga rumah.
Menggunakan:
Accuracy
tidak tepat karena target berupa angka kontinu.
Metric seperti:
MAE
MSE
RMSE
R²
lebih sesuai.
Mengevaluasi Model Menggunakan Data Training
Jika kita hanya mengukur performa pada training data, hasilnya bisa terlalu optimistis.
Gunakan data yang tidak digunakan dalam training untuk mengukur kemampuan generalisasi.
Mengejar Angka Tanpa Memahami Masalah
Misalnya:
Accuracy = 99%
Tidak berarti otomatis model siap digunakan.
Kita tetap harus bertanya:
- Bagaimana data diperoleh?
- Apakah terdapat data leakage?
- Apakah test set representatif?
- Apakah metric sesuai?
- Apa konsekuensi kesalahan?
- Apakah model stabil pada data baru?
Evaluation harus dilihat dalam konteks keseluruhan proyek.
Checklist Evaluation
Sebelum masuk ke tahap modelling, pastikan kita sudah mengetahui:
□ Apa definisi keberhasilan proyek?
□ Metric apa yang digunakan?
□ Mengapa metric tersebut dipilih?
□ Berapa target minimum?
□ Apa konsekuensi False Positive?
□ Apa konsekuensi False Negative?
□ Apakah dataset seimbang?
□ Bagaimana model akan diuji?
□ Apakah test data terpisah dari training?
□ Apakah metric dapat berubah setelah memahami data lebih jauh?
Checklist ini membantu memastikan bahwa proses Machine Learning memiliki tujuan yang jelas.
Ringkasan
Evaluation adalah tahap untuk menentukan bagaimana kita mengukur keberhasilan model Machine Learning.
Pertanyaan utamanya:
"What defines success for us?"
Beberapa metric berdasarkan jenis masalah:
Classification
├── Accuracy
├── Precision
├── Recall
├── F1 Score
└── ROC-AUC

Regression
├── MAE
├── MSE
├── RMSE
└── R²

Recommendation System
└── Precision@K
Untuk classification:
Accuracy
→ Seberapa banyak prediksi yang benar secara keseluruhan?

Precision
→ Dari prediksi positif, berapa banyak yang benar?

Recall
→ Dari seluruh kasus positif, berapa banyak yang berhasil ditemukan?
Untuk regression:
MAE
→ Rata-rata besar kesalahan absolut.

MSE
→ Rata-rata kuadrat kesalahan.
Hal terpenting:
Tidak ada satu metric yang selalu terbaik untuk semua masalah.
Metric harus dipilih berdasarkan:
- jenis masalah,
- karakteristik data,
- tujuan proyek,
- dan konsekuensi kesalahan.
Menentukan metric sejak awal membantu tim memiliki target yang sama. Namun metric tetap dapat disesuaikan ketika kita semakin memahami data dan kebutuhan proyek.
Setelah kita mengetahui bagaimana keberhasilan model akan diukur, langkah berikutnya adalah memahami features yang tersedia dalam dataset dan menentukan informasi apa yang akan digunakan model untuk membuat prediksi.