Tools Machine Learning
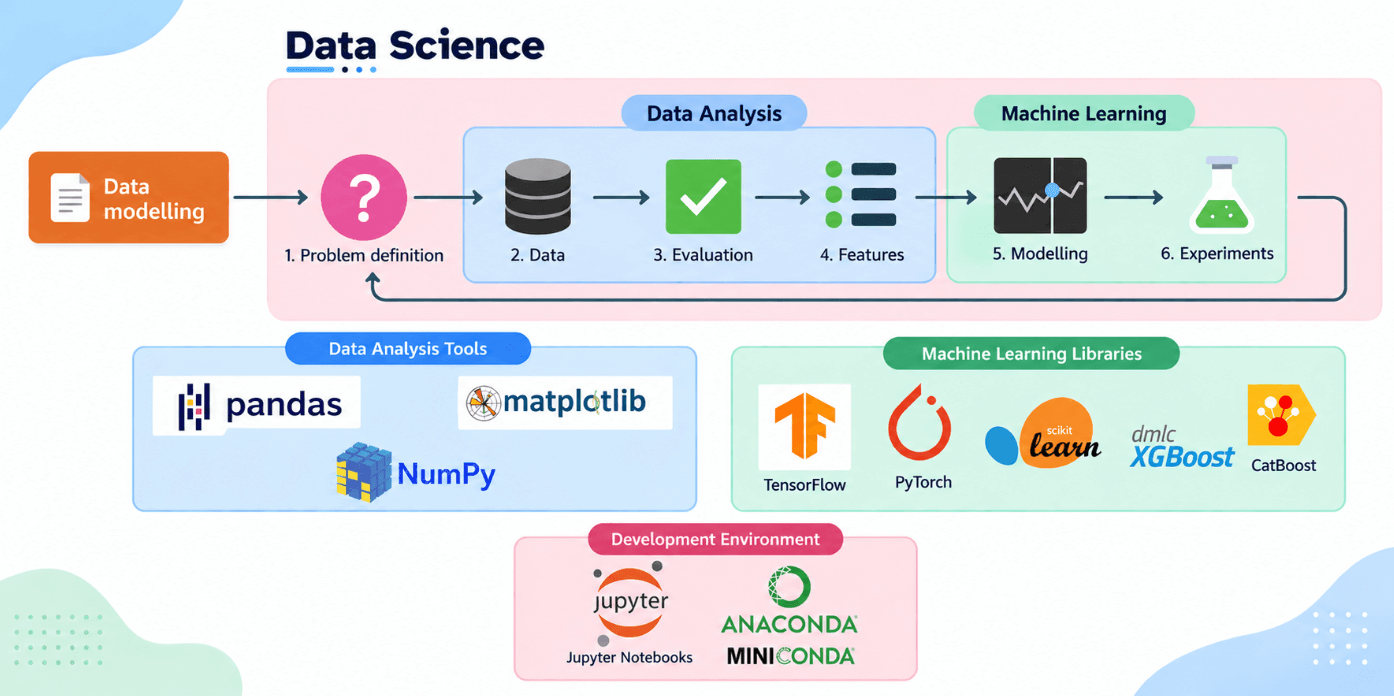
Pengenalan Tools dalam Data Science dan Machine Learning
Setelah memahami framework Machine Learning, kita perlu mengenal berbagai tools yang digunakan untuk mengimplementasikan setiap tahapnya.
Salah satu kesalahan umum ketika mulai belajar Data Science dan Machine Learning adalah mencoba menghafalkan terlalu banyak library sekaligus.
Padahal yang lebih penting adalah memahami:
Masalah apa yang sedang diselesaikan?
        ↓
Data seperti apa yang digunakan?
        ↓
Proses apa yang diperlukan?
        ↓
Tool apa yang sesuai?
Dengan pola pikir tersebut, kita tidak perlu menghafalkan seluruh fungsi dari setiap library.
Kita cukup memahami:
Tool
 ↓
Kegunaan
 ↓
Kapan digunakan
 ↓
Cara mencari dokumentasi
Gambaran Besar Tool dalam Machine Learning
Ekosistem Python untuk Data Science dan Machine Learning terdiri dari banyak library.
Secara sederhana:
Python Environment
       │
       ├── Jupyter
       │
       ├── NumPy
       │
       ├── Pandas
       │
       ├── Matplotlib
       │
       ├── Seaborn
       │
       ├── Scikit-Learn
       │
       ├── XGBoost
       │
       ├── CatBoost
       │
       ├── TensorFlow
       │
       └── PyTorch
Masing-masing memiliki fungsi yang berbeda.
Tidak semua library harus digunakan dalam setiap proyek.
Environment sebagai Workbench
Sebelum menggunakan berbagai tools tersebut, kita membutuhkan sebuah environment.
Environment dapat dianalogikan sebagai tempat kerja atau workshop.
Workshop
   ↓
Tools
   ↓
Materials
   ↓
Project
Dalam Machine Learning:
Environment
   ↓
Python
   ↓
Libraries
   ↓
Dataset
   ↓
Notebook / Code
   ↓
Machine Learning Project
Environment membantu memastikan library dan dependency yang dibutuhkan proyek tersedia dan terisolasi dengan baik.
Anaconda
Anaconda merupakan salah satu distribution dan environment management ecosystem yang populer untuk Data Science.
Anaconda menyediakan berbagai package dan tools yang dapat membantu menyiapkan lingkungan Python untuk:
- Data Science
- Scientific Computing
- Machine Learning
- Jupyter
- Analisis data
Namun perlu dipahami bahwa Anaconda bukan library Machine Learning.
Anaconda lebih tepat dipahami sebagai bagian dari ekosistem untuk mengelola environment dan package.
Contohnya:
Anaconda / Conda
    ↓
Environment
    ↓
Python
    ↓
Pandas
NumPy
Scikit-Learn
Jupyter
Mengapa Environment Penting?
Bayangkan kita memiliki dua proyek.
Project A
Python 3.x
Pandas versi tertentu
Scikit-Learn versi tertentu

Project B
Python 3.x
Pandas versi berbeda
Scikit-Learn versi berbeda
Jika semuanya dipasang dalam satu environment, dependency antar-project dapat saling bertabrakan.
Karena itu, environment yang terpisah sering lebih aman.
Contohnya:
Environment
├── project-ml
├── project-fastapi
└── project-deep-learning
Setiap environment dapat memiliki dependency yang sesuai dengan project masing-masing.
Membuat Environment dengan Conda
Contoh:
conda create -n ml-env python=3.12
Aktifkan:
conda activate ml-env
Kemudian install library:
conda install numpy pandas matplotlib seaborn scikit-learn jupyter
Atau package tertentu dapat dipasang menggunakan pip sesuai kebutuhan.
pip install xgboost catboost
Jupyter Notebook
Jupyter Notebook merupakan salah satu environment yang sangat populer untuk eksperimen Data Science dan Machine Learning.
Notebook memungkinkan kita menggabungkan:
Code
+
Output
+
Visualization
+
Explanation
+
Documentation
Dalam satu file.
Contohnya:
Markdown
   ↓
Menjelaskan dataset

Code
   ↓
Membaca dataset

Output
   ↓
Menampilkan data

Visualization
   ↓
Melihat pola

Markdown
   ↓
Menjelaskan kesimpulan
Mengapa Jupyter Penting dalam Machine Learning?
Machine Learning merupakan proses yang sangat eksperimental.
Kita sering perlu mencoba:
Model A
Model B
Model C
Kemudian membandingkan:
Accuracy
Training Time
Prediction
Visualization
Jupyter sangat cocok untuk workflow seperti ini.
Notebook sebagai Dokumentasi Eksperimen
Notebook tidak hanya berfungsi sebagai tempat menulis kode.
Notebook juga dapat menjadi dokumentasi.
Contohnya:
## 1. Import Library

Code

## 2. Load Dataset

Code

## 3. Exploratory Data Analysis

Code + Visualization

## 4. Preprocessing

Code

## 5. Modelling

Code

## 6. Evaluation

Code + Result

## 7. Conclusion

Explanation
Karena itu, notebook juga dapat menjadi bagian dari portfolio Machine Learning.
NumPy
NumPy merupakan library fundamental untuk numerical computing di Python.
NumPy menyediakan struktur data utama berupa array multidimensi dan berbagai operasi numerik.
Contoh:
import numpy as np

numbers = np.array([
    10,
    20,
    30,
    40
])

print(numbers)
Output:
[10 20 30 40]
Kegunaan NumPy
NumPy banyak digunakan untuk:
- numerical computation
- array operations
- matrix operations
- mathematical operations
- statistik dasar
- manipulasi data numerik
Contoh:
numbers.mean()
Hasil:
25.0
NumPy dalam Machine Learning
Machine Learning pada akhirnya banyak bekerja dengan data numerik.
Misalnya:
Dataset
   ↓
Features
   ↓
Numerical Representation
   ↓
Array / Matrix
   ↓
Model
NumPy menjadi salah satu fondasi penting yang digunakan oleh banyak library scientific computing dan Machine Learning.
Pandas
Pandas digunakan terutama untuk mengolah dan menganalisis data tabular.
Contoh data:
Age | Income | Purchase
----|--------|---------
25  | 5000   | Yes
31  | 8000   | Yes
22  | 3000   | No
Data seperti ini sangat umum dalam proyek Machine Learning.
Membaca Dataset dengan Pandas
Contoh:
import pandas as pd

df = pd.read_csv(
    "dataset.csv"
)

df.head()
DataFrame merupakan struktur data utama yang digunakan Pandas untuk data tabular.
Kegunaan Pandas
Pandas dapat digunakan untuk:
Load Data
    ↓
Explore Data
    ↓
Clean Data
    ↓
Transform Data
    ↓
Prepare Features
    ↓
Prepare Target
Contoh:
df.info()
Melihat statistik:
df.describe()
Memeriksa missing value:
df.isna().sum()
Memeriksa jumlah baris:
len(df)
Matplotlib
Matplotlib merupakan library visualisasi yang sangat umum digunakan dalam Python.
Contohnya:
import matplotlib.pyplot as plt

plt.hist(
    df["age"]
)

plt.xlabel("Age")
plt.ylabel("Frequency")

plt.show()
Visualisasi membantu kita memahami data sebelum membuat model.
Seaborn
Seaborn dibangun di atas Matplotlib dan menyediakan API visualisasi statistik yang lebih tinggi levelnya.
Contohnya:
import seaborn as sns

sns.histplot(
    data=df,
    x="age"
)
Seaborn sering digunakan untuk membuat:
- distribution plot
- box plot
- scatter plot
- heatmap
- categorical plot
Mengapa Visualisasi Penting?
Machine Learning bukan hanya tentang menjalankan algoritma.
Kita harus memahami data.
Misalnya terdapat hubungan:
Age
 ↓
Income
 ↓
Purchase
Visualisasi dapat membantu menemukan:
- outlier
- distribusi
- korelasi
- pola
- kelompok data
- ketidakseimbangan kelas
Contoh sederhana:
Data
 ↓
Visualization
 ↓
Understanding
 ↓
Feature Engineering
 ↓
Model
Pemetaan Tools ke Framework
Sekarang kita dapat memetakan tools ke enam langkah framework.
1. Problem Definition
2. Data
3. Evaluation
4. Features
5. Modelling
6. Experimentation
Tools tidak selalu hanya digunakan pada satu langkah.
Satu library dapat digunakan pada beberapa tahap.
Framework Step 1 - Problem Definition
Pertanyaan:
Masalah apa yang ingin kita selesaikan?
Pada tahap ini, tools teknis belum menjadi fokus utama.
Yang lebih penting adalah:
Business Problem
       ↓
Machine Learning Problem
       ↓
Problem Type
       ↓
Target
       ↓
Success Criteria
Contohnya:
Masalah:
Pelanggan berhenti berlangganan.

ML Problem:
Classification.

Target:
Churn / Tidak Churn.
Tools digunakan setelah problem sudah jelas.
Framework Step 2 - Data
Pertanyaan:
Data apa yang kita miliki?
Tools yang umum digunakan:
Pandas
NumPy
Matplotlib
Seaborn
Workflow:
Dataset
   ↓
Pandas
   ↓
DataFrame
   ↓
Exploration
   ↓
Visualization
Contohnya:
df = pd.read_csv(
    "customers.csv"
)

df.head()
Framework Step 3 - Evaluation
Pertanyaan:
Apa yang mendefinisikan keberhasilan?
Scikit-Learn banyak menyediakan tools untuk evaluation.
Contoh classification:
from sklearn.metrics import accuracy_score

accuracy = accuracy_score(
    y_test,
    predictions
)
Contoh regression:
from sklearn.metrics import mean_absolute_error

mae = mean_absolute_error(
    y_test,
    predictions
)
Tools evaluation harus mengikuti metric yang telah ditentukan berdasarkan problem.
Framework Step 4 - Features
Pertanyaan:
Informasi apa yang kita miliki untuk membuat prediksi?
Pandas sangat banyak digunakan pada tahap ini.
Contohnya:
X = df[
    [
        "age",
        "income",
        "transactions"
    ]
]

y = df[
    "churn"
]
Kita juga dapat menggunakan Scikit-Learn untuk preprocessing.
Contohnya:
from sklearn.preprocessing import StandardScaler

scaler = StandardScaler()

X_scaled = scaler.fit_transform(
    X_train
)
Framework Step 5 - Modelling
Pertanyaan:
Model apa yang harus digunakan?
Di sinilah Scikit-Learn menjadi salah satu tools utama.
Scikit-Learn menyediakan banyak algoritma untuk:
Classification
Regression
Clustering
Dimensionality Reduction
Preprocessing
Model Selection
Evaluation
Contoh:
from sklearn.ensemble import RandomForestClassifier

model = RandomForestClassifier(
    random_state=42
)

model.fit(
    X_train,
    y_train
)
Scikit-Learn
Scikit-Learn merupakan salah satu library utama untuk classical Machine Learning menggunakan Python.
Contoh algoritma:
Linear Regression
Logistic Regression
Decision Tree
Random Forest
Support Vector Machine
K-Nearest Neighbors
Naive Bayes
Gradient Boosting
K-Means
Scikit-Learn juga menyediakan utilities untuk:
Train/Test Split
Cross-Validation
Hyperparameter Tuning
Preprocessing
Pipeline
Metrics
XGBoost
XGBoost adalah library untuk gradient boosting yang banyak digunakan terutama pada structured/tabular data.
Contohnya:
from xgboost import XGBClassifier

model = XGBClassifier(
    random_state=42
)

model.fit(
    X_train,
    y_train
)
XGBoost sering digunakan ketika kita ingin mengeksplorasi model boosting dengan performa tinggi pada data tabular.
CatBoost
CatBoost juga merupakan library gradient boosting.
Salah satu karakteristik yang membuat CatBoost menarik adalah dukungannya terhadap categorical features dalam workflow tertentu.
Contoh:
from catboost import CatBoostClassifier

model = CatBoostClassifier(
    verbose=False,
    random_seed=42
)

model.fit(
    X_train,
    y_train
)
CatBoost dapat menjadi salah satu kandidat ketika bekerja dengan structured data yang memiliki banyak categorical features.
TensorFlow
TensorFlow merupakan framework untuk Machine Learning dan terutama Deep Learning.
Contohnya:
Image
   ↓
Neural Network
   ↓
Training
   ↓
Prediction
TensorFlow dapat digunakan untuk membangun dan melatih berbagai jenis neural network.
PyTorch
PyTorch juga merupakan framework Deep Learning yang banyak digunakan untuk:
- computer vision
- natural language processing
- generative AI
- research
- production Machine Learning
Workflow sederhananya:
Dataset
   ↓
Tensor
   ↓
Neural Network
   ↓
Training
   ↓
Evaluation
   ↓
Prediction
Classical Machine Learning vs Deep Learning
Secara umum:
| Kebutuhan | Tools yang Umum |
|---|---|
| Tabular Data | Pandas |
| Numerical Computing | NumPy |
| Visualization | Matplotlib |
| Statistical Visualization | Seaborn |
| Classical ML | Scikit-Learn |
| Gradient Boosting | XGBoost |
| Gradient Boosting | CatBoost |
| Deep Learning | TensorFlow |
| Deep Learning | PyTorch |
Pemilihan tools tetap harus disesuaikan dengan problem.
Pemetaan Tools secara Keseluruhan
Berikut gambaran sederhananya:
                    Machine Learning Framework

┌─────────────────────────────────────────────────────┐
│ 1. Problem Definition                               │
│                                                     │
│ Fokus: memahami masalah                             │
└─────────────────────────────────────────────────────┘
                       ↓
┌─────────────────────────────────────────────────────┐
│ 2. Data                                             │
│                                                     │
│ Pandas + NumPy + Matplotlib + Seaborn               │
└─────────────────────────────────────────────────────┘
                       ↓
┌─────────────────────────────────────────────────────┐
│ 3. Evaluation                                       │
│                                                     │
│ Scikit-Learn Metrics                                │
└─────────────────────────────────────────────────────┘
                       ↓
┌─────────────────────────────────────────────────────┐
│ 4. Features                                         │
│                                                     │
│ Pandas + NumPy + Scikit-Learn                       │
└─────────────────────────────────────────────────────┘
                       ↓
┌─────────────────────────────────────────────────────┐
│ 5. Modelling                                        │
│                                                     │
│ Scikit-Learn / XGBoost / CatBoost / TensorFlow /    │
│ PyTorch                                             │
└─────────────────────────────────────────────────────┘
                       ↓
┌─────────────────────────────────────────────────────┐
│ 6. Experimentation                                  │
│                                                     │
│ Jupyter + seluruh tools yang relevan                │
└─────────────────────────────────────────────────────┘
Jupyter sebagai Pusat Eksperimen
Jupyter dapat berada di hampir seluruh workflow.
Contohnya:
Jupyter
   │
   ├── Pandas
   │     ↓
   │   Data Analysis
   │
   ├── NumPy
   │     ↓
   │   Numerical Processing
   │
   ├── Matplotlib
   │     ↓
   │   Visualization
   │
   ├── Scikit-Learn
   │     ↓
   │   Machine Learning
   │
   └── Experimentation
Jupyter berfungsi sebagai tempat untuk menggabungkan berbagai tools tersebut.
Tidak Perlu Menghafal Semua Fungsi
Ketika belajar Data Science dan Machine Learning, kita akan menemukan banyak fungsi.
Contohnya Pandas saja memiliki sangat banyak method.
Tidak realistis untuk menghafal semuanya.
Yang lebih penting:
Memahami konsep
       ↓
Mengetahui library
       ↓
Mengetahui fungsi yang mungkin diperlukan
       ↓
Mencari dokumentasi
       ↓
Mencoba
       ↓
Memahami hasil
Misalnya kita lupa bagaimana menghapus missing value.
Kita tidak perlu panik.
Kita dapat mencari dokumentasi:
Pandas missing values
Kemudian mempelajari fungsi yang relevan.
Skill yang Lebih Penting daripada Hafalan
Seorang Machine Learning Practitioner sebaiknya memiliki kemampuan:
Problem Solving
      ↓
Research
      ↓
Reading Documentation
      ↓
Experimentation
      ↓
Debugging
      ↓
Evaluation
Bukan hanya:
Menghafal Syntax
Kemampuan mencari solusi menjadi sangat penting karena tools dan library terus berkembang.
Membaca Dokumentasi
Dokumentasi merupakan salah satu tool paling penting dalam software engineering dan Machine Learning.
Misalnya kita mengetahui:
Saya membutuhkan
Random Forest
Tetapi lupa parameter yang tersedia.
Kita dapat membuka dokumentasi library dan mencari:
RandomForestClassifier
Kemudian memahami:
Parameters
Methods
Attributes
Examples
Notes
Kemampuan membaca dokumentasi akan sangat membantu ketika project semakin kompleks.
Search Engine sebagai Tool
Dalam praktik sehari-hari, developer dan Machine Learning practitioner juga sering menggunakan search engine untuk mencari:
Error message
Library documentation
Example implementation
Best practice
Known issue
Contohnya ketika menemukan:
ValueError: Input contains NaN
Kita dapat mencari:
scikit-learn ValueError Input contains NaN
Kemudian membaca sumber yang relevan dan memahami penyebab error.
Stack Overflow dan Community Resources
Selain dokumentasi resmi, komunitas juga dapat membantu.
Contohnya:
Stack Overflow
GitHub Issues
Community Forums
Technical Blogs
Research Papers
Namun informasi dari komunitas harus tetap diverifikasi.
Prioritas yang baik:
Official Documentation
        ↓
Official Examples
        ↓
Source Code / Repository
        ↓
Trusted Community Discussion
Tool Selection berdasarkan Jenis Data
Kita dapat menggunakan pendekatan sederhana.
Structured / Tabular Data
CSV / Database
      ↓
Pandas
      ↓
Visualization
      ↓
Scikit-Learn
      ↓
XGBoost / CatBoost
Image
Image
  ↓
Preprocessing
  ↓
Deep Learning
  ↓
TensorFlow / PyTorch
Text
Text
 ↓
Text Processing
 ↓
NLP
 ↓
Machine Learning / Deep Learning
 ↓
Appropriate Framework
Audio
Audio
 ↓
Signal Processing
 ↓
Feature Extraction
 ↓
Deep Learning
Tools yang dipilih harus mengikuti kebutuhan problem.
Contoh Pemilihan Tools
Misalnya kita mendapatkan file:
customers.csv
Tujuan:
Memprediksi apakah pelanggan akan churn.
Workflow:
CSV
 ↓
Pandas
 ↓
Exploration
 ↓
Matplotlib / Seaborn
 ↓
Feature Engineering
 ↓
Scikit-Learn
 ↓
Random Forest
 ↓
Evaluation
 ↓
Tuning
 ↓
Comparison
Tidak diperlukan TensorFlow atau PyTorch jika problem tersebut dapat diselesaikan dengan classical Machine Learning secara efektif.
Contoh Proyek Computer Vision
Misalnya kita ingin membuat klasifikasi gambar kucing dan anjing.
Data:
Images
Workflow:
Images
   ↓
Preprocessing
   ↓
Deep Learning
   ↓
Transfer Learning
   ↓
PyTorch / TensorFlow
   ↓
Evaluation
   ↓
Deployment
Tools seperti Pandas mungkin masih berguna untuk metadata, tetapi bukan tool utama untuk memproses representasi gambar.
Tool Matching
Konsep yang perlu diingat:
Machine Learning adalah tool matching project.
Artinya kita memilih alat berdasarkan masalah.
Contohnya:
Butuh numerical computation
        ↓
NumPy

Butuh manipulasi tabel
        ↓
Pandas

Butuh visualisasi
        ↓
Matplotlib / Seaborn

Butuh classical ML
        ↓
Scikit-Learn

Butuh boosting
        ↓
XGBoost / CatBoost

Butuh Deep Learning
        ↓
TensorFlow / PyTorch
Jangan Menggunakan Semua Tools Sekaligus
Kesalahan umum adalah berpikir:
Proyek Machine Learning
        ↓
Harus menggunakan
NumPy
Pandas
Matplotlib
Seaborn
Scikit-Learn
XGBoost
CatBoost
TensorFlow
PyTorch
Tidak demikian.
Kita hanya menggunakan tools yang memang diperlukan.
Contohnya proyek sederhana:
Pandas
   +
Scikit-Learn
sudah mungkin cukup.
Proyek yang membutuhkan visualisasi:
Pandas
+
Matplotlib
+
Scikit-Learn
Sedangkan proyek Deep Learning:
NumPy
+
PyTorch
dapat menjadi kombinasi yang sesuai, tergantung workflow.
Learning Path Tools
Setelah memahami pemetaan tools, urutan belajar yang masuk akal adalah:
Python
  ↓
NumPy
  ↓
Pandas
  ↓
Matplotlib
  ↓
Seaborn
  ↓
Scikit-Learn
  ↓
XGBoost / CatBoost
  ↓
Deep Learning
  ↓
TensorFlow / PyTorch
Namun urutan tersebut dapat disesuaikan dengan tujuan belajar.
Tools dan Framework Bukan Tujuan Akhir
Perlu diingat bahwa:
Library ≠ Skill Machine Learning
Mengetahui syntax:
model.fit(...)
tidak otomatis berarti memahami Machine Learning.
Skill yang lebih penting adalah:
Problem
   ↓
Data
   ↓
Features
   ↓
Model
   ↓
Evaluation
   ↓
Experiment
   ↓
Decision
Tools hanyalah alat untuk menjalankan proses tersebut.
Workflow Belajar yang Disarankan
Ketika mempelajari library baru:
1. Pahami tujuan library
       ↓
2. Pahami konsep dasarnya
       ↓
3. Pelajari fungsi yang paling sering digunakan
       ↓
4. Buat contoh kecil
       ↓
5. Gunakan pada dataset nyata
       ↓
6. Gabungkan dengan library lain
       ↓
7. Buat project
Jangan mencoba menghafal seluruh API library sejak awal.
Contoh Mini Workflow
Berikut contoh sederhana yang menggabungkan beberapa tools.
import pandas as pd
import matplotlib.pyplot as plt

from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score
Load data:
df = pd.read_csv(
    "dataset.csv"
)
Memisahkan features dan target:
X = df.drop(
    "target",
    axis=1
)

y = df["target"]
Membagi dataset:
X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42,
    stratify=y
)
Training:
model = RandomForestClassifier(
    random_state=42
)

model.fit(
    X_train,
    y_train
)
Prediction:
predictions = model.predict(
    X_test
)
Evaluation:
accuracy = accuracy_score(
    y_test,
    predictions
)

print(
    f"Accuracy: {accuracy:.2%}"
)
Pada contoh tersebut kita sudah menggunakan beberapa bagian framework:
Pandas
   ↓
Data

Scikit-Learn
   ↓
Modelling

Scikit-Learn Metrics
   ↓
Evaluation
Peta Ekosistem Python untuk Machine Learning
Secara keseluruhan:
                     Python
                        │
              ┌─────────┴─────────┐
              ↓                   ↓
          Environment           Jupyter
              │                   │
              │                   │
       ┌──────┴──────┐            │
       ↓             ↓            │
     NumPy         Pandas         │
       │             │            │
       └──────┬──────┘            │
              ↓                   │
       Matplotlib / Seaborn       │
              │                   │
              └────────┬──────────┘
                       ↓
                 Scikit-Learn
                       │
              ┌────────┴────────┐
              ↓                 ↓
          XGBoost             CatBoost
              │                 │
              └────────┬────────┘
                       ↓
                 Deep Learning
                       │
              ┌────────┴────────┐
              ↓                 ↓
         TensorFlow          PyTorch
Diagram tersebut bukan menunjukkan dependency wajib antar-library, tetapi menggambarkan posisi umum tools dalam ekosistem pembelajaran Machine Learning.
Checklist Pengenalan Tools
Sebelum masuk ke praktik lebih lanjut, pastikan sudah memahami:
- Apa fungsi environment
- Apa kegunaan Anaconda / Conda
- Apa kegunaan Jupyter Notebook
- Apa kegunaan NumPy
- Apa kegunaan Pandas
- Apa kegunaan Matplotlib
- Apa kegunaan Seaborn
- Apa kegunaan Scikit-Learn
- Apa kegunaan XGBoost
- Apa kegunaan CatBoost
- Apa kegunaan TensorFlow
- Apa kegunaan PyTorch
- Perbedaan classical Machine Learning dan Deep Learning
- Cara memilih tools berdasarkan jenis problem
- Cara membaca dokumentasi
- Memahami bahwa tidak perlu menghafal seluruh API library
Ringkasan
Dalam Data Science dan Machine Learning, kita menggunakan banyak tools dengan fungsi yang berbeda.
Pemetaan sederhananya:
| Tool | Fungsi Utama |
|---|---|
| Conda / Anaconda | Environment dan package management |
| Jupyter | Eksperimen dan dokumentasi |
| NumPy | Numerical computing |
| Pandas | Data manipulation dan analysis |
| Matplotlib | Data visualization |
| Seaborn | Statistical visualization |
| Scikit-Learn | Classical Machine Learning |
| XGBoost | Gradient Boosting |
| CatBoost | Gradient Boosting |
| TensorFlow | Deep Learning |
| PyTorch | Deep Learning |
Hubungan dengan framework:
Problem Definition
       ↓
Memahami masalah

     Data
       ↓
Pandas + NumPy

Evaluation
       ↓
Scikit-Learn Metrics

    Features
       ↓
Pandas + NumPy + Scikit-Learn

    Modelling
       ↓
Scikit-Learn / XGBoost / CatBoost
       ↓
TensorFlow / PyTorch untuk Deep Learning

Experimentation
       ↓
Jupyter + tools yang relevan
Hal terpenting bukan menghafal seluruh fungsi library.
Yang lebih penting adalah mengetahui:
Apa masalahnya?
        ↓
Data seperti apa?
        ↓
Apa yang perlu dilakukan?
        ↓
Tool apa yang cocok?
        ↓
Bagaimana membaca dokumentasinya?
        ↓
Bagaimana menguji hasilnya?
Dengan pola pikir tersebut, kita dapat membangun kemampuan Machine Learning yang lebih fleksibel.
Tools adalah alat. Problem solving adalah skill utamanya.
Pada materi berikutnya, kita dapat mulai masuk ke praktik menyiapkan environment Python untuk Data Science dan Machine Learning, termasuk Conda/Anaconda, virtual environment, instalasi library, Jupyter Notebook, serta struktur environment yang baik untuk setiap project.